基于协同过滤的电影推荐系统设计与实现
项目简介
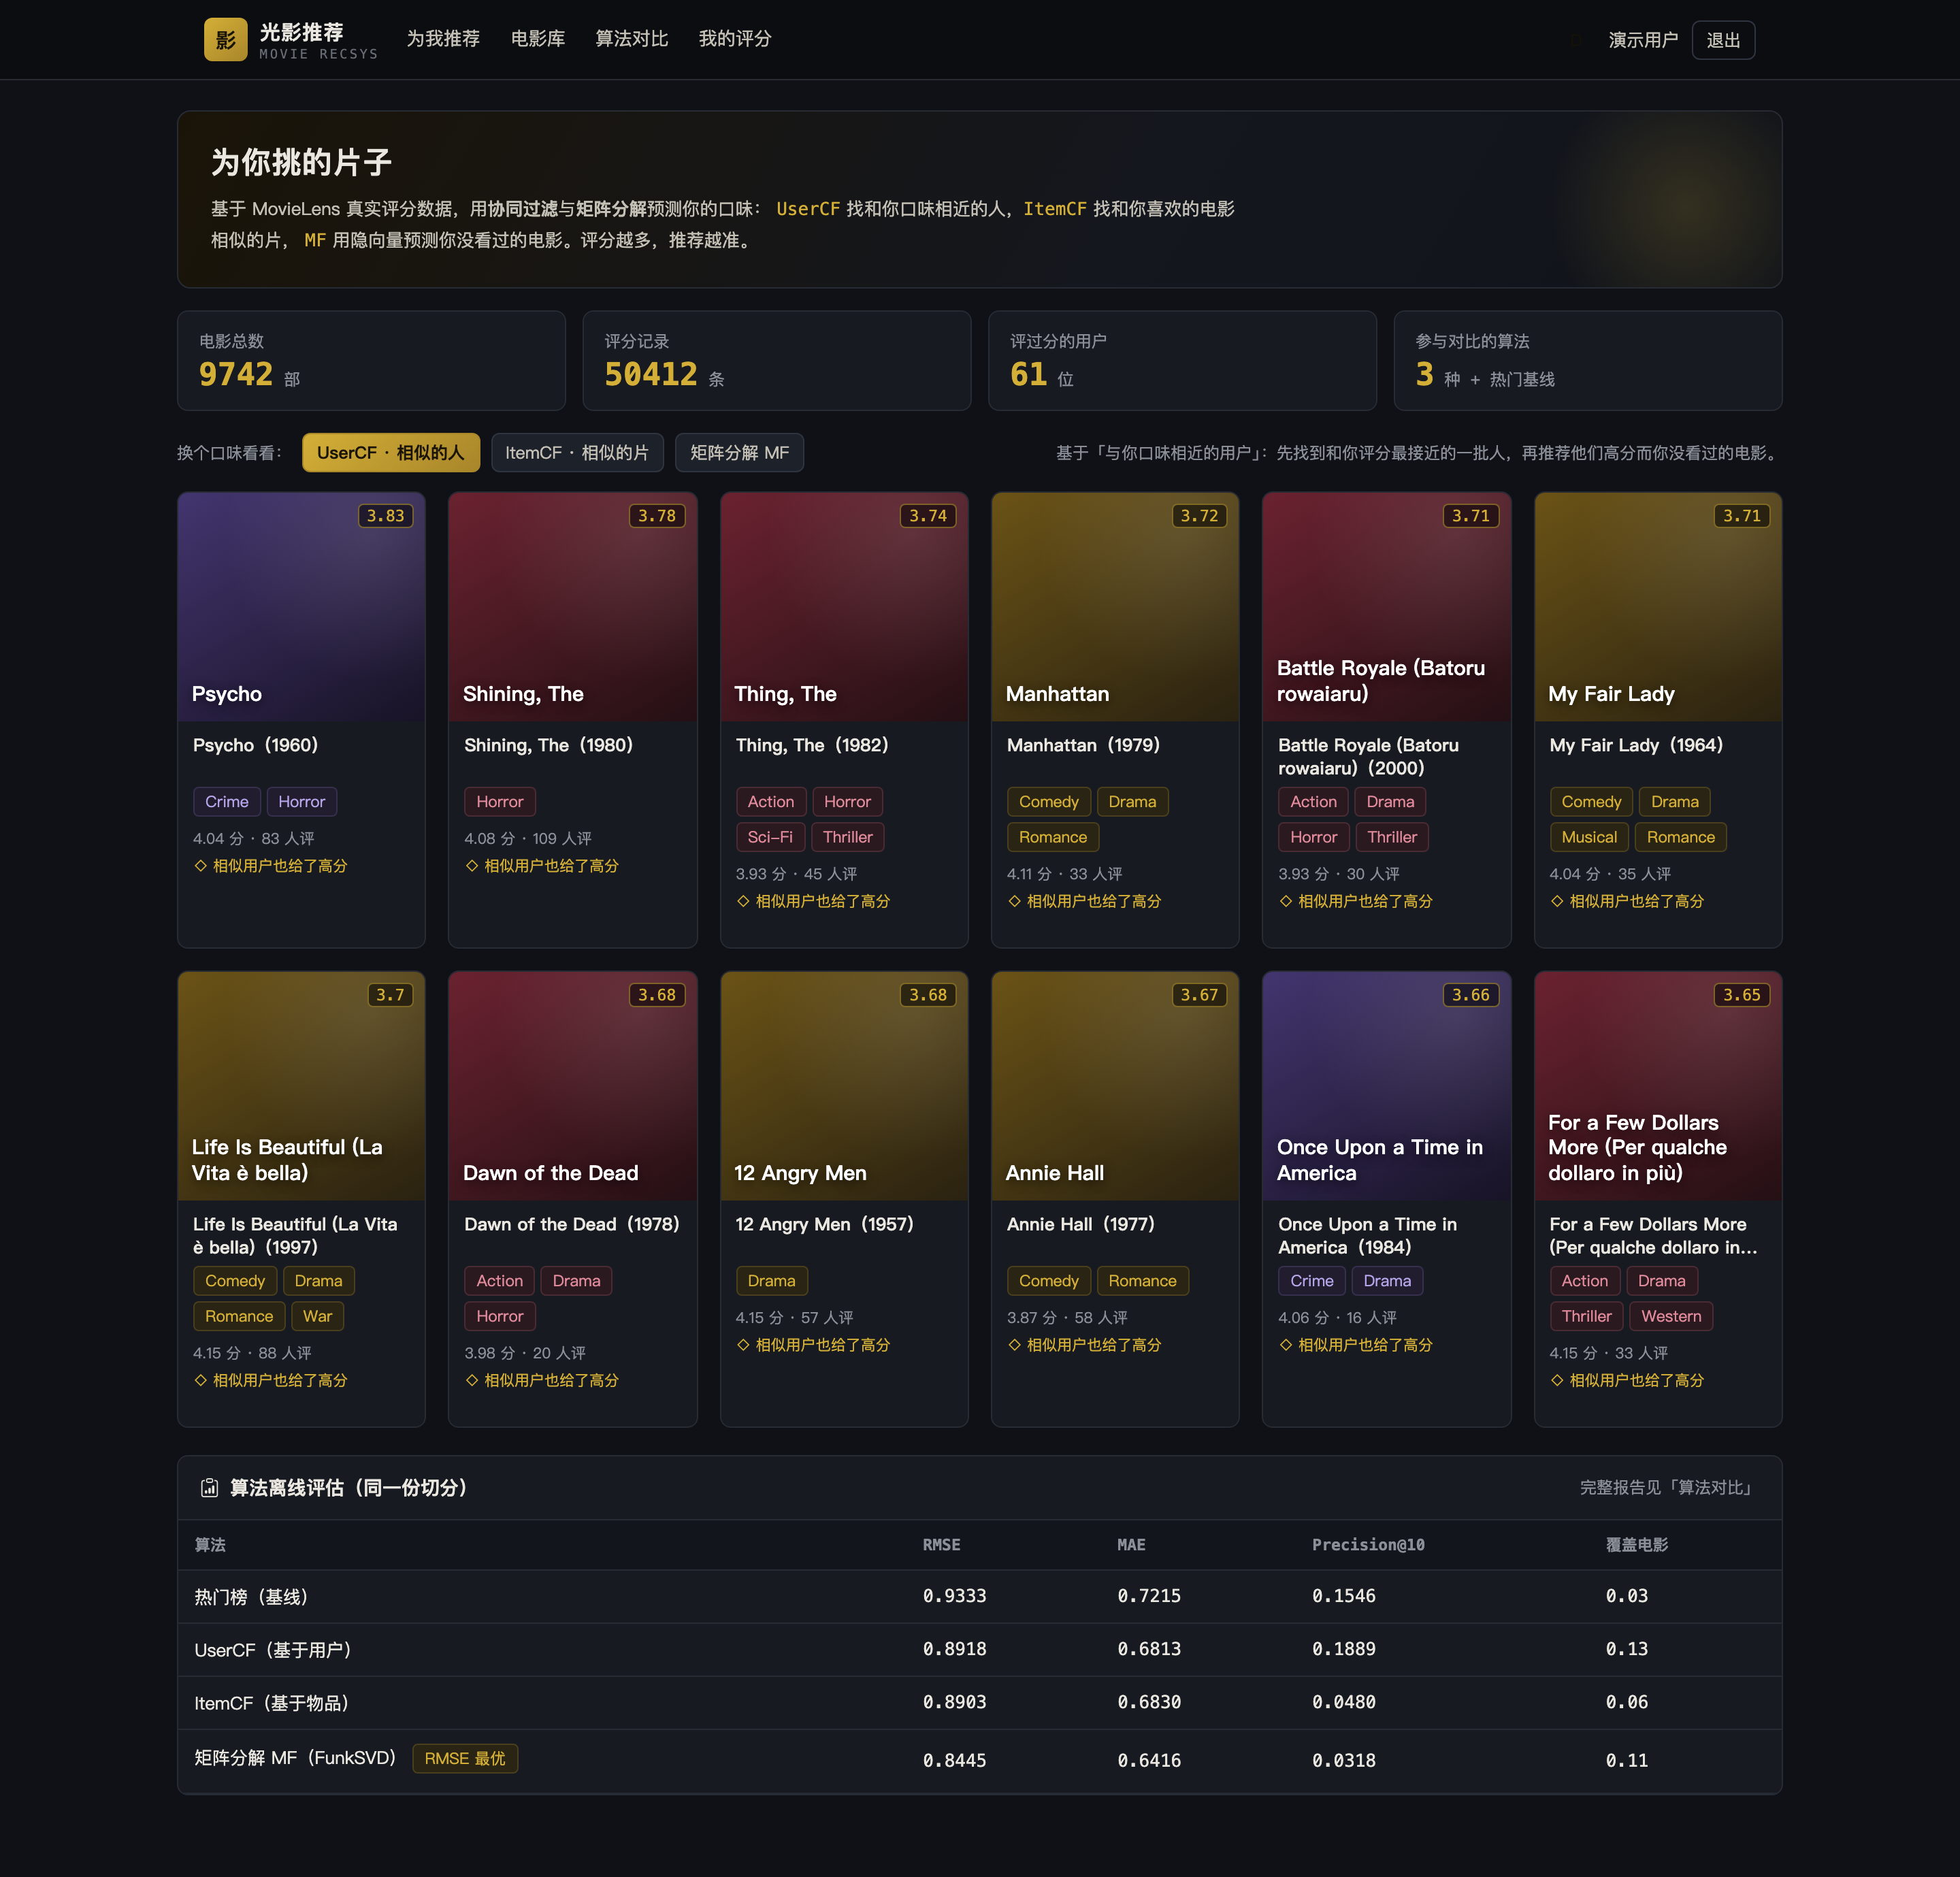
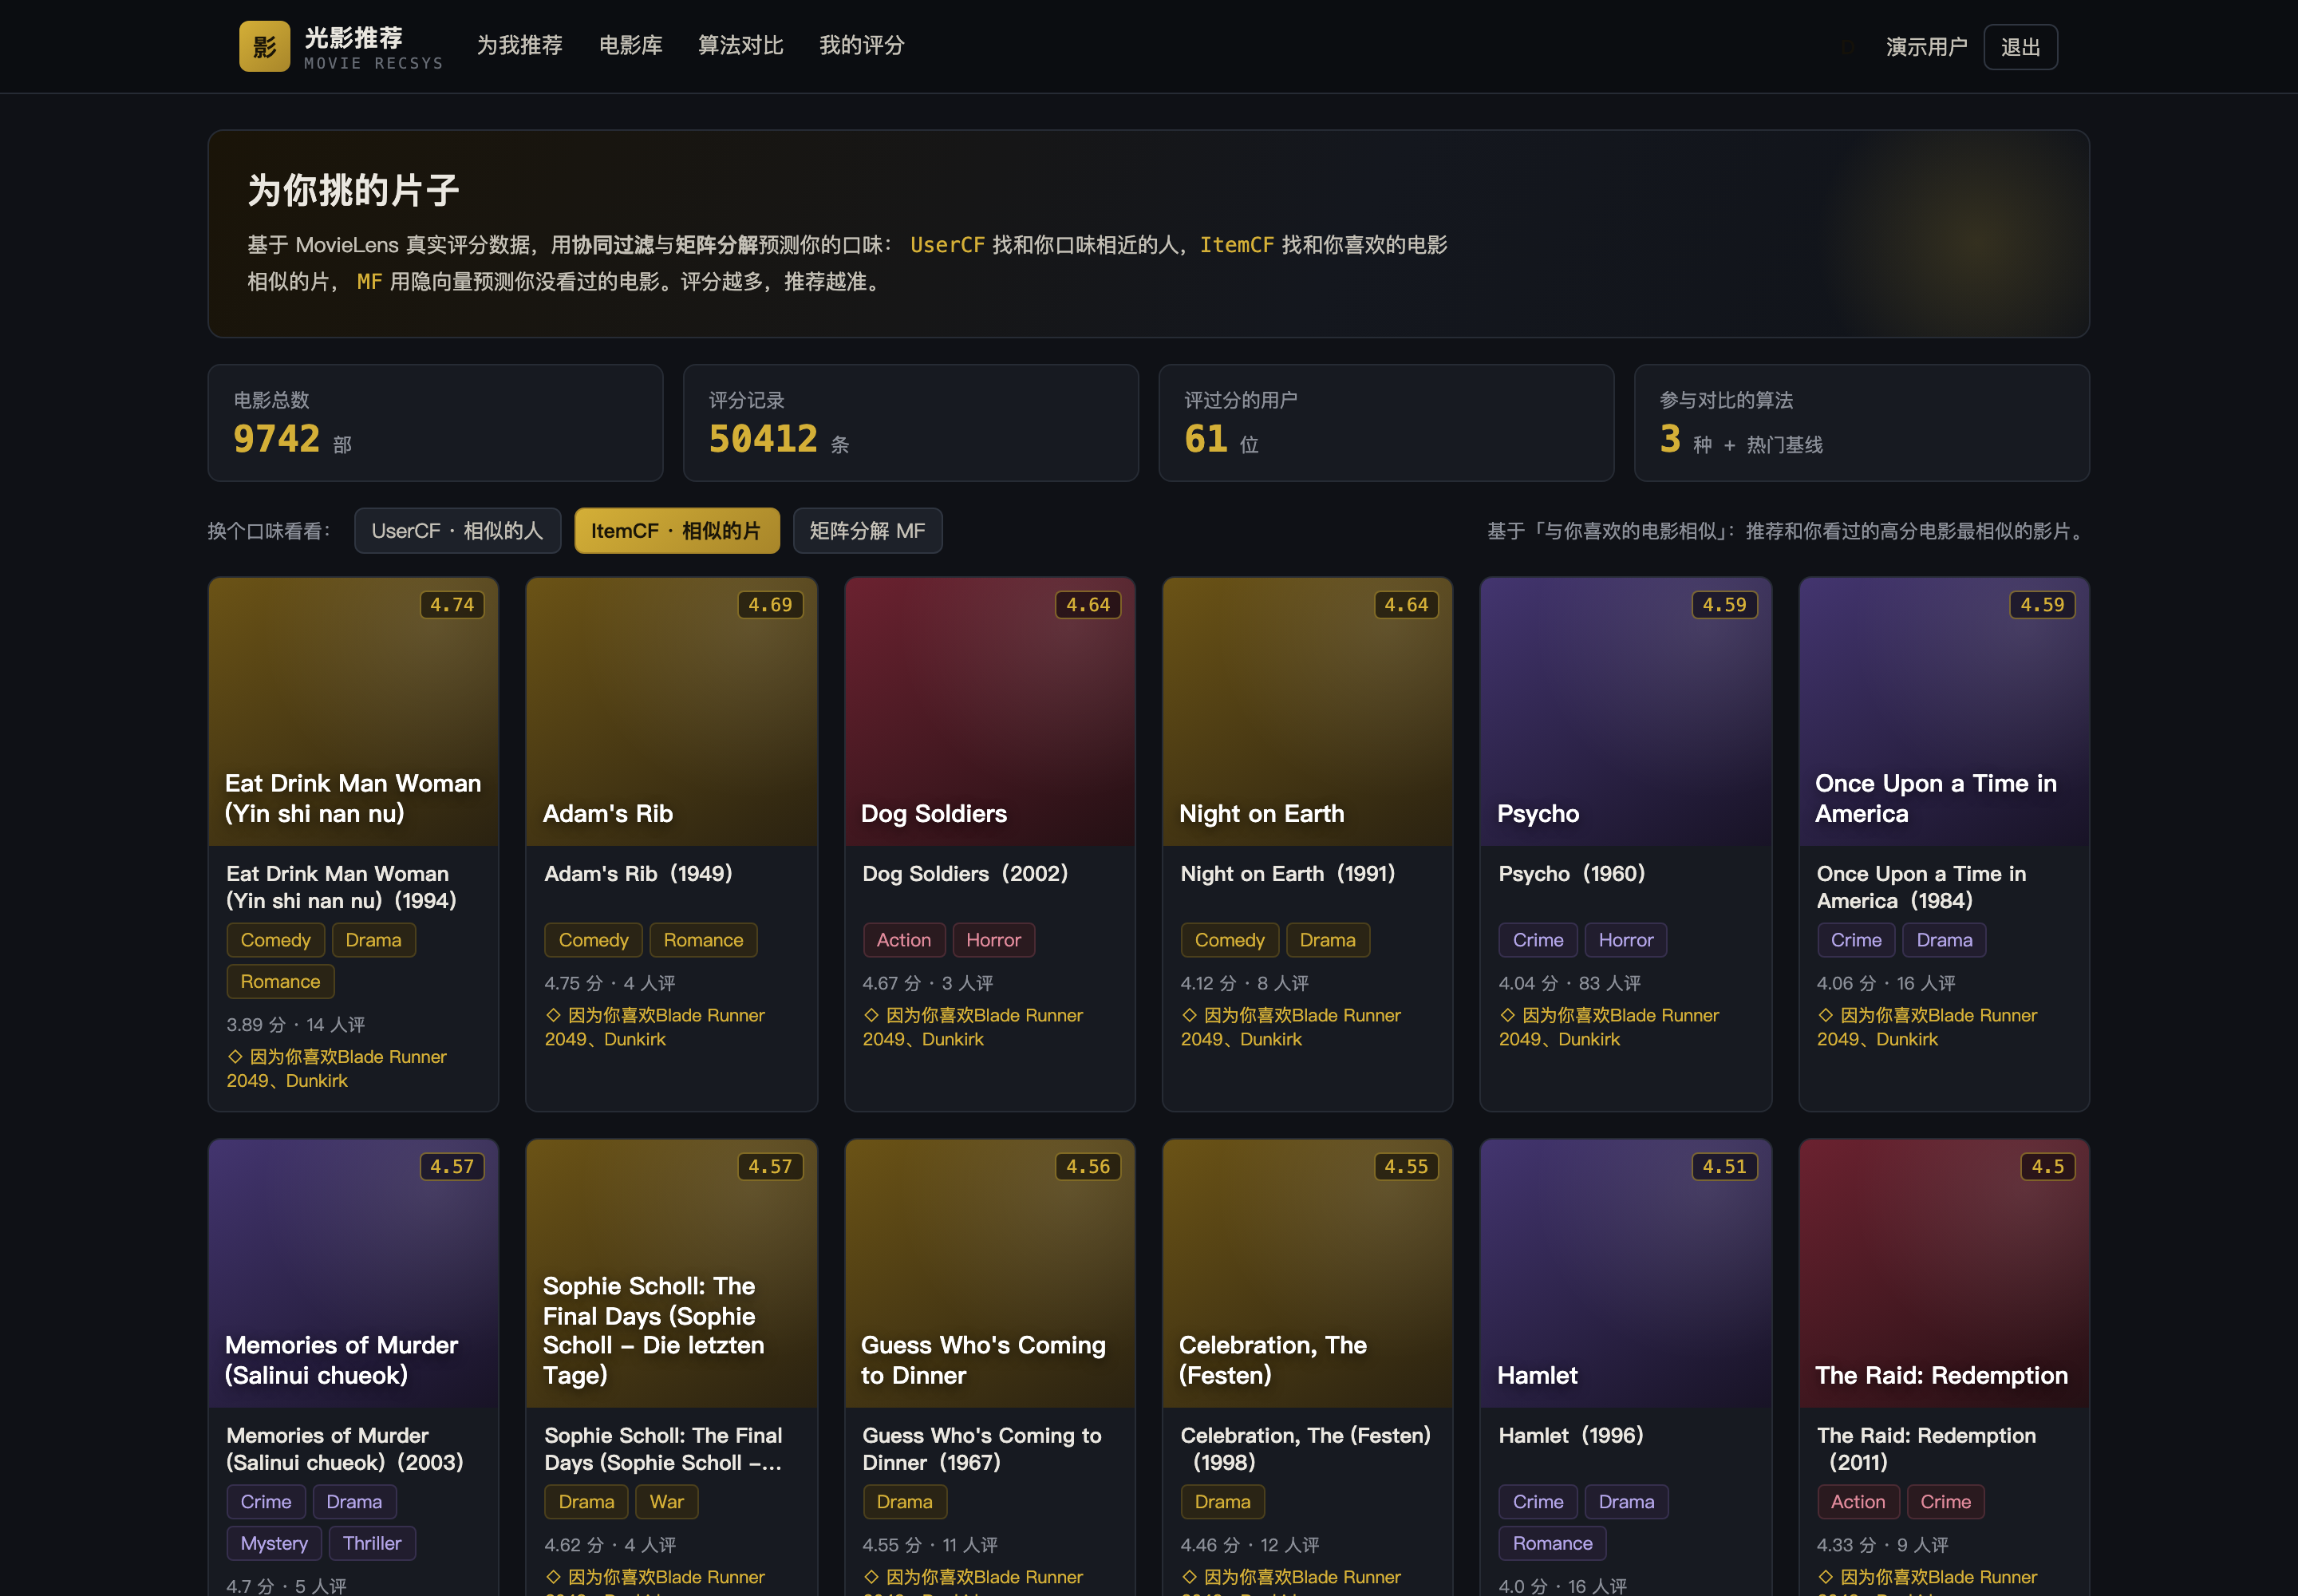
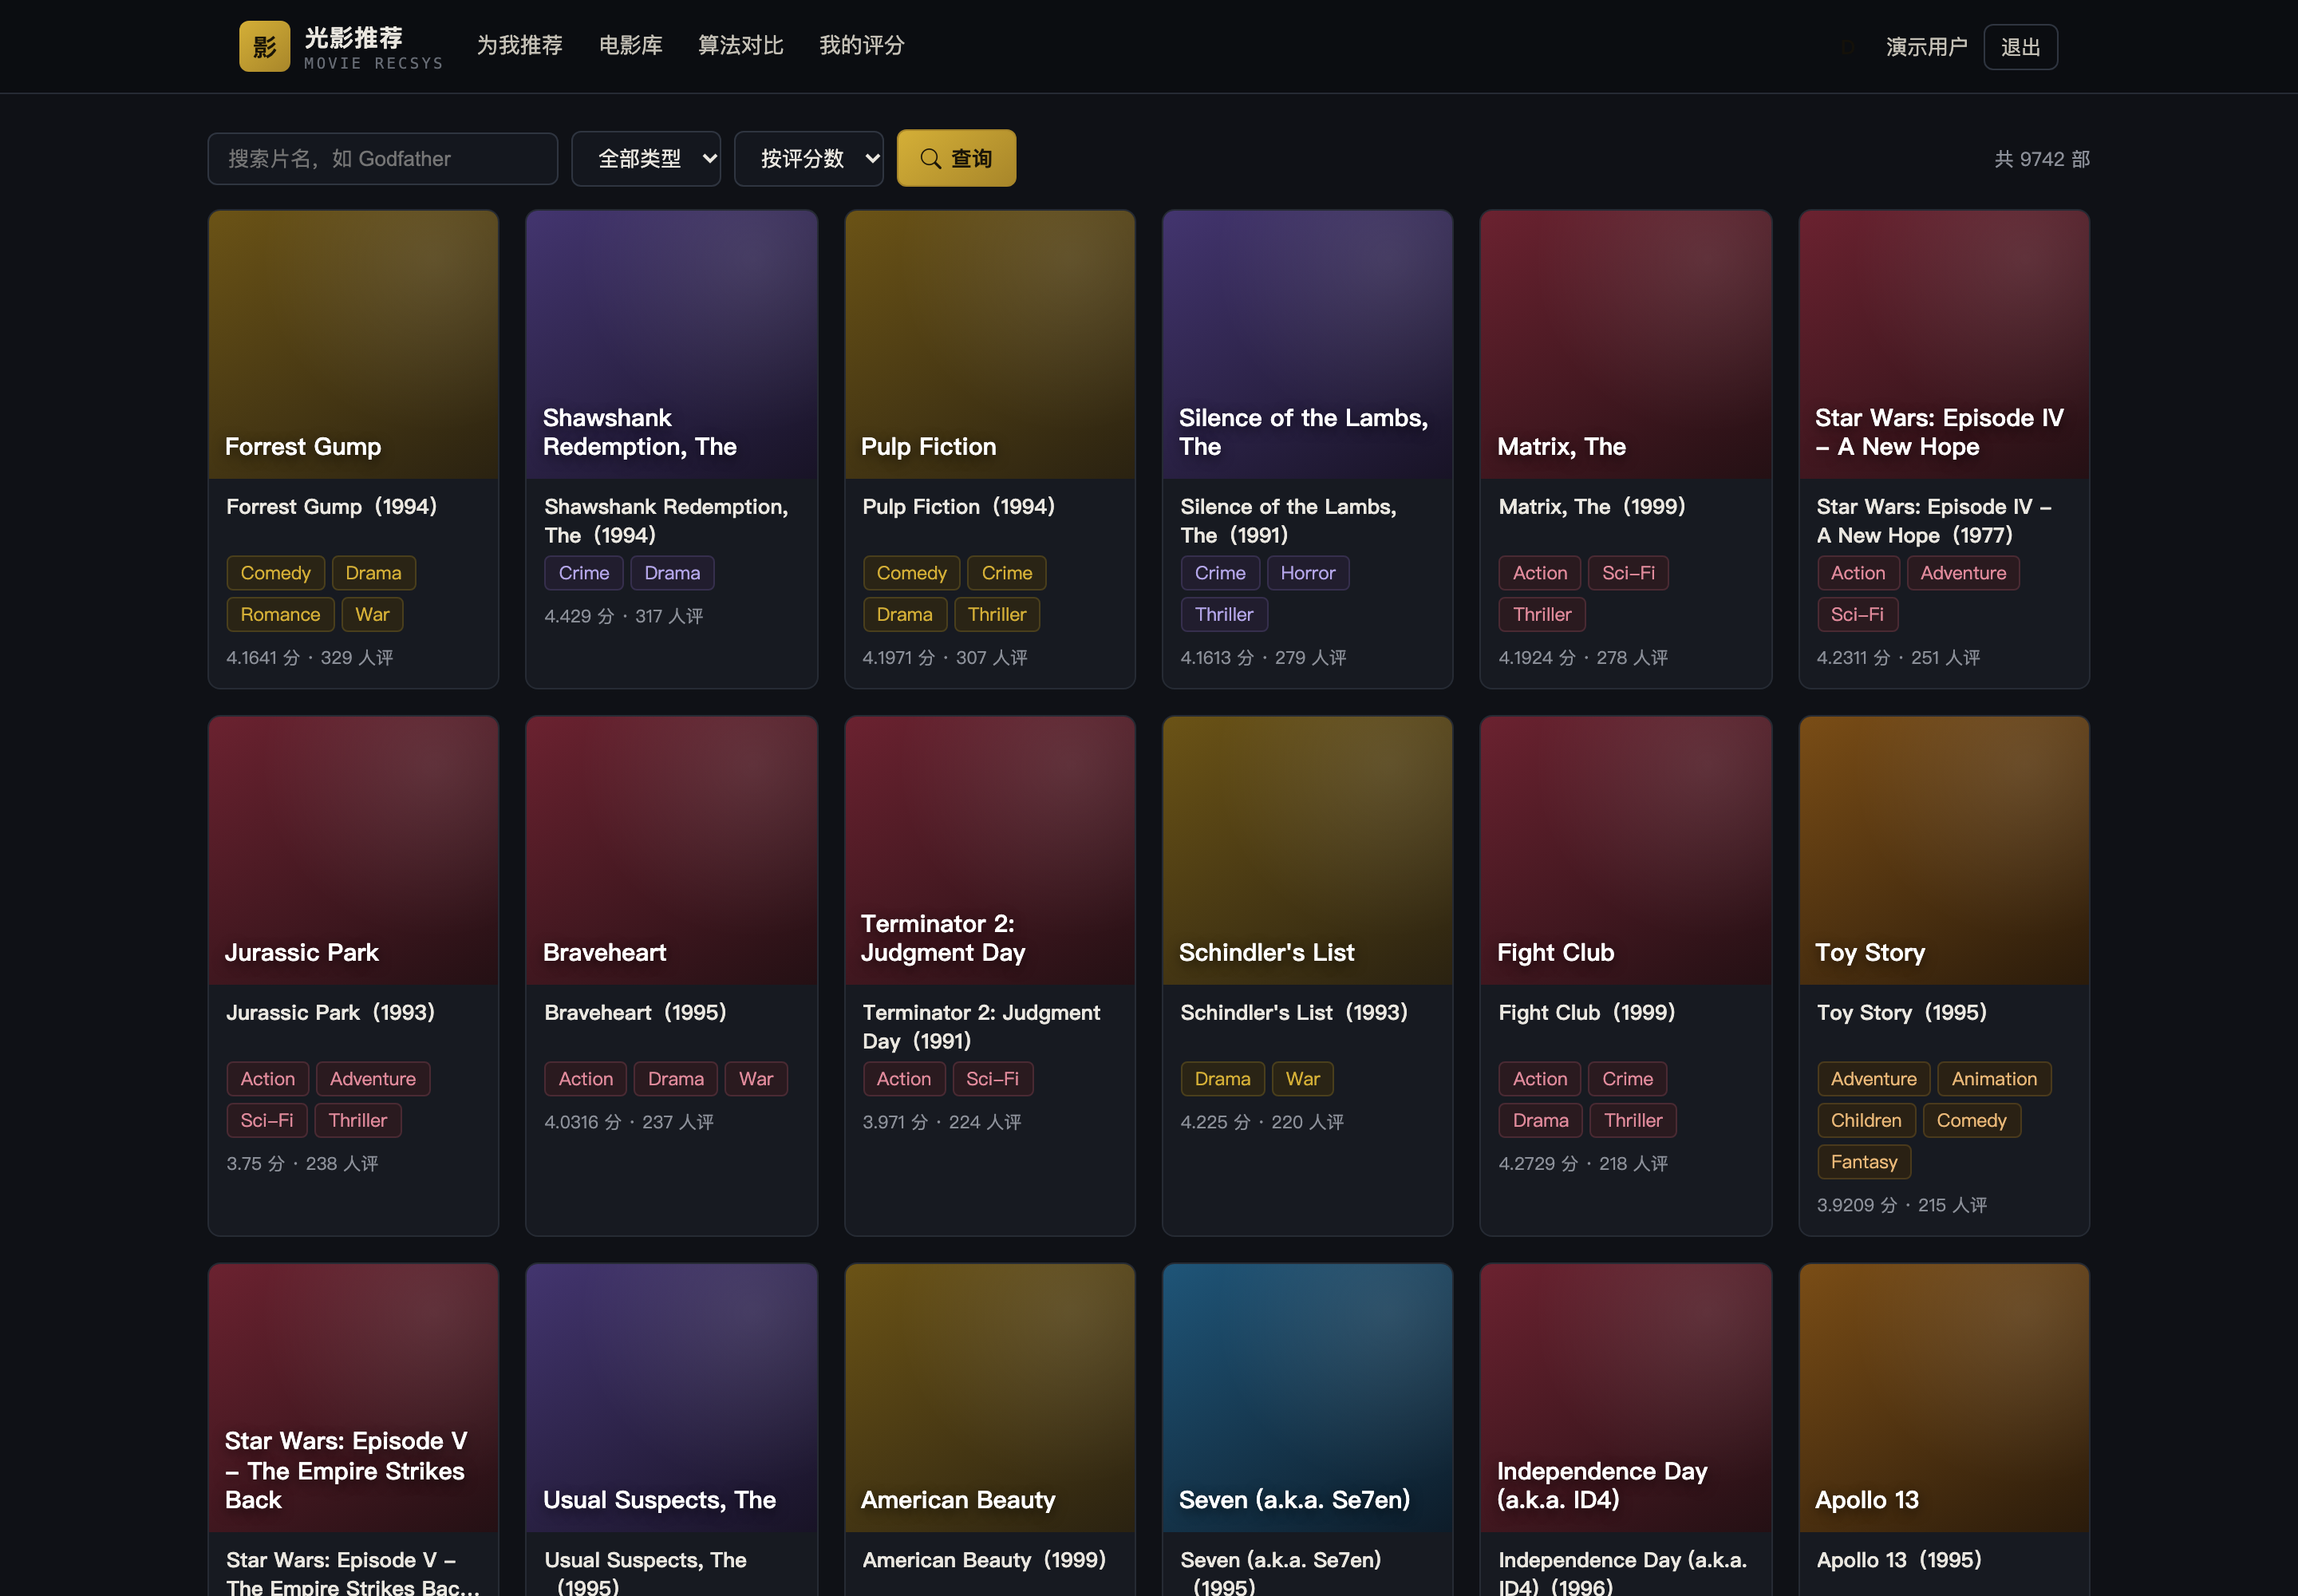
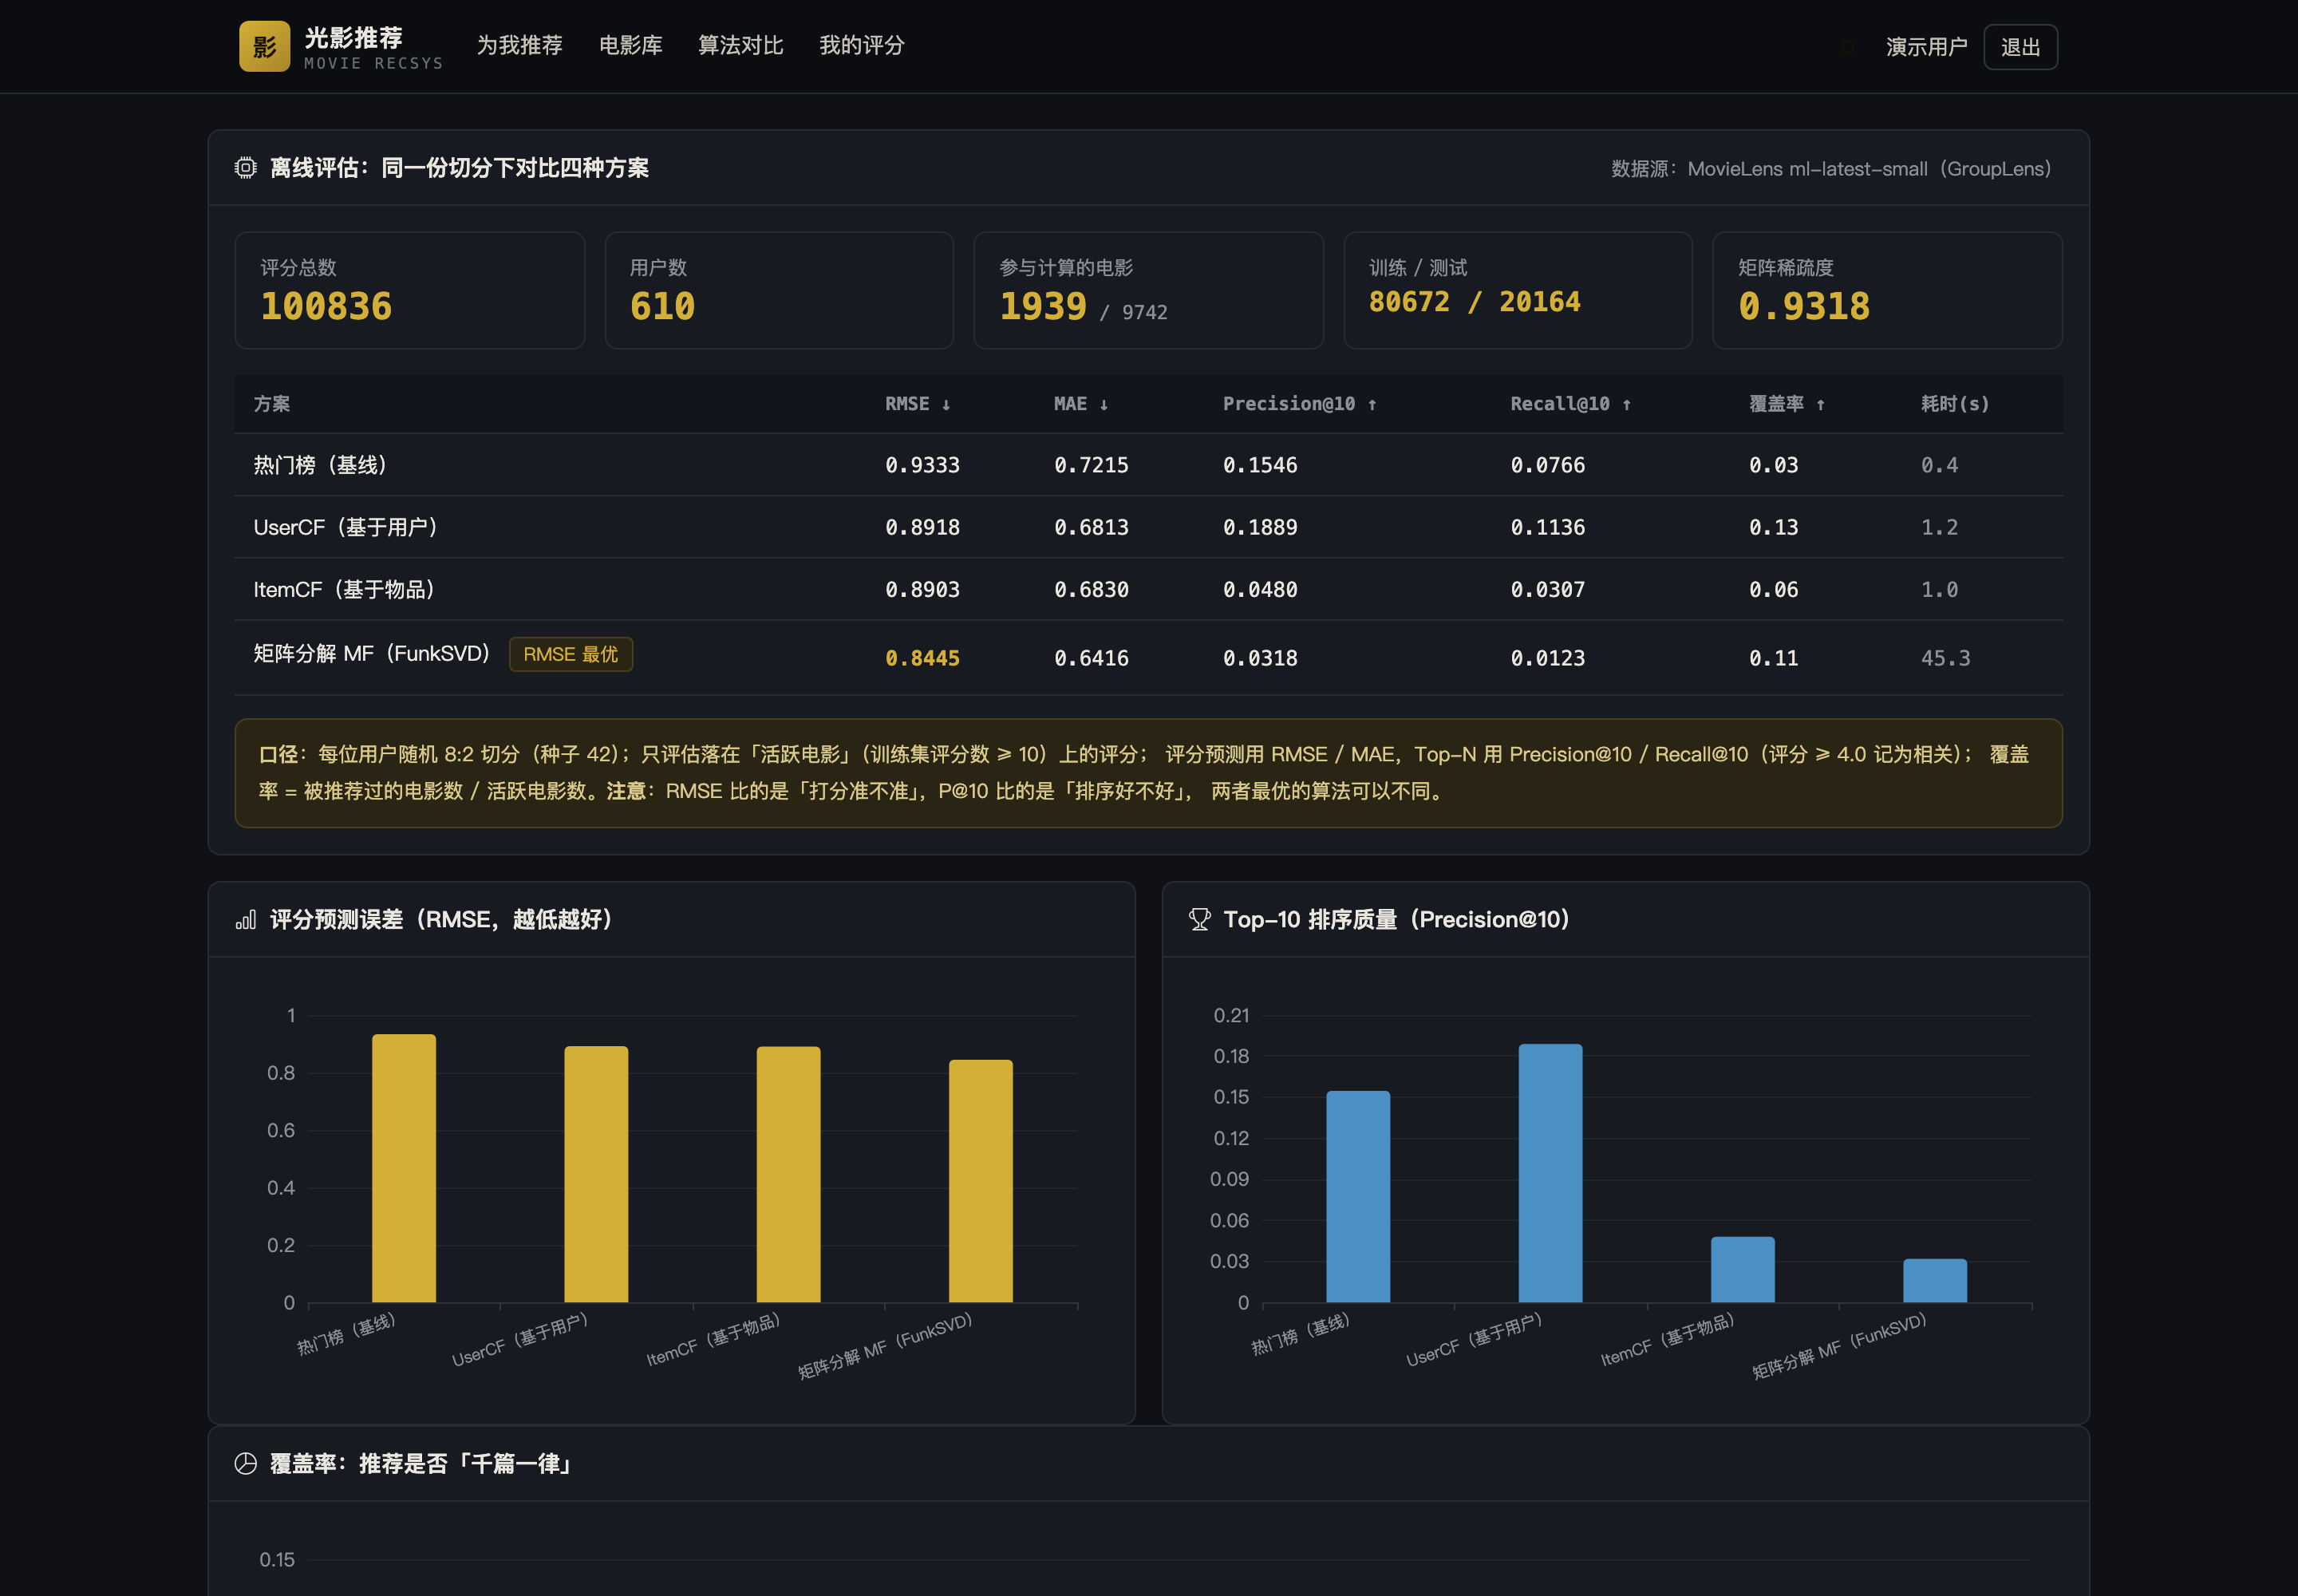
面向影迷的电影推荐系统:浏览与搜索电影、打分、获得个性化推荐(UserCF / ItemCF / 矩阵分解三算法可切换)并查看算法离线对比报告。算法全部用 NumPy 手写,不依赖第三方推荐库。在同一份切分(每用户随机 8:2,种子 42)下比较评分预测(RMSE/MAE)与 Top-N 排序(Precision@10/Recall@10),并报告覆盖率。
演示视频
视频也可在 B 站视频页 观看
运行环境
| 编程语言 | Python 3.8 及以上 |
|---|---|
| 后端框架 | Django 4.2 |
| 算法与计算 | NumPy 1.23 手写(余弦相似度 + TopK 邻居 + FunkSVD),不依赖第三方推荐库 |
| 数据处理 | pandas 2.0 |
| 数据库 | MySQL 8.0(交付默认 SQLite,免安装) |
| 可视化 | ECharts 5(已内置本地文件,离线可用) |
| 数据集 | MovieLens ml-latest-small(100836 条评分 / 610 用户 / 9742 电影),原始 CSV 随包 |
| 操作系统 | Windows / macOS / Linux |
| 启动方式 | 双击一键脚本,或 python manage.py runserver 8075 |
功能模块
- 三算法对比实验:热门基线 / UserCF / ItemCF / 矩阵分解(FunkSVD)在同一份切分下评测,指标由脚本产出、页面直接读取
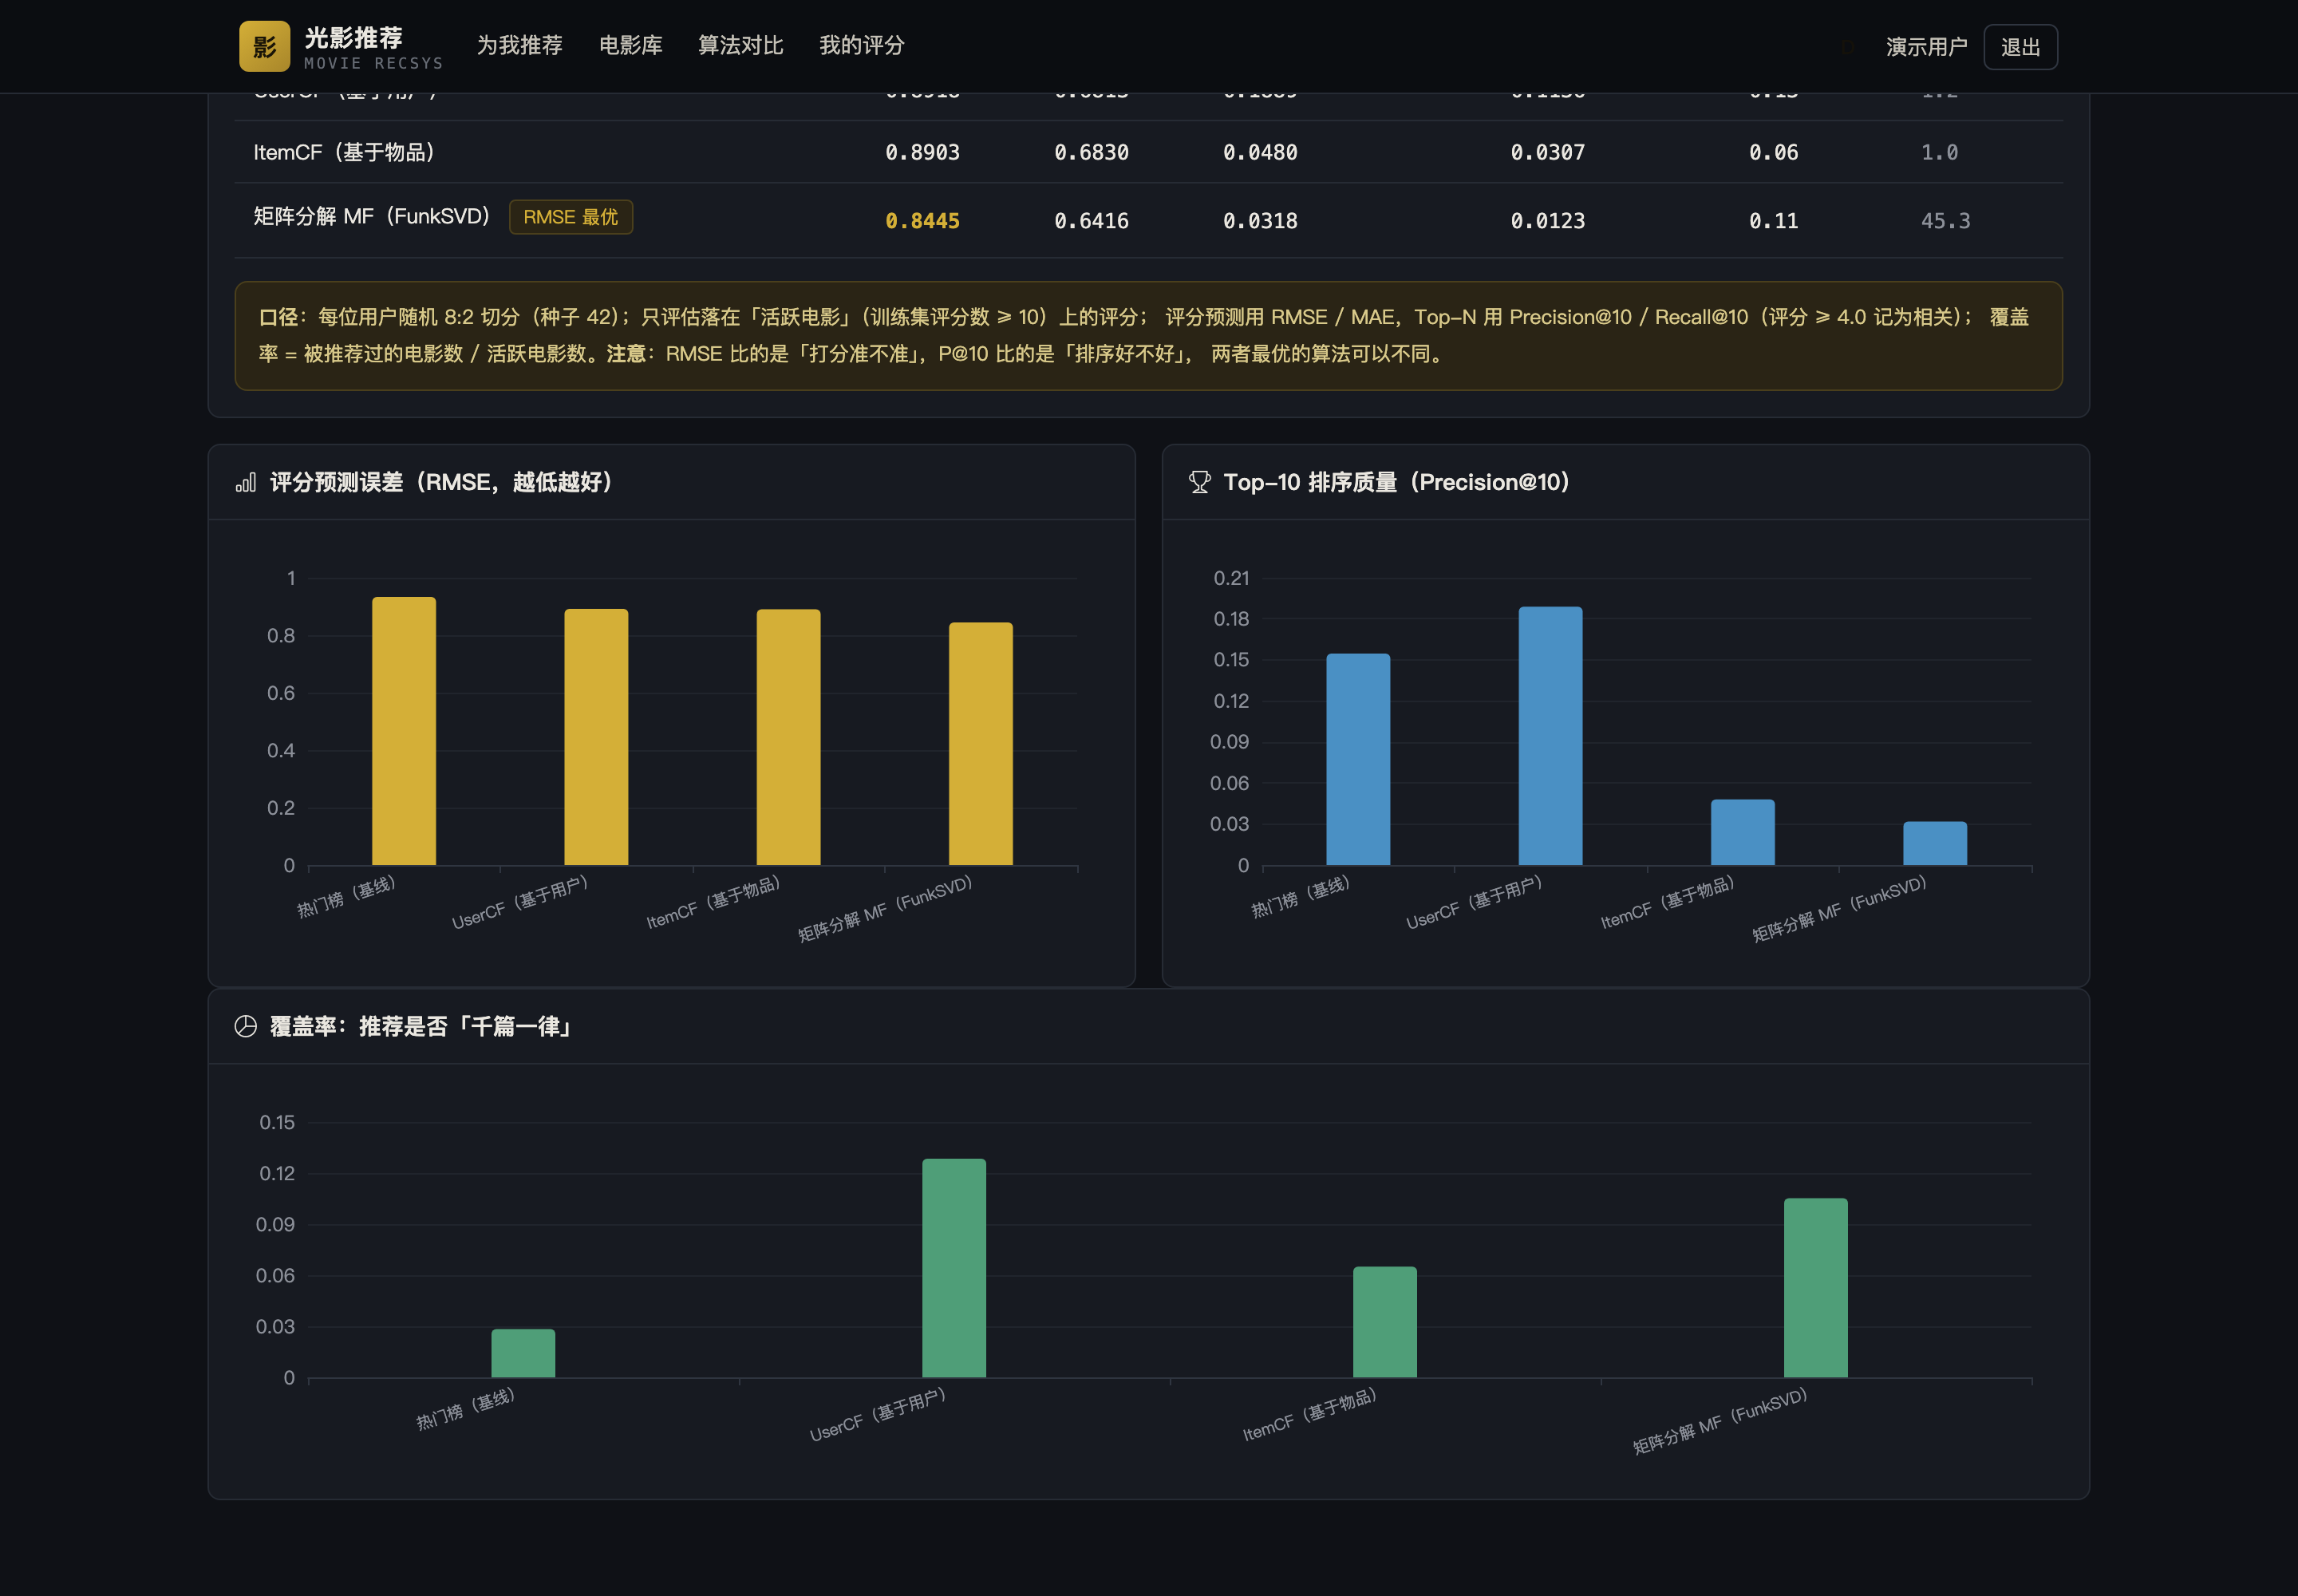
- 评分预测与排序质量分开看:MF 的 RMSE 最低(0.8445),UserCF 的 Top-10 排序最好(P@10 0.1889)
- 覆盖率对比:UserCF 覆盖 12.84%,热门基线仅 2.84% —— 说明个性化推荐确实打破了「千人一面」
- 收缩项(λ=10):把低证据预测拉回均值;无收缩时邻域方法 P@10 低到 0.004(低于随机),这是稀疏数据上的关键细节
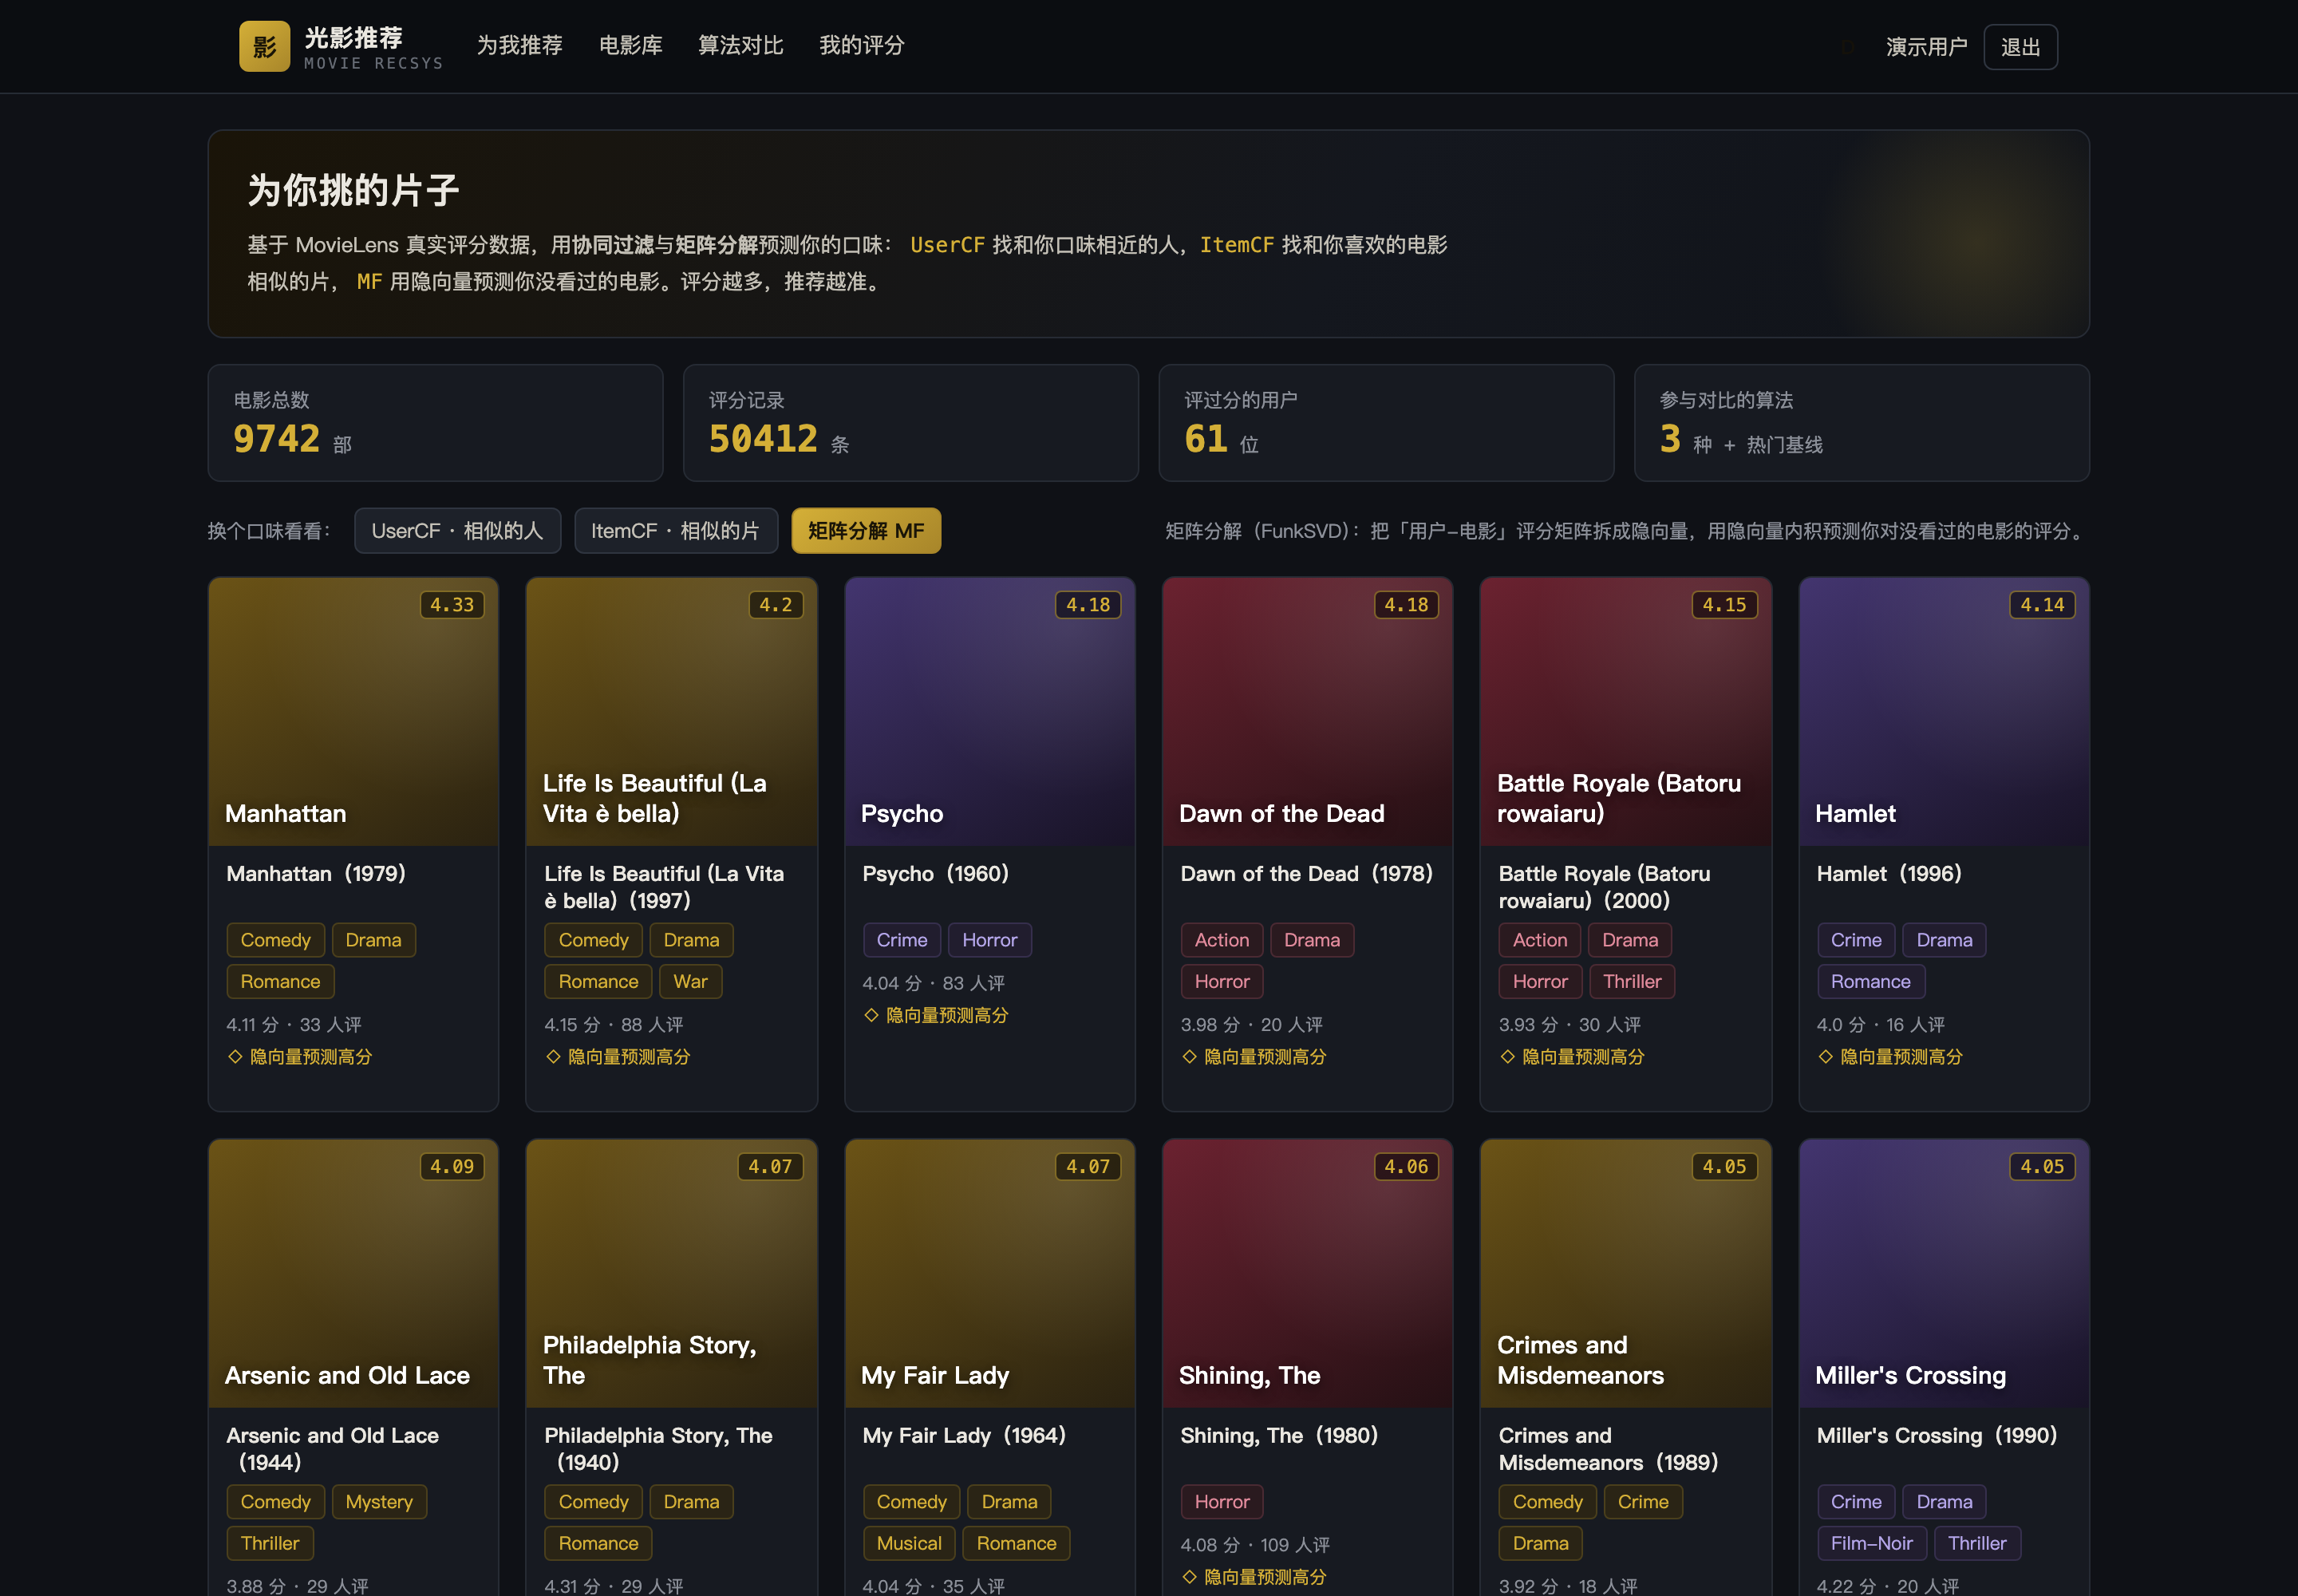
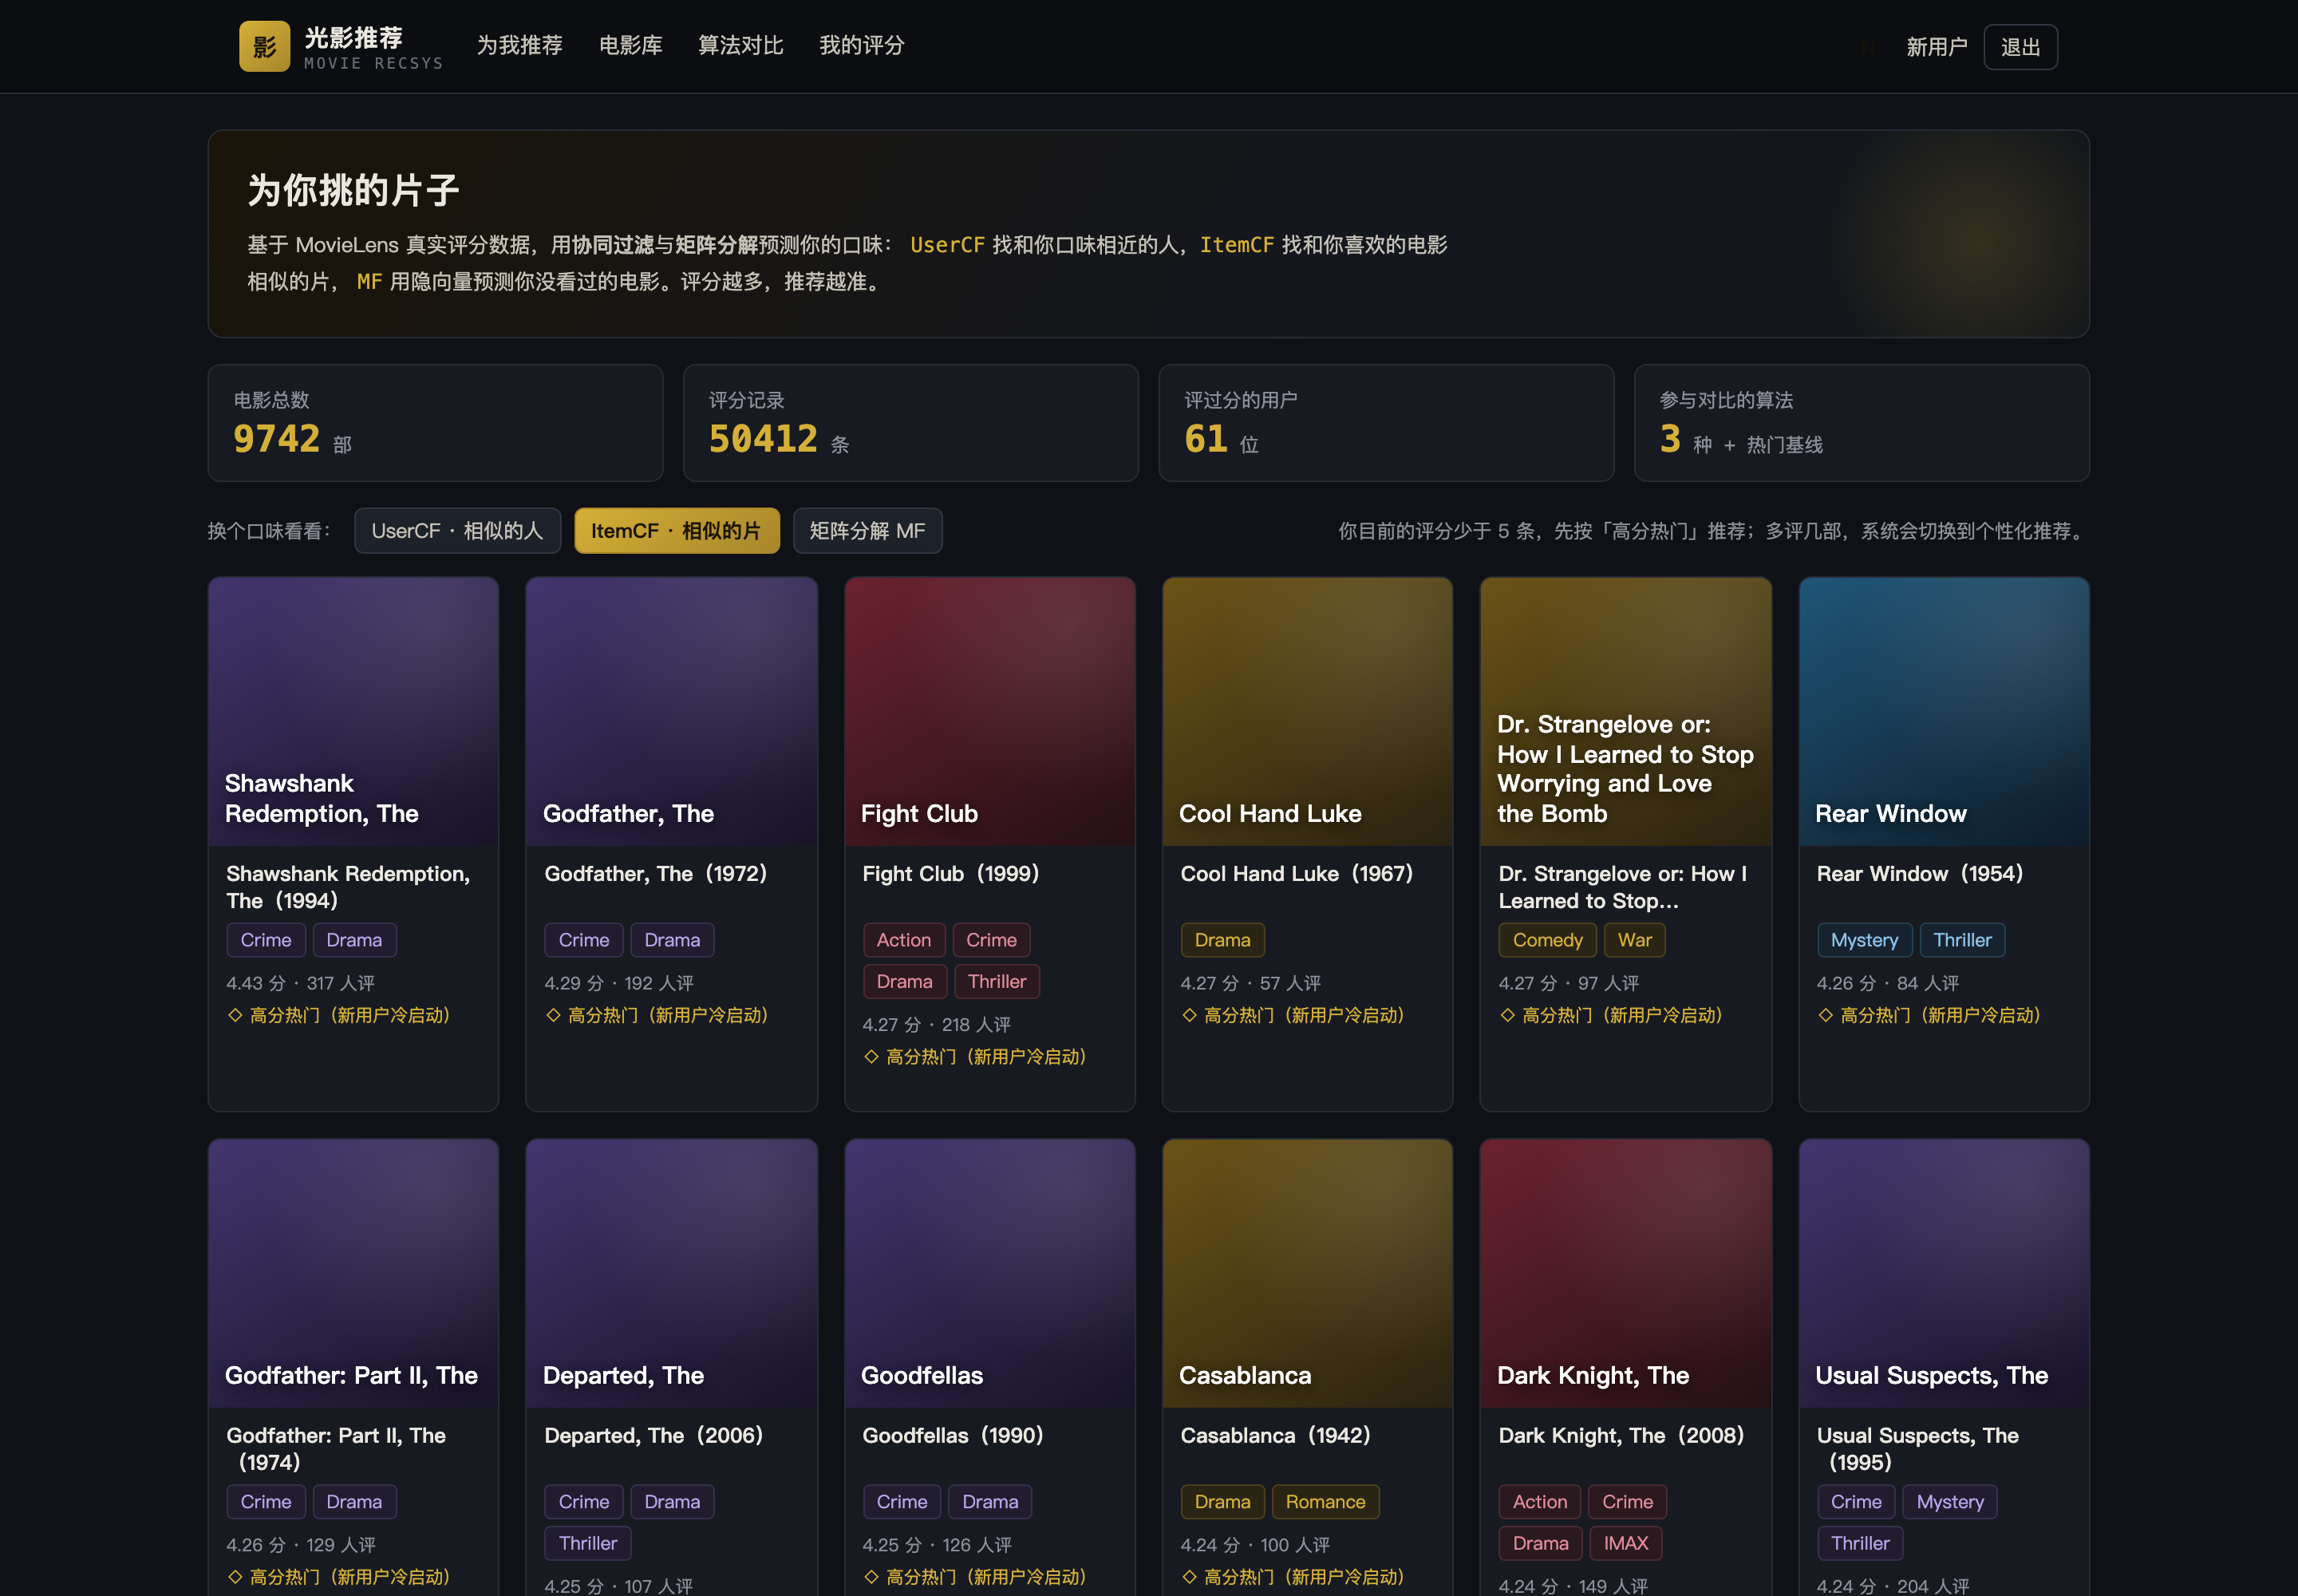
- 可解释推荐:卡片给出理由(相似用户也给了高分 / 因为你喜欢 X / 隐向量预测高分)
- 冷启动兜底:评分数少于 5 条按「高分热门」推荐并提示,不返回空结果
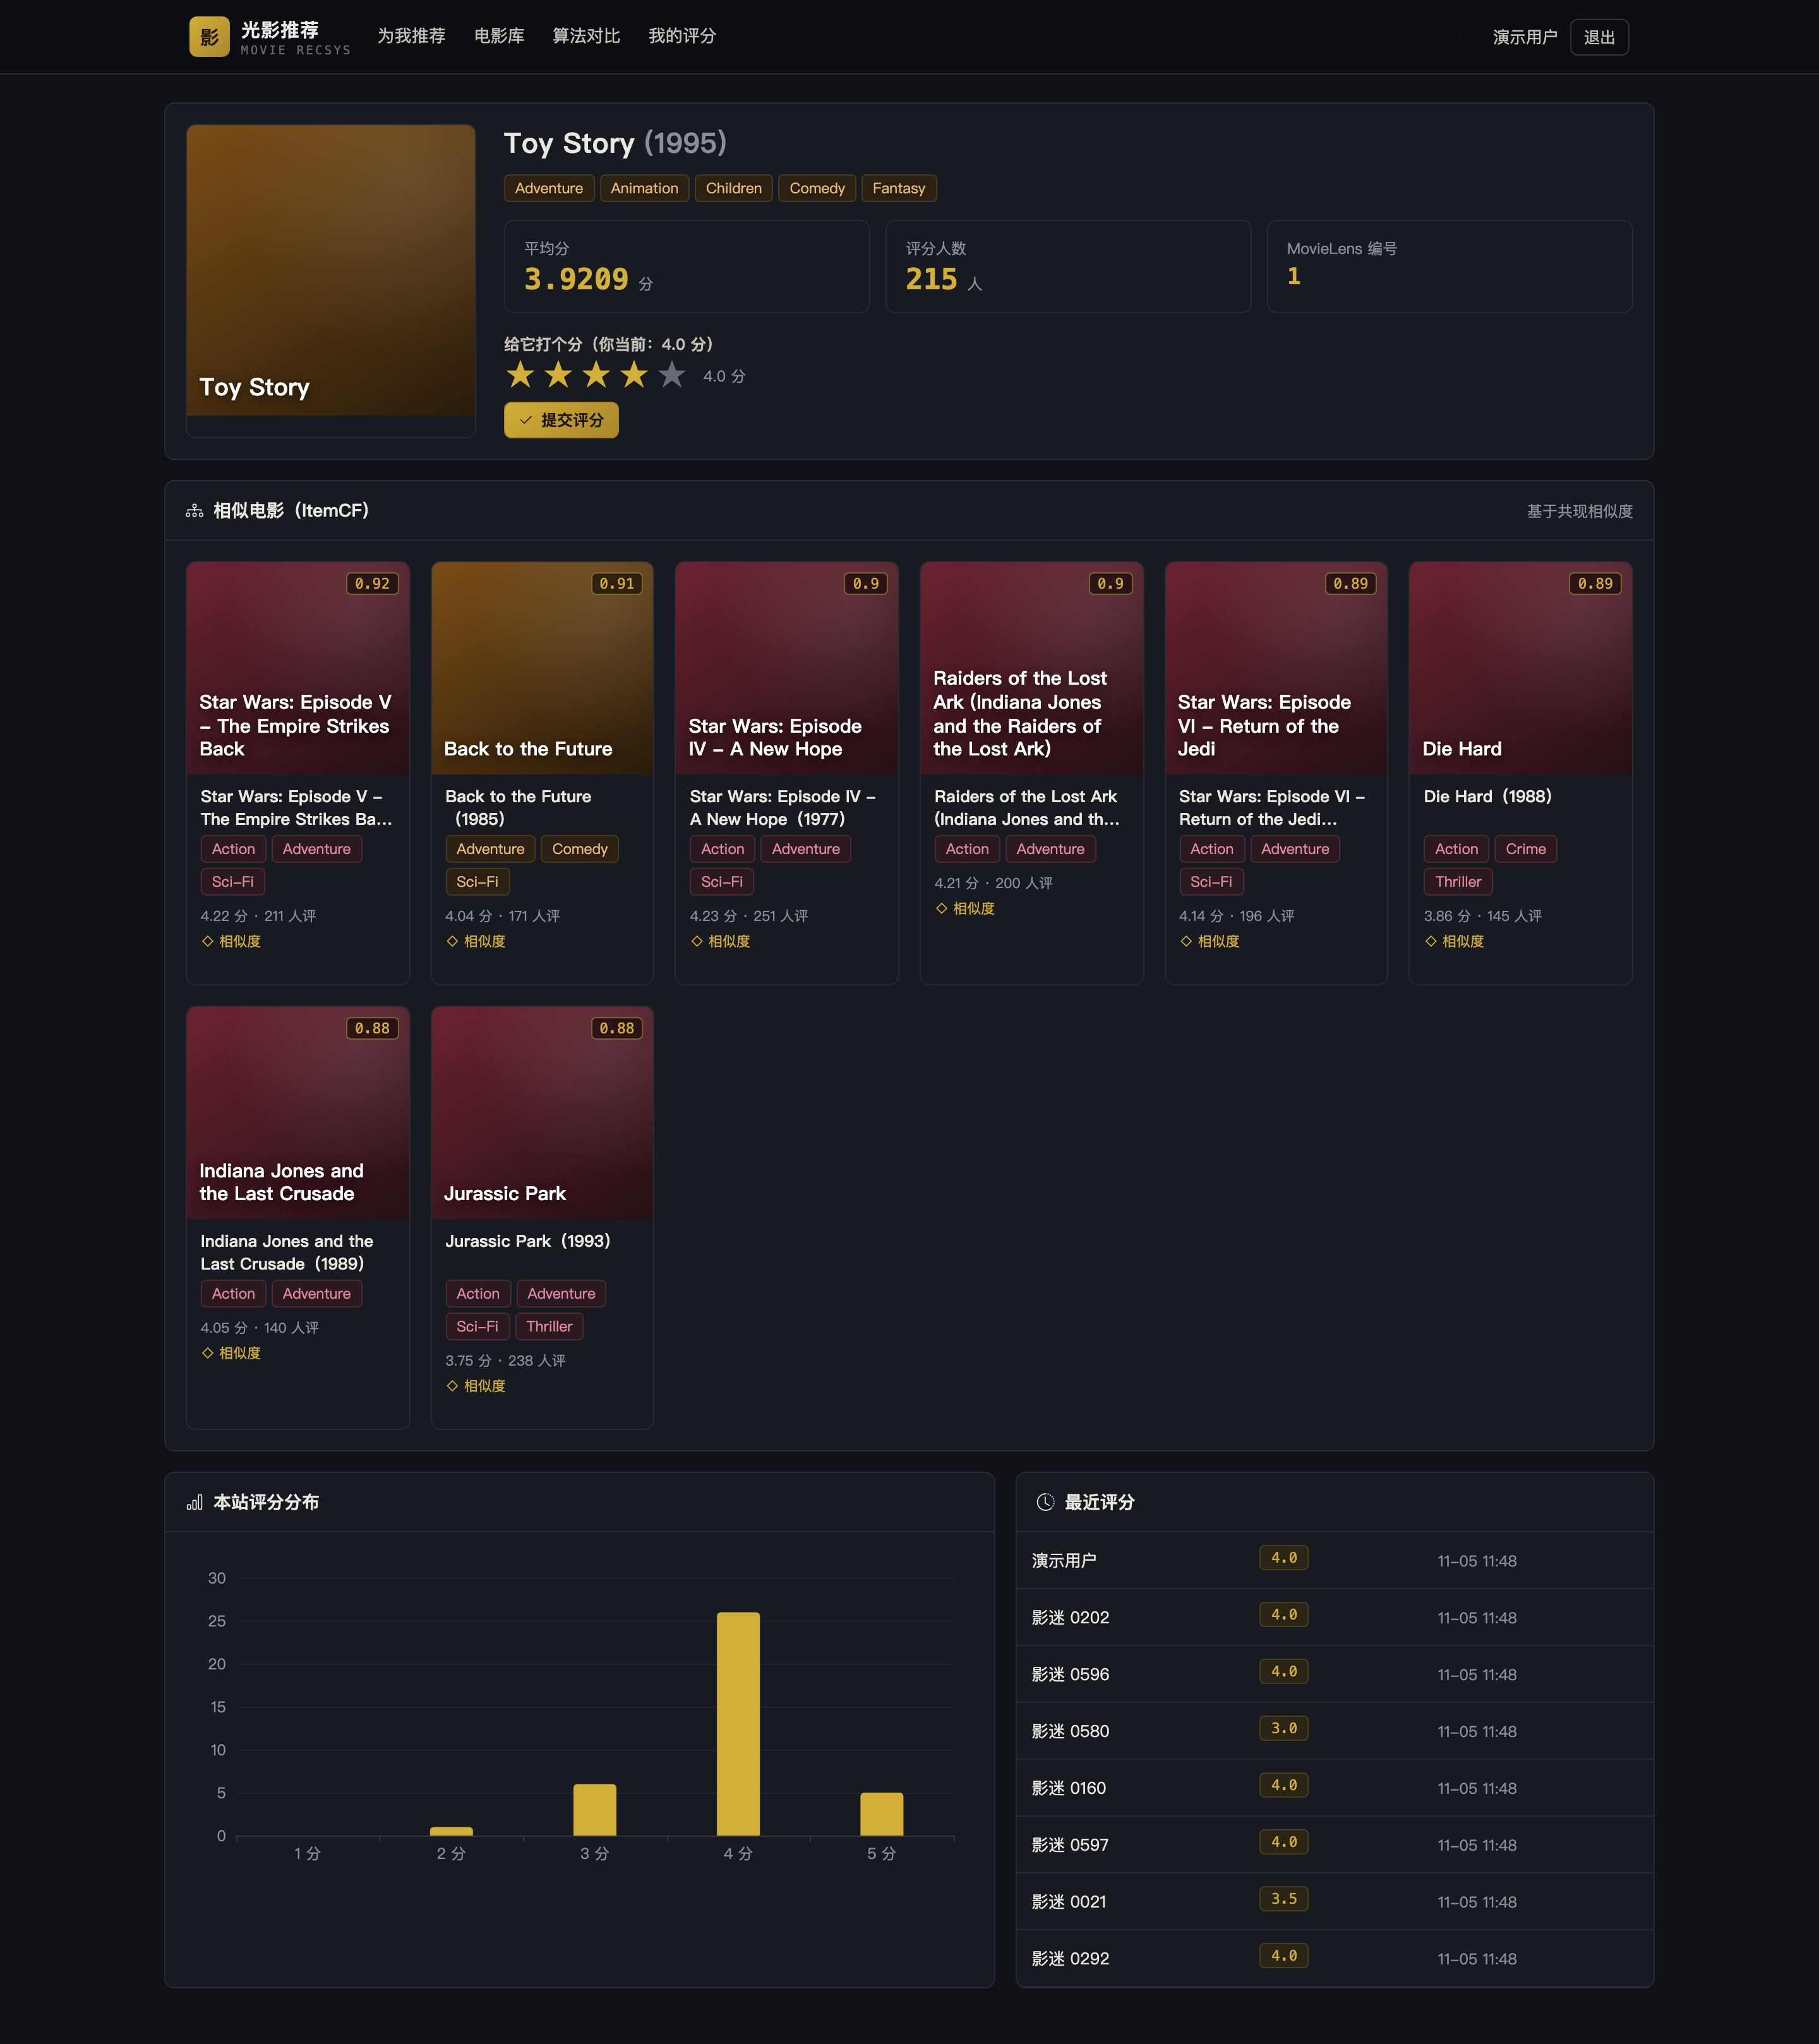
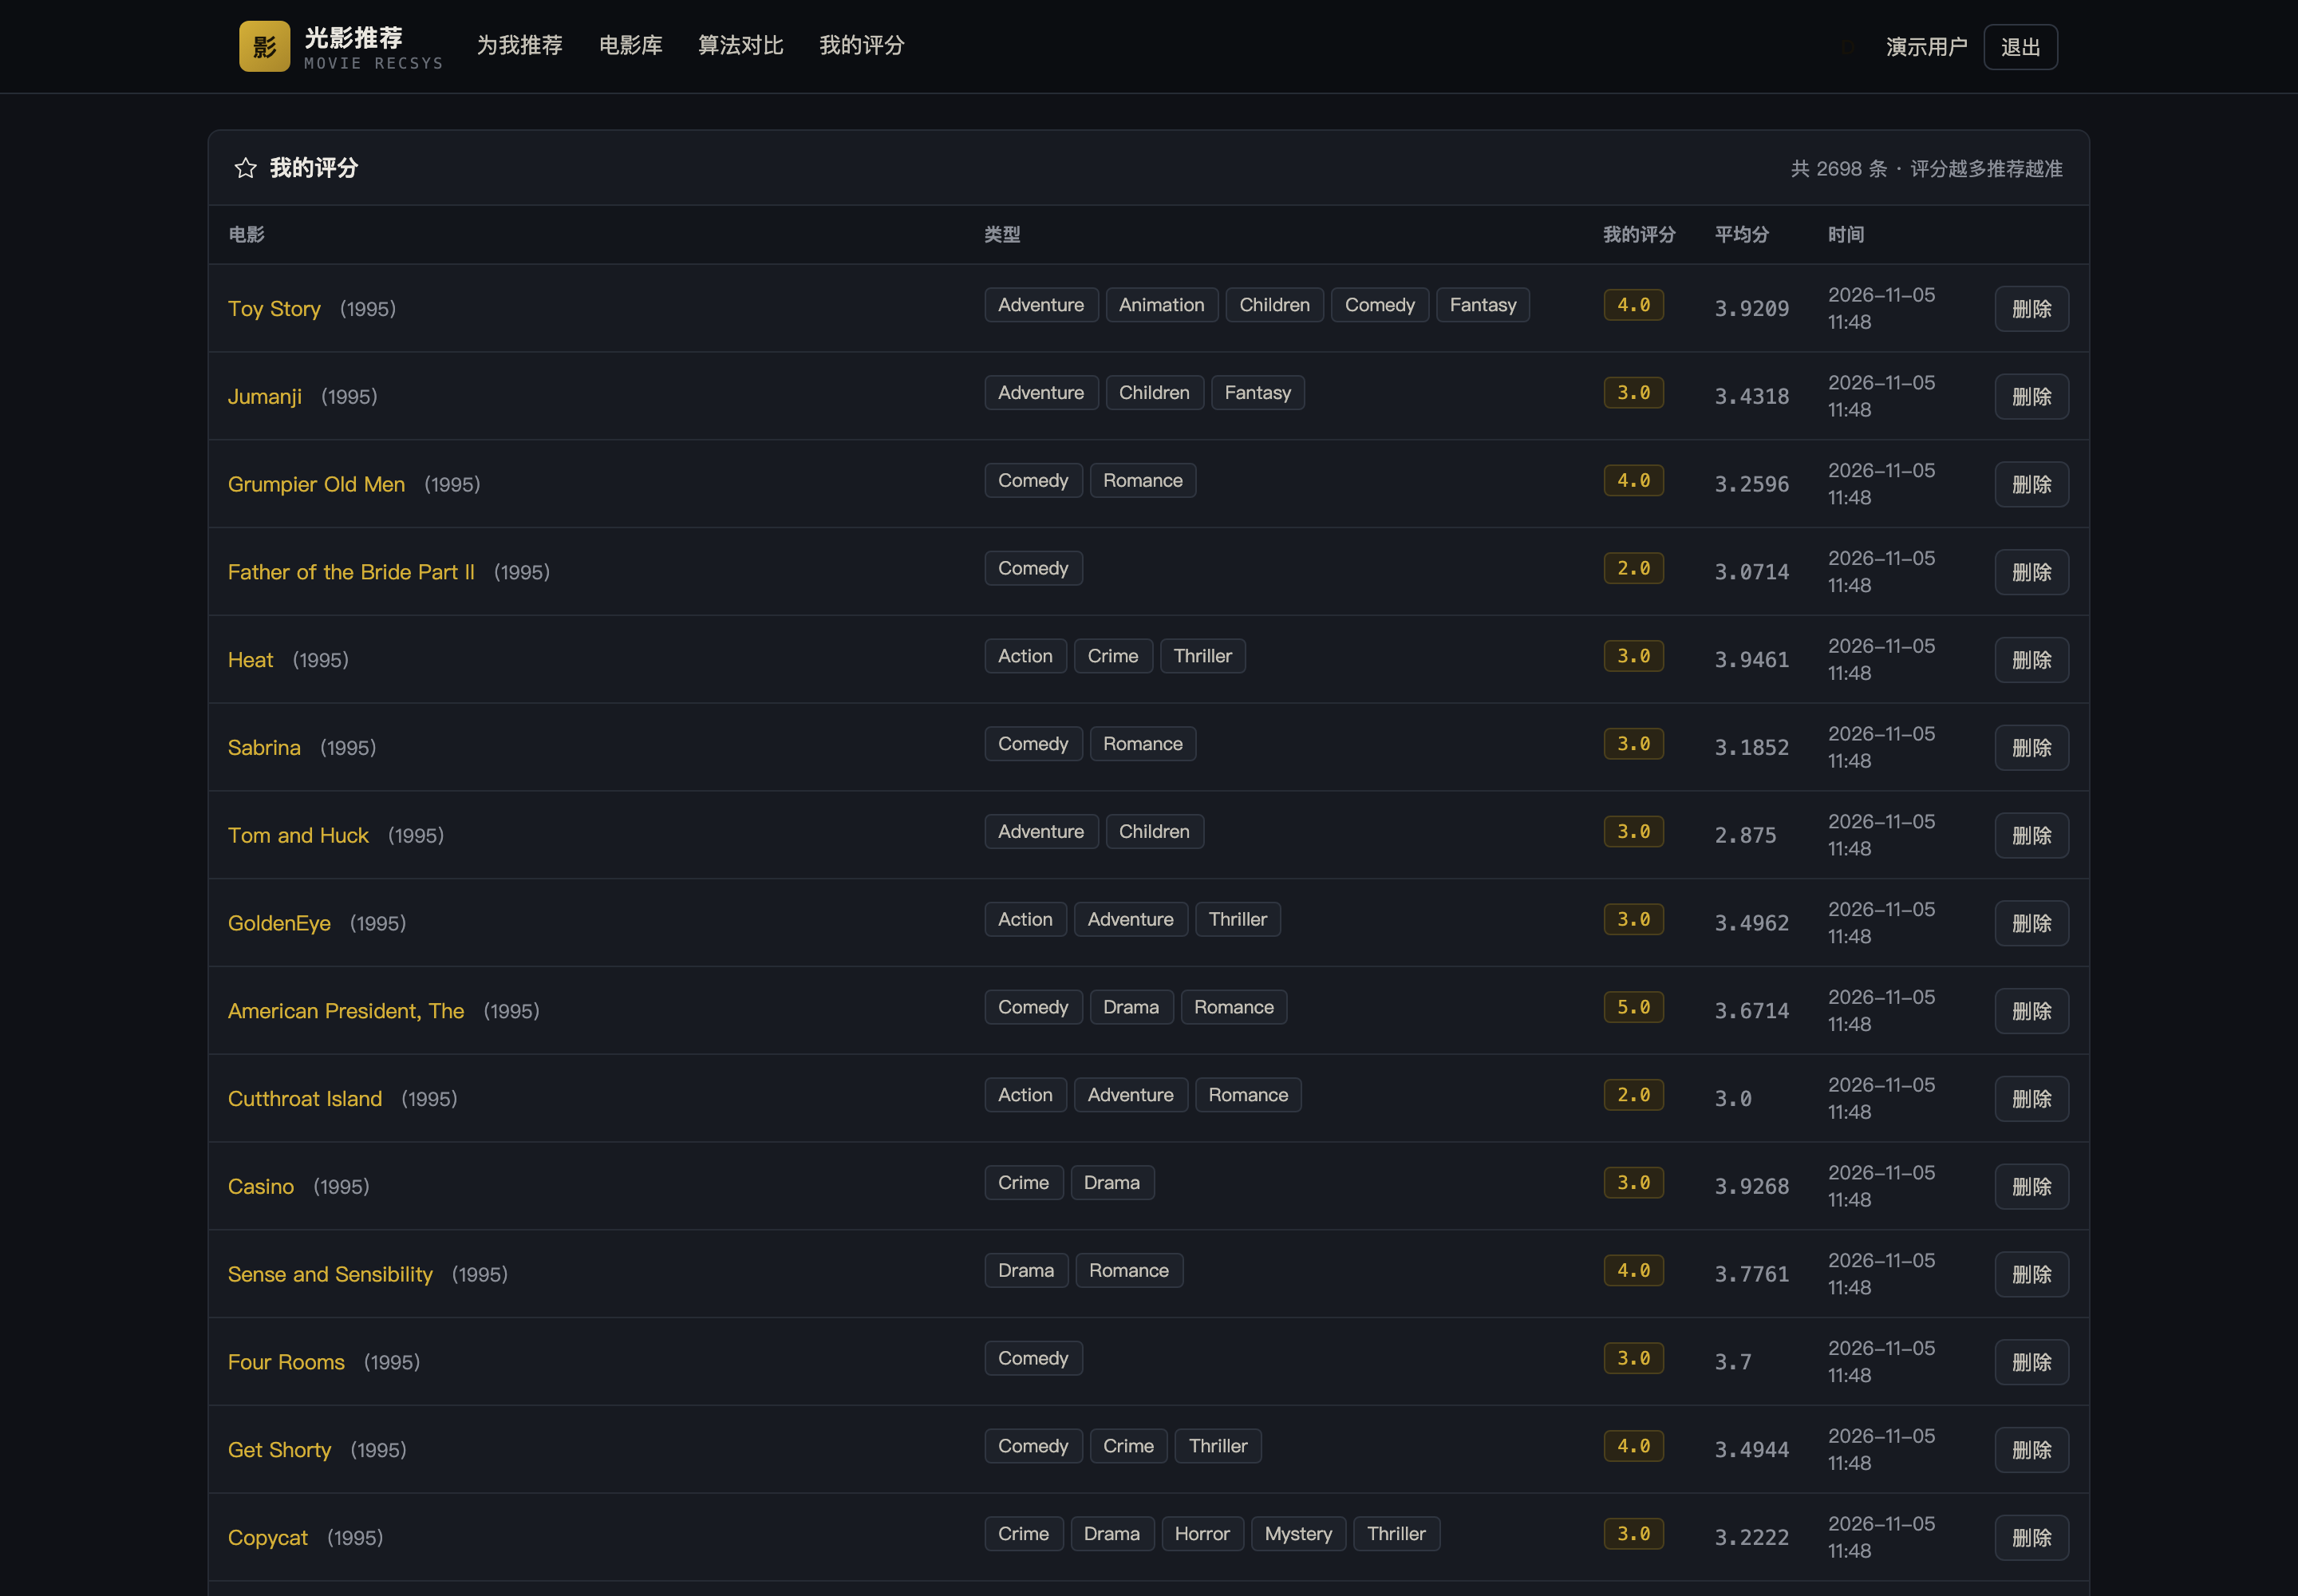
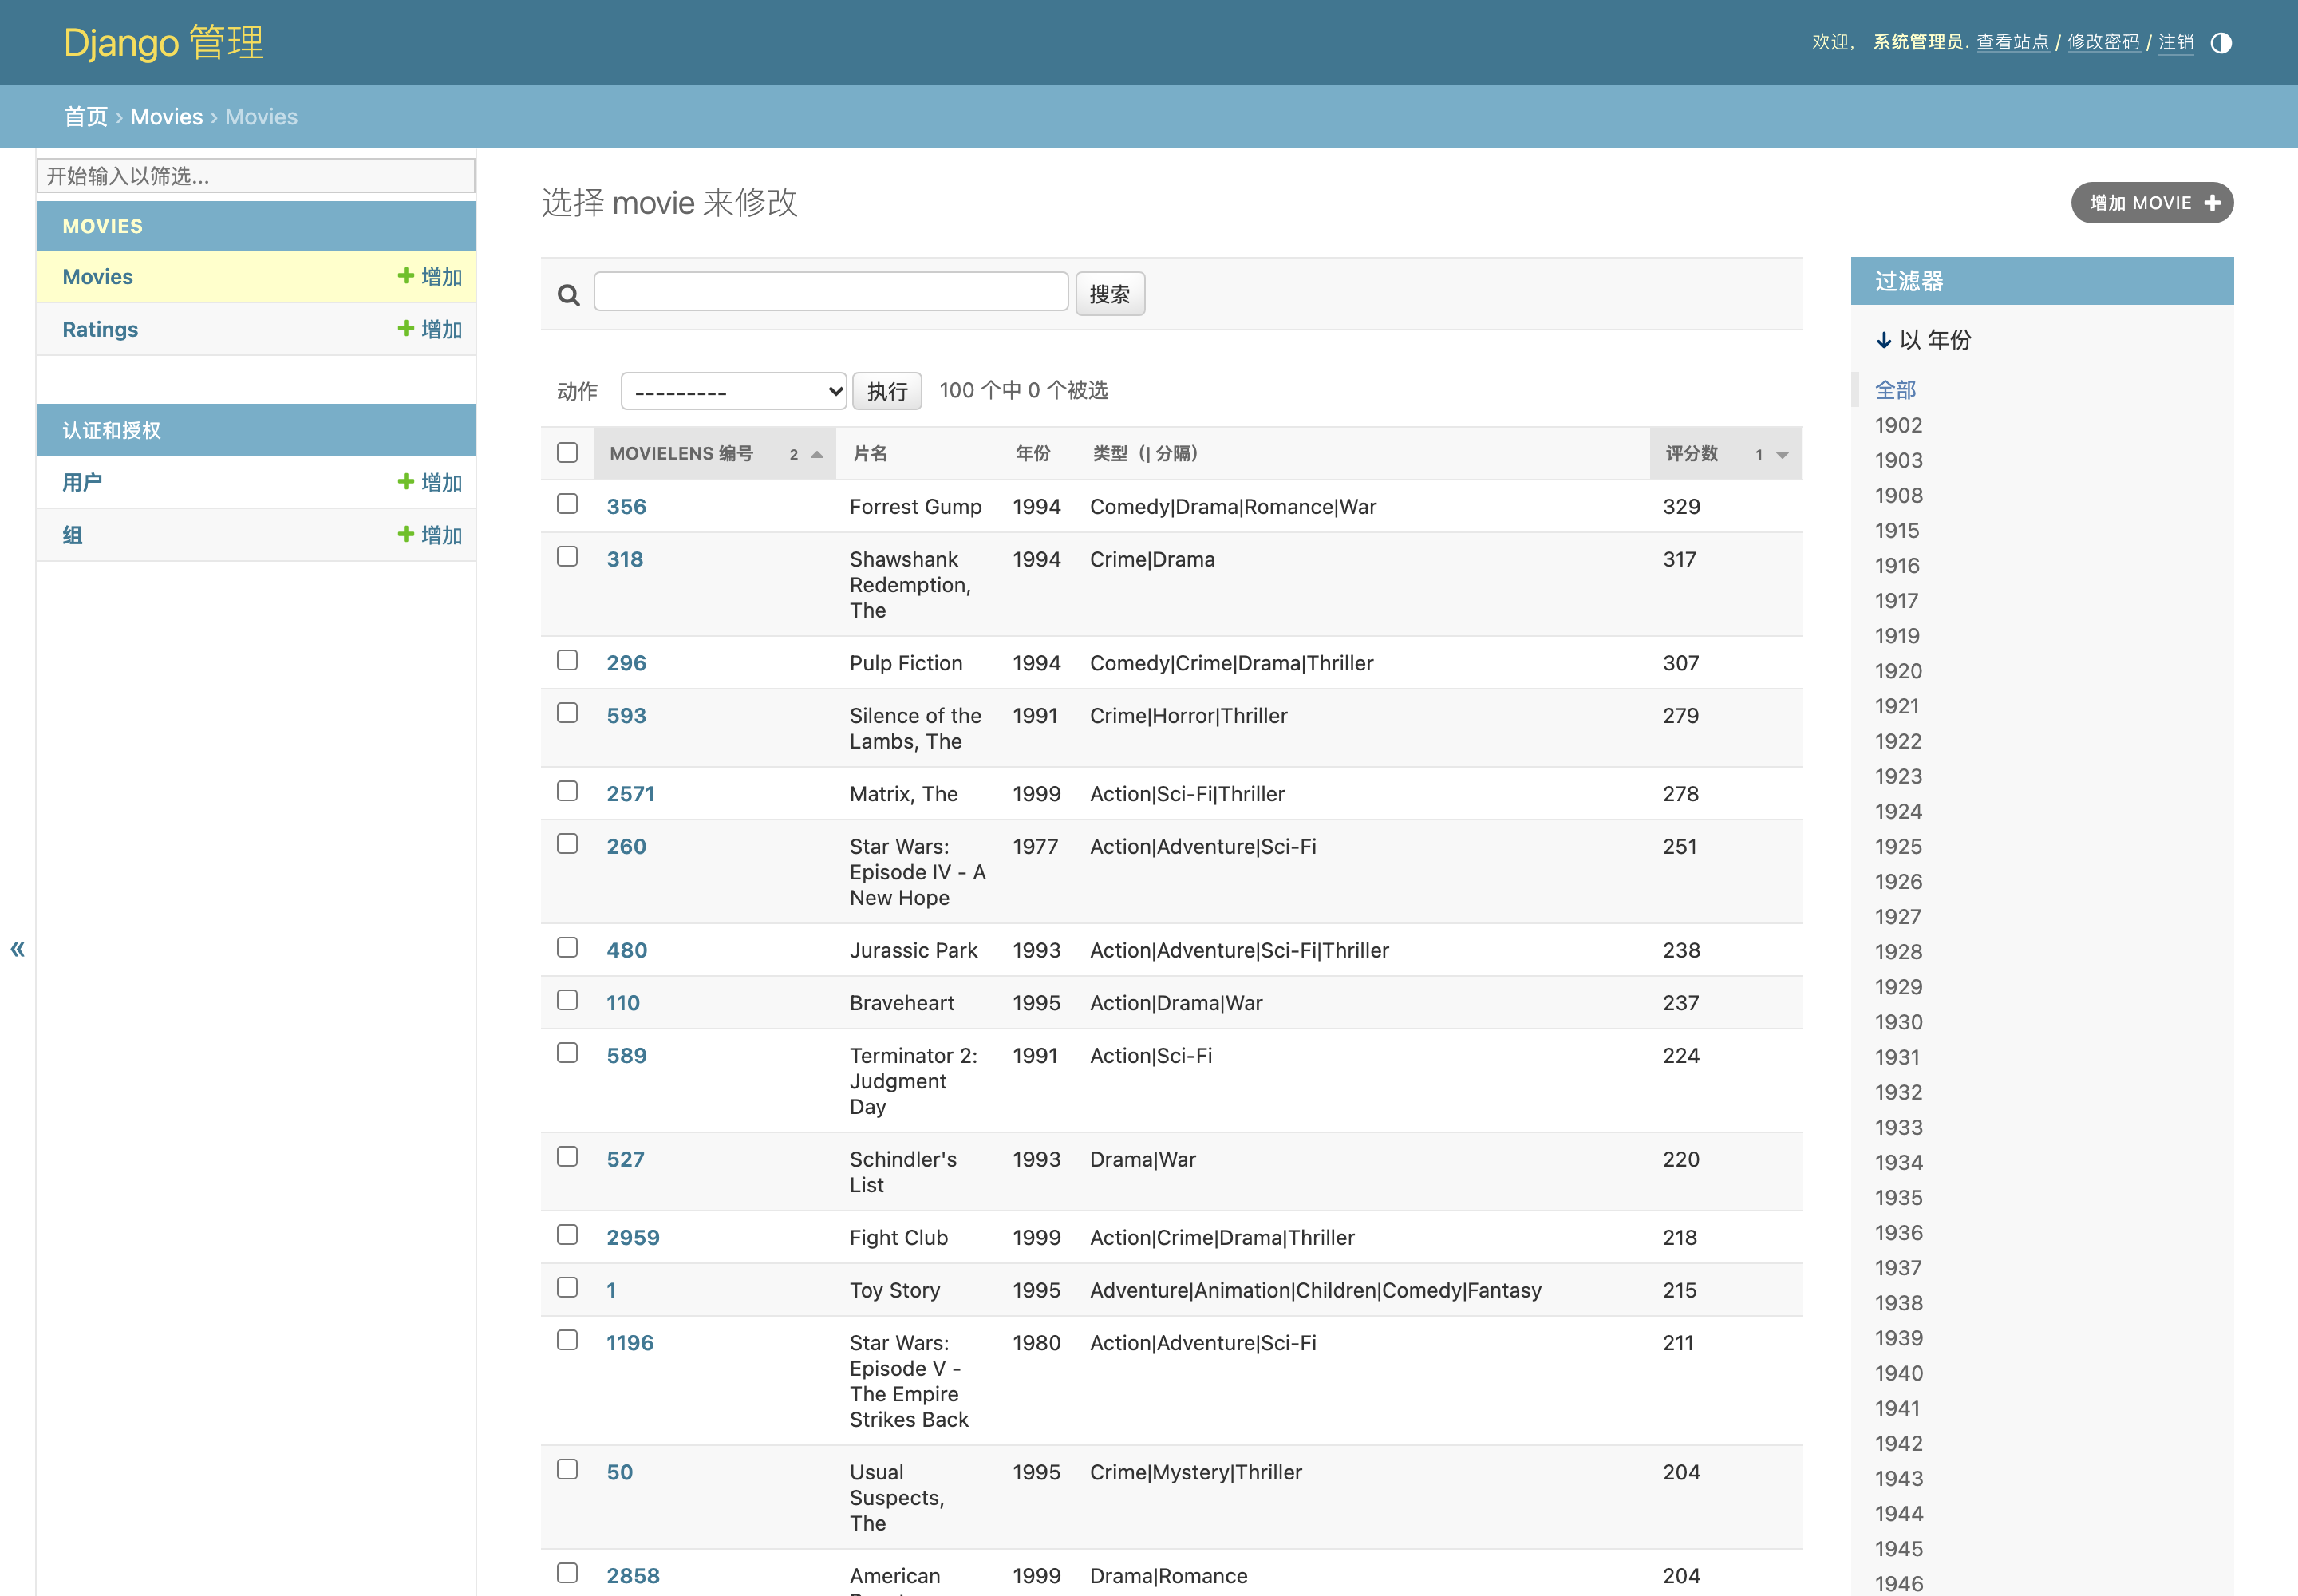
- 电影详情:平均分、评分人数、本站评分分布图、相似电影(ItemCF 副产品)、星级打分
- 工程实现:NumPy 手写算法(无第三方推荐库);矩阵与相似度进程内缓存、评分后失效重建
交付内容
- 完整源码(已跑通,Django 工程 + 三种推荐算法 + 离线评估脚本)
- MovieLens 原始数据(movies.csv / ratings.csv)与演示数据库(含电影、评分与演示账号)
- 离线评估报告 rec/artifacts/metrics.json(页面直接读取,保证指标可复现)
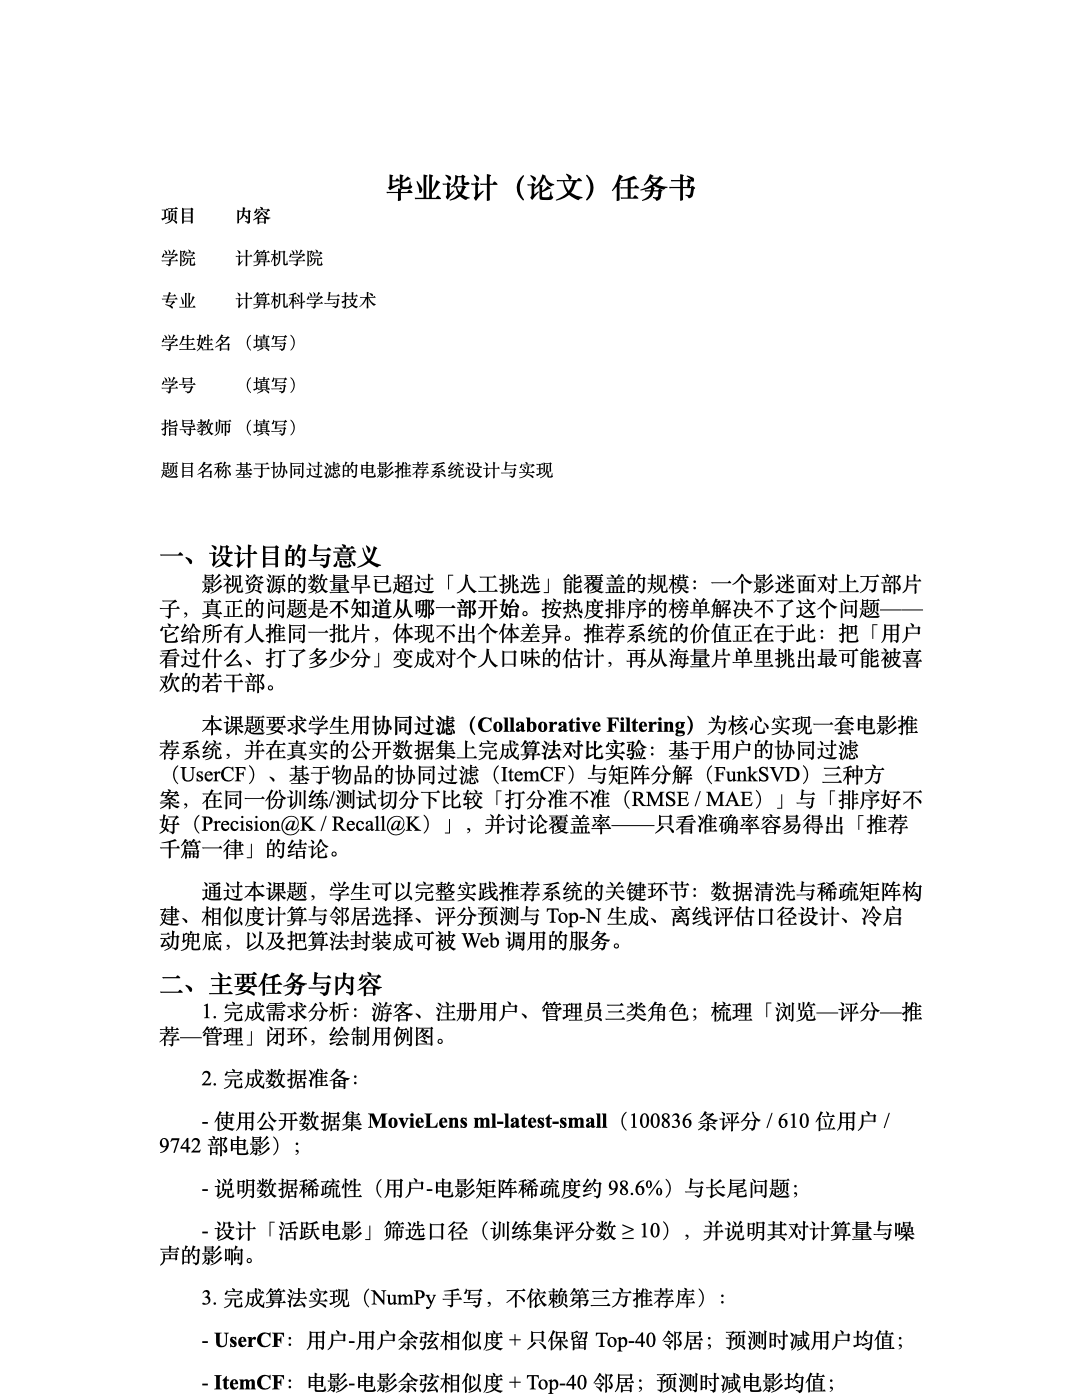
- 毕业设计任务书(Word)
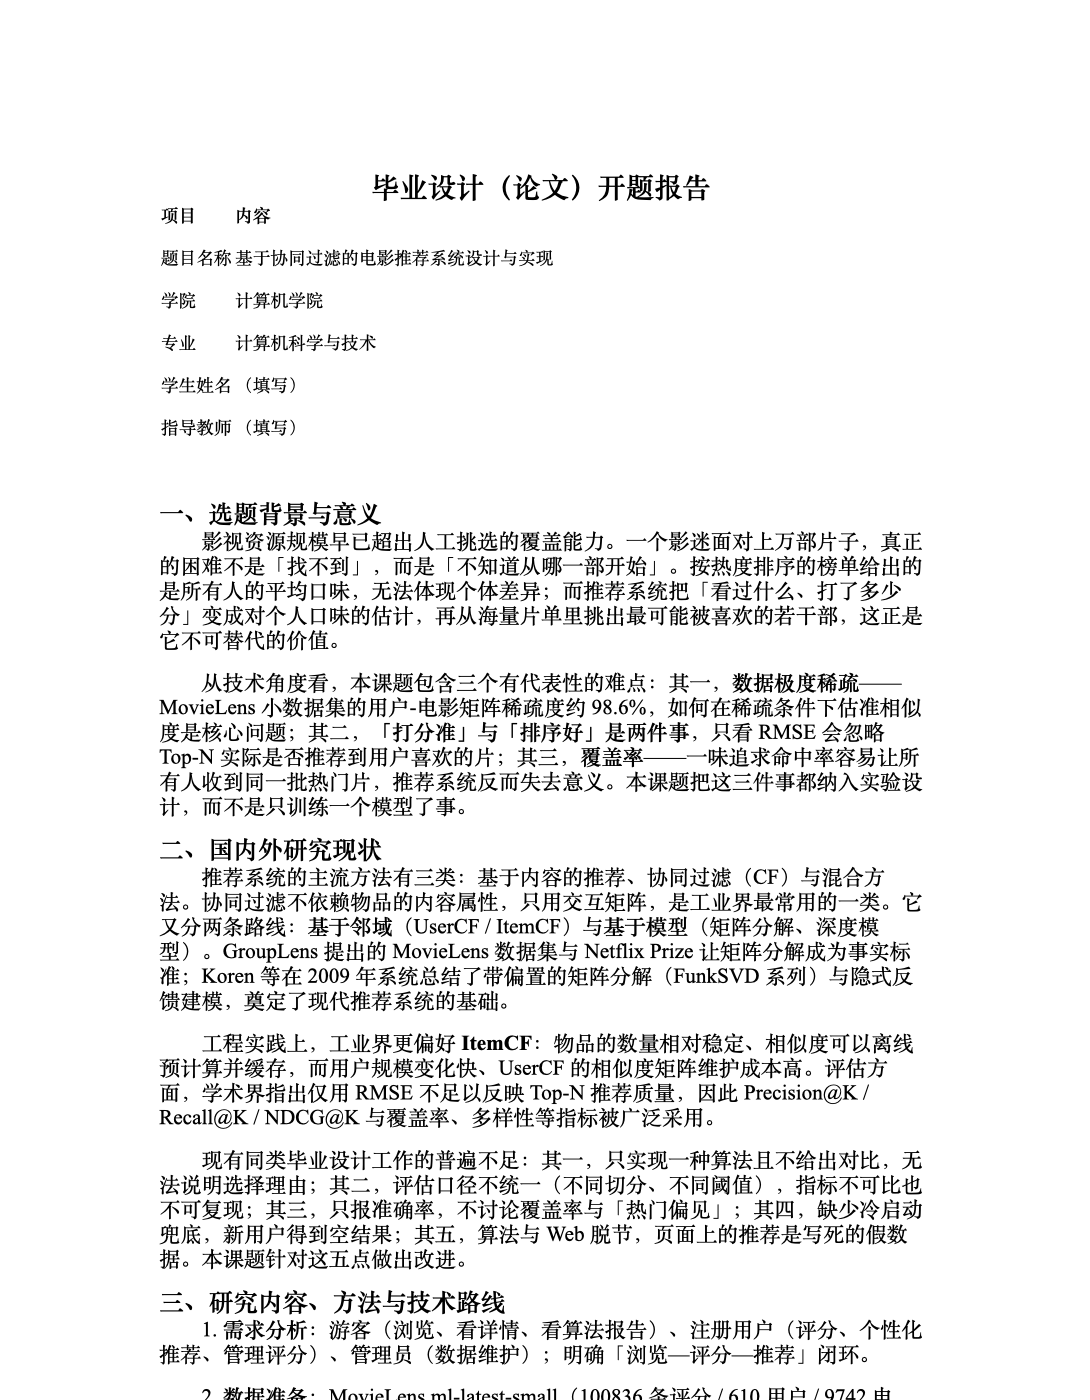
- 开题报告(Word)
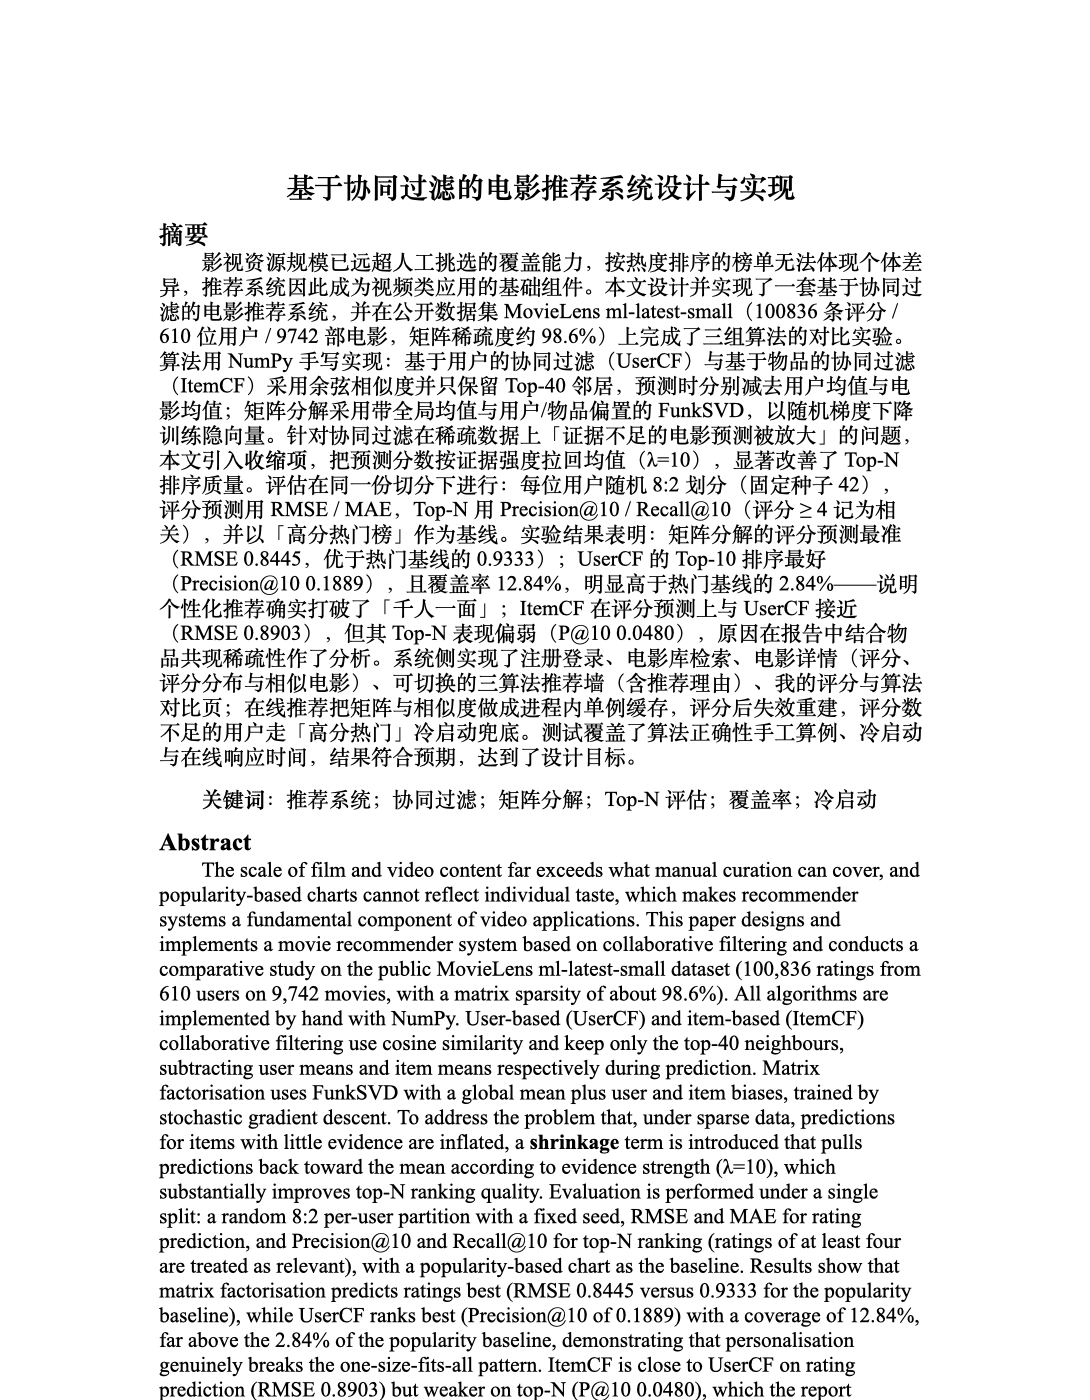
- 毕业论文(Word,七章制,含对比实验与收缩项分析)
- 系统使用与二次开发说明(Word + md)
- 11 张系统运行截图
最终成品目录结构
下面是交付包里的真实目录,共 72 个文件。只展示文件名,不含文件内容; 点击文件夹可逐层展开,看到每个模块是怎么拆分的。
界面截图
点击任意一张可放大,支持左右切换(也可用键盘 ← → 键)
文档预览
交付的任务书、开题报告与论文均为 Word 文档,下面是真实页面预览;点击可放大并左右切换:
常见问题
项目能直接跑起来吗?
能。交付包内带演示数据库与 MovieLens 原始数据,安装依赖(Django/NumPy/pandas)后双击一键脚本即可;评估报告也已随包提供。
推荐效果怎么样?
同一份切分下:矩阵分解评分预测最准(RMSE 0.8445),UserCF 的 Top-10 排序最好(Precision@10 0.1889),且覆盖率 12.84%,远高于热门基线的 2.84%。
为什么有两个「最优」?
RMSE 衡量「打分准不准」,Precision@10 衡量「排序好不好」,两者并不同向:矩阵分解优化全量评分的平方误差,长尾误差会稀释排序信号;UserCF 更贴近「相似的人喜欢什么」,所以排序更好。
ItemCF 为什么排序偏弱?
MovieLens 小数据集的物品共现很稀疏,每部电影平均只有几十个评分,能形成稳定共现的物品很少,邻居质量不稳定;但它的评分预测(RMSE 0.8903)仍与 UserCF 接近。
收缩项是做什么的?
邻域方法在稀疏数据上会被「只与少数电影高度相似」的低证据电影放大预测。加收缩项 score = mean + Σ(sim·Δ)/(Σ|sim| + λ)(λ=10)后按证据强度拉回均值,Top-N 排序质量大幅改善。
新用户没有评分怎么办?
评分数少于 5 条时走「高分热门」冷启动兜底(评分数 ≥ 50 且平均分靠前),并提示多评几部,不会返回空列表。
数据是真的吗?
电影与评分来自公开数据集 MovieLens ml-latest-small(GroupLens),原始 CSV 随包提供,可自行核对与复现。
能换数据集或算法吗?
能。换 data/raw 下的 movies.csv 与 ratings.csv(保持列名)后重跑 seed_data 与 train_rec;加算法在 rec/engine.py 实现后在 evaluate.py 与 service.py 注册即可。