基于 Django 的 B 站弹幕情感分析系统设计与实现
项目简介
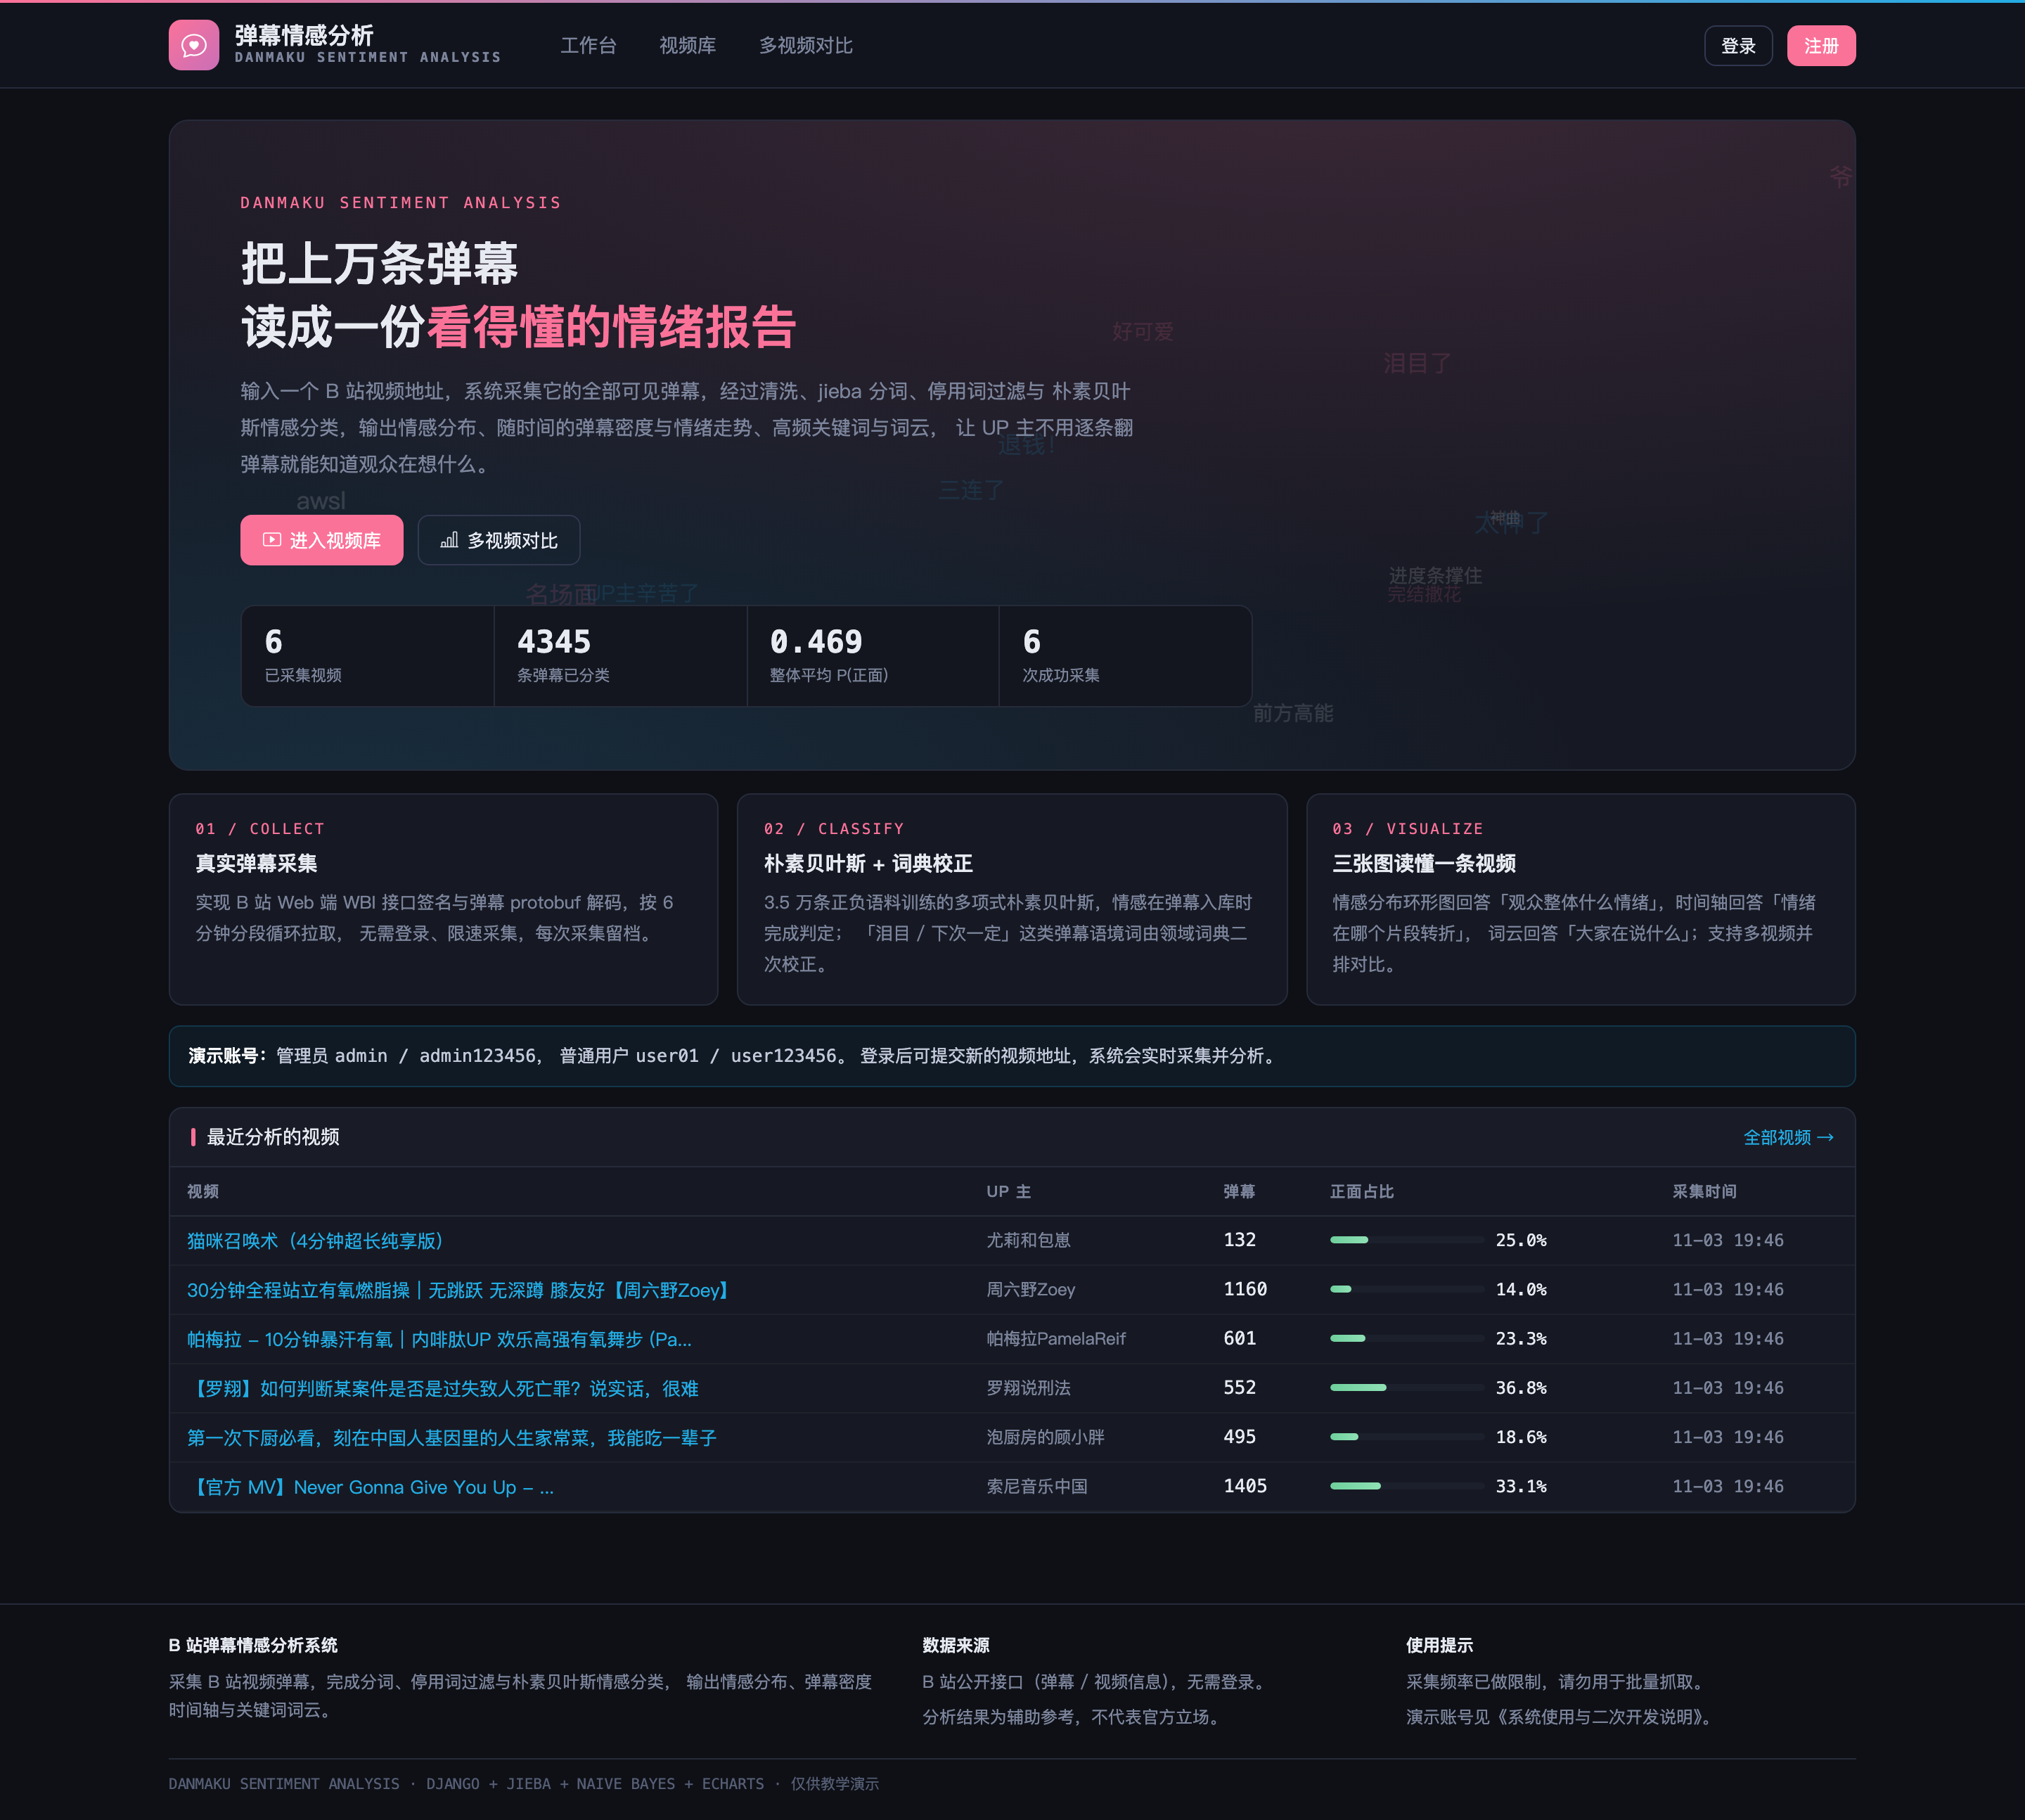
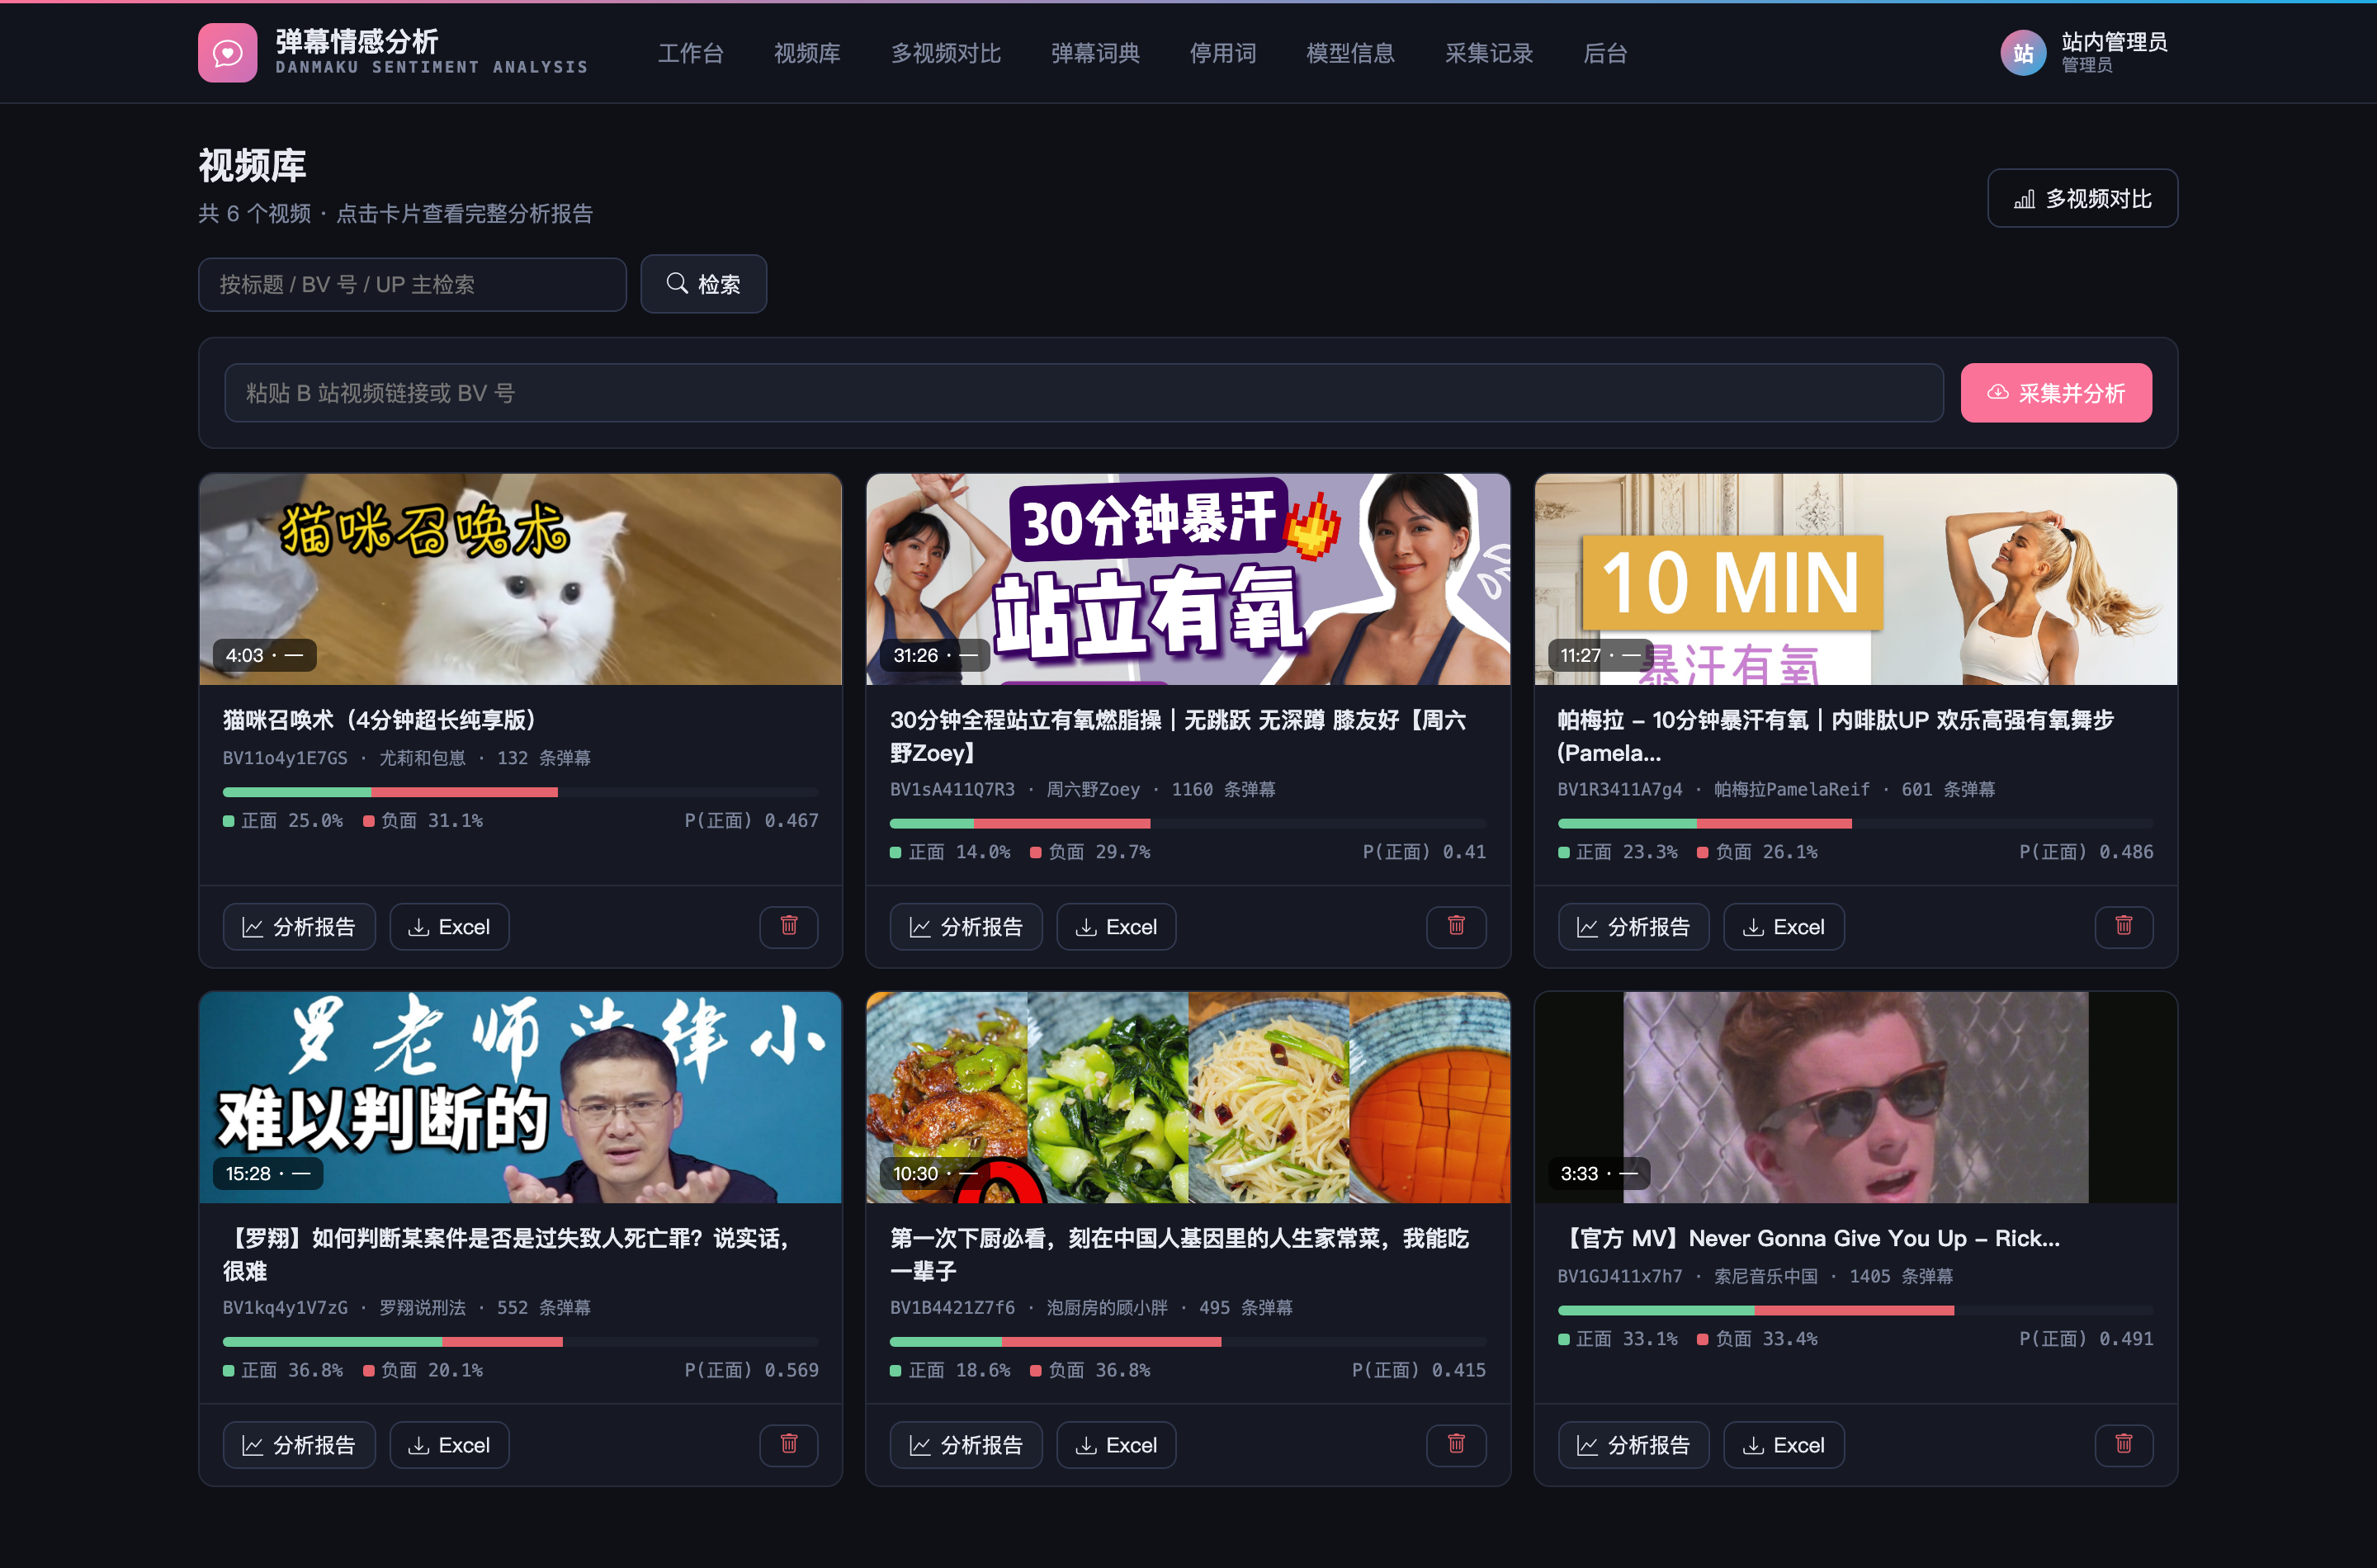
面向 UP 主与内容研究者的弹幕情感分析系统:粘贴 B 站视频地址即可采集其全部可见弹幕(自实现 WBI 接口签名与 protobuf 解码,无需登录),经清洗、jieba 分词、停用词过滤与朴素贝叶斯情感分类,输出情感分布、弹幕密度与情绪时间轴、高频关键词与词云;弹幕语境词由可维护的情感词典二次校正,支持多视频对比与 Excel 导出。
演示视频
视频也可在 B 站视频页 观看
运行环境
| 编程语言 | Python 3.8 及以上 |
|---|---|
| Web 框架 | Django 4.2 |
| 中文分词 | jieba |
| 情感分类 | 多项式朴素贝叶斯(纯 Python 自实现,模型随包交付) |
| 数据采集 | B 站公开接口(自实现 WBI 签名与 protobuf 解码,无需登录) |
| 数据库 | MySQL 5.7 及以上(交付默认 SQLite,免安装) |
| 可视化 | ECharts 5 + wordcloud(已内置本地文件,离线可用) |
| 报表导出 | openpyxl |
| 操作系统 | Windows / macOS / Linux |
| 启动方式 | 双击一键脚本,或 python manage.py runserver |
功能模块
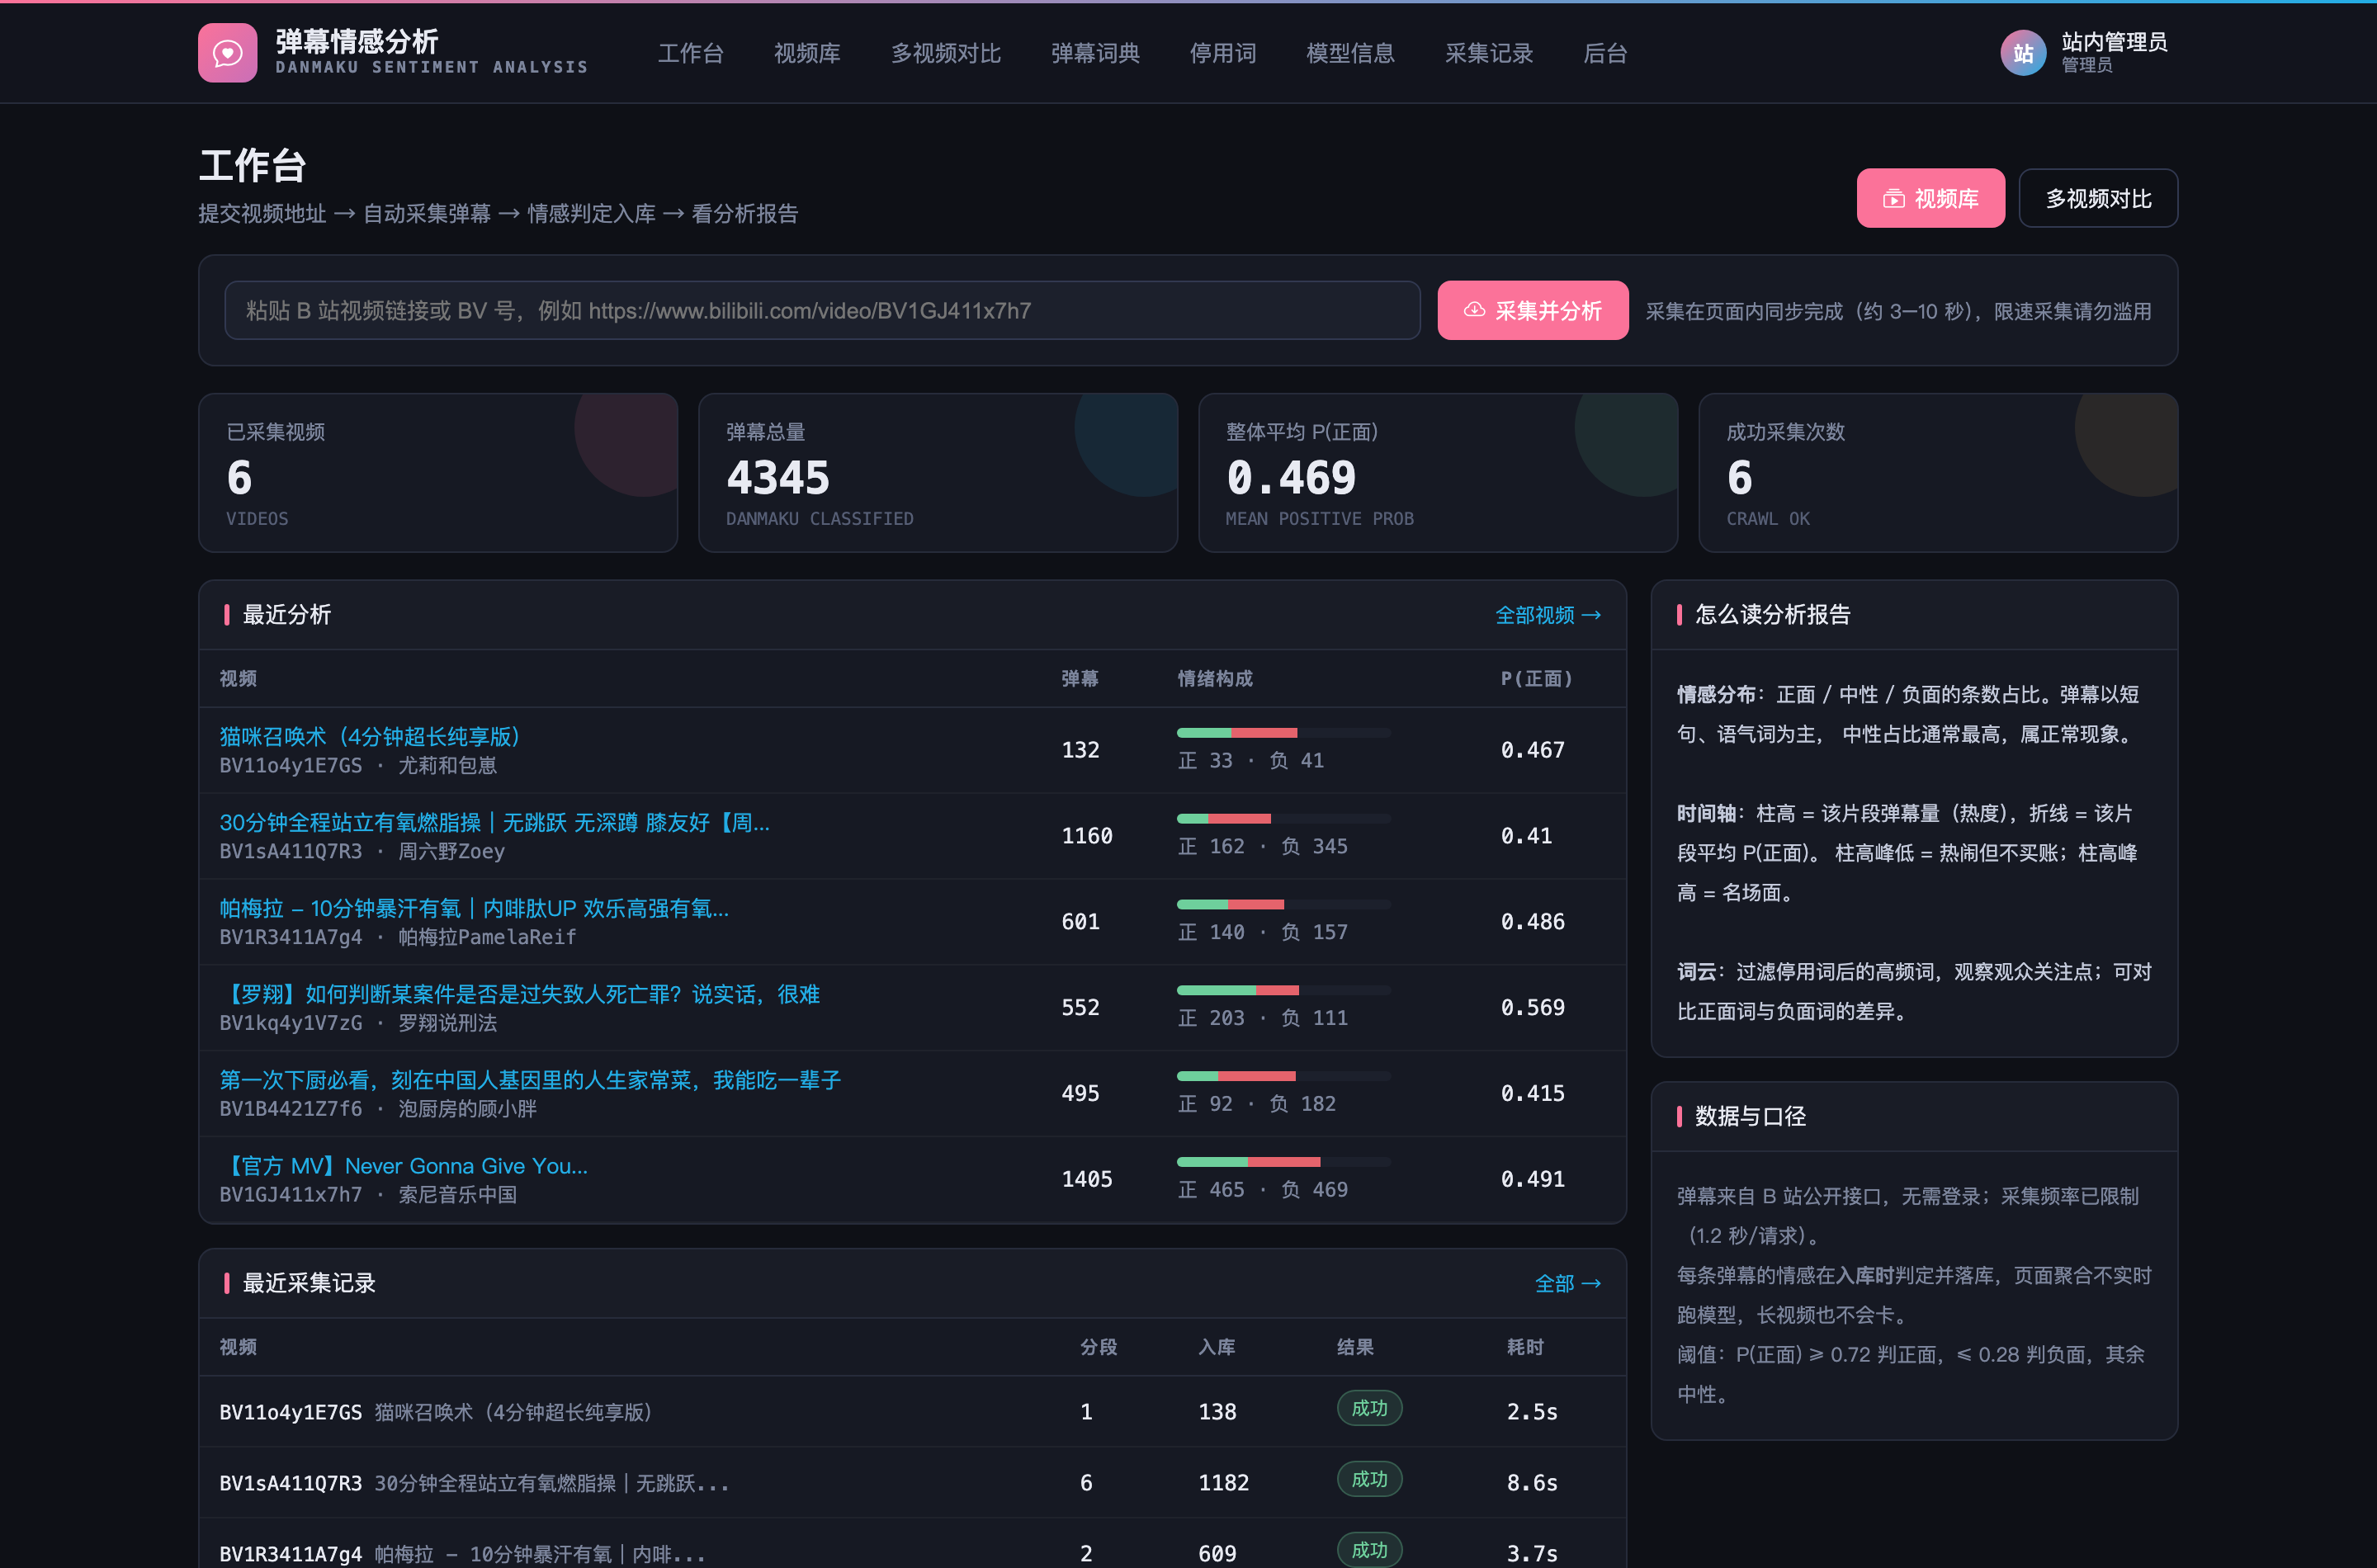
- 真实弹幕采集:自实现 B 站 WBI 接口签名与弹幕 protobuf 解码,无需登录,按 6 分钟分段限速拉取
- 朴素贝叶斯情感分类:3.5 万条正负语料训练(纯 Python 实现,拉普拉斯平滑),模型随包交付
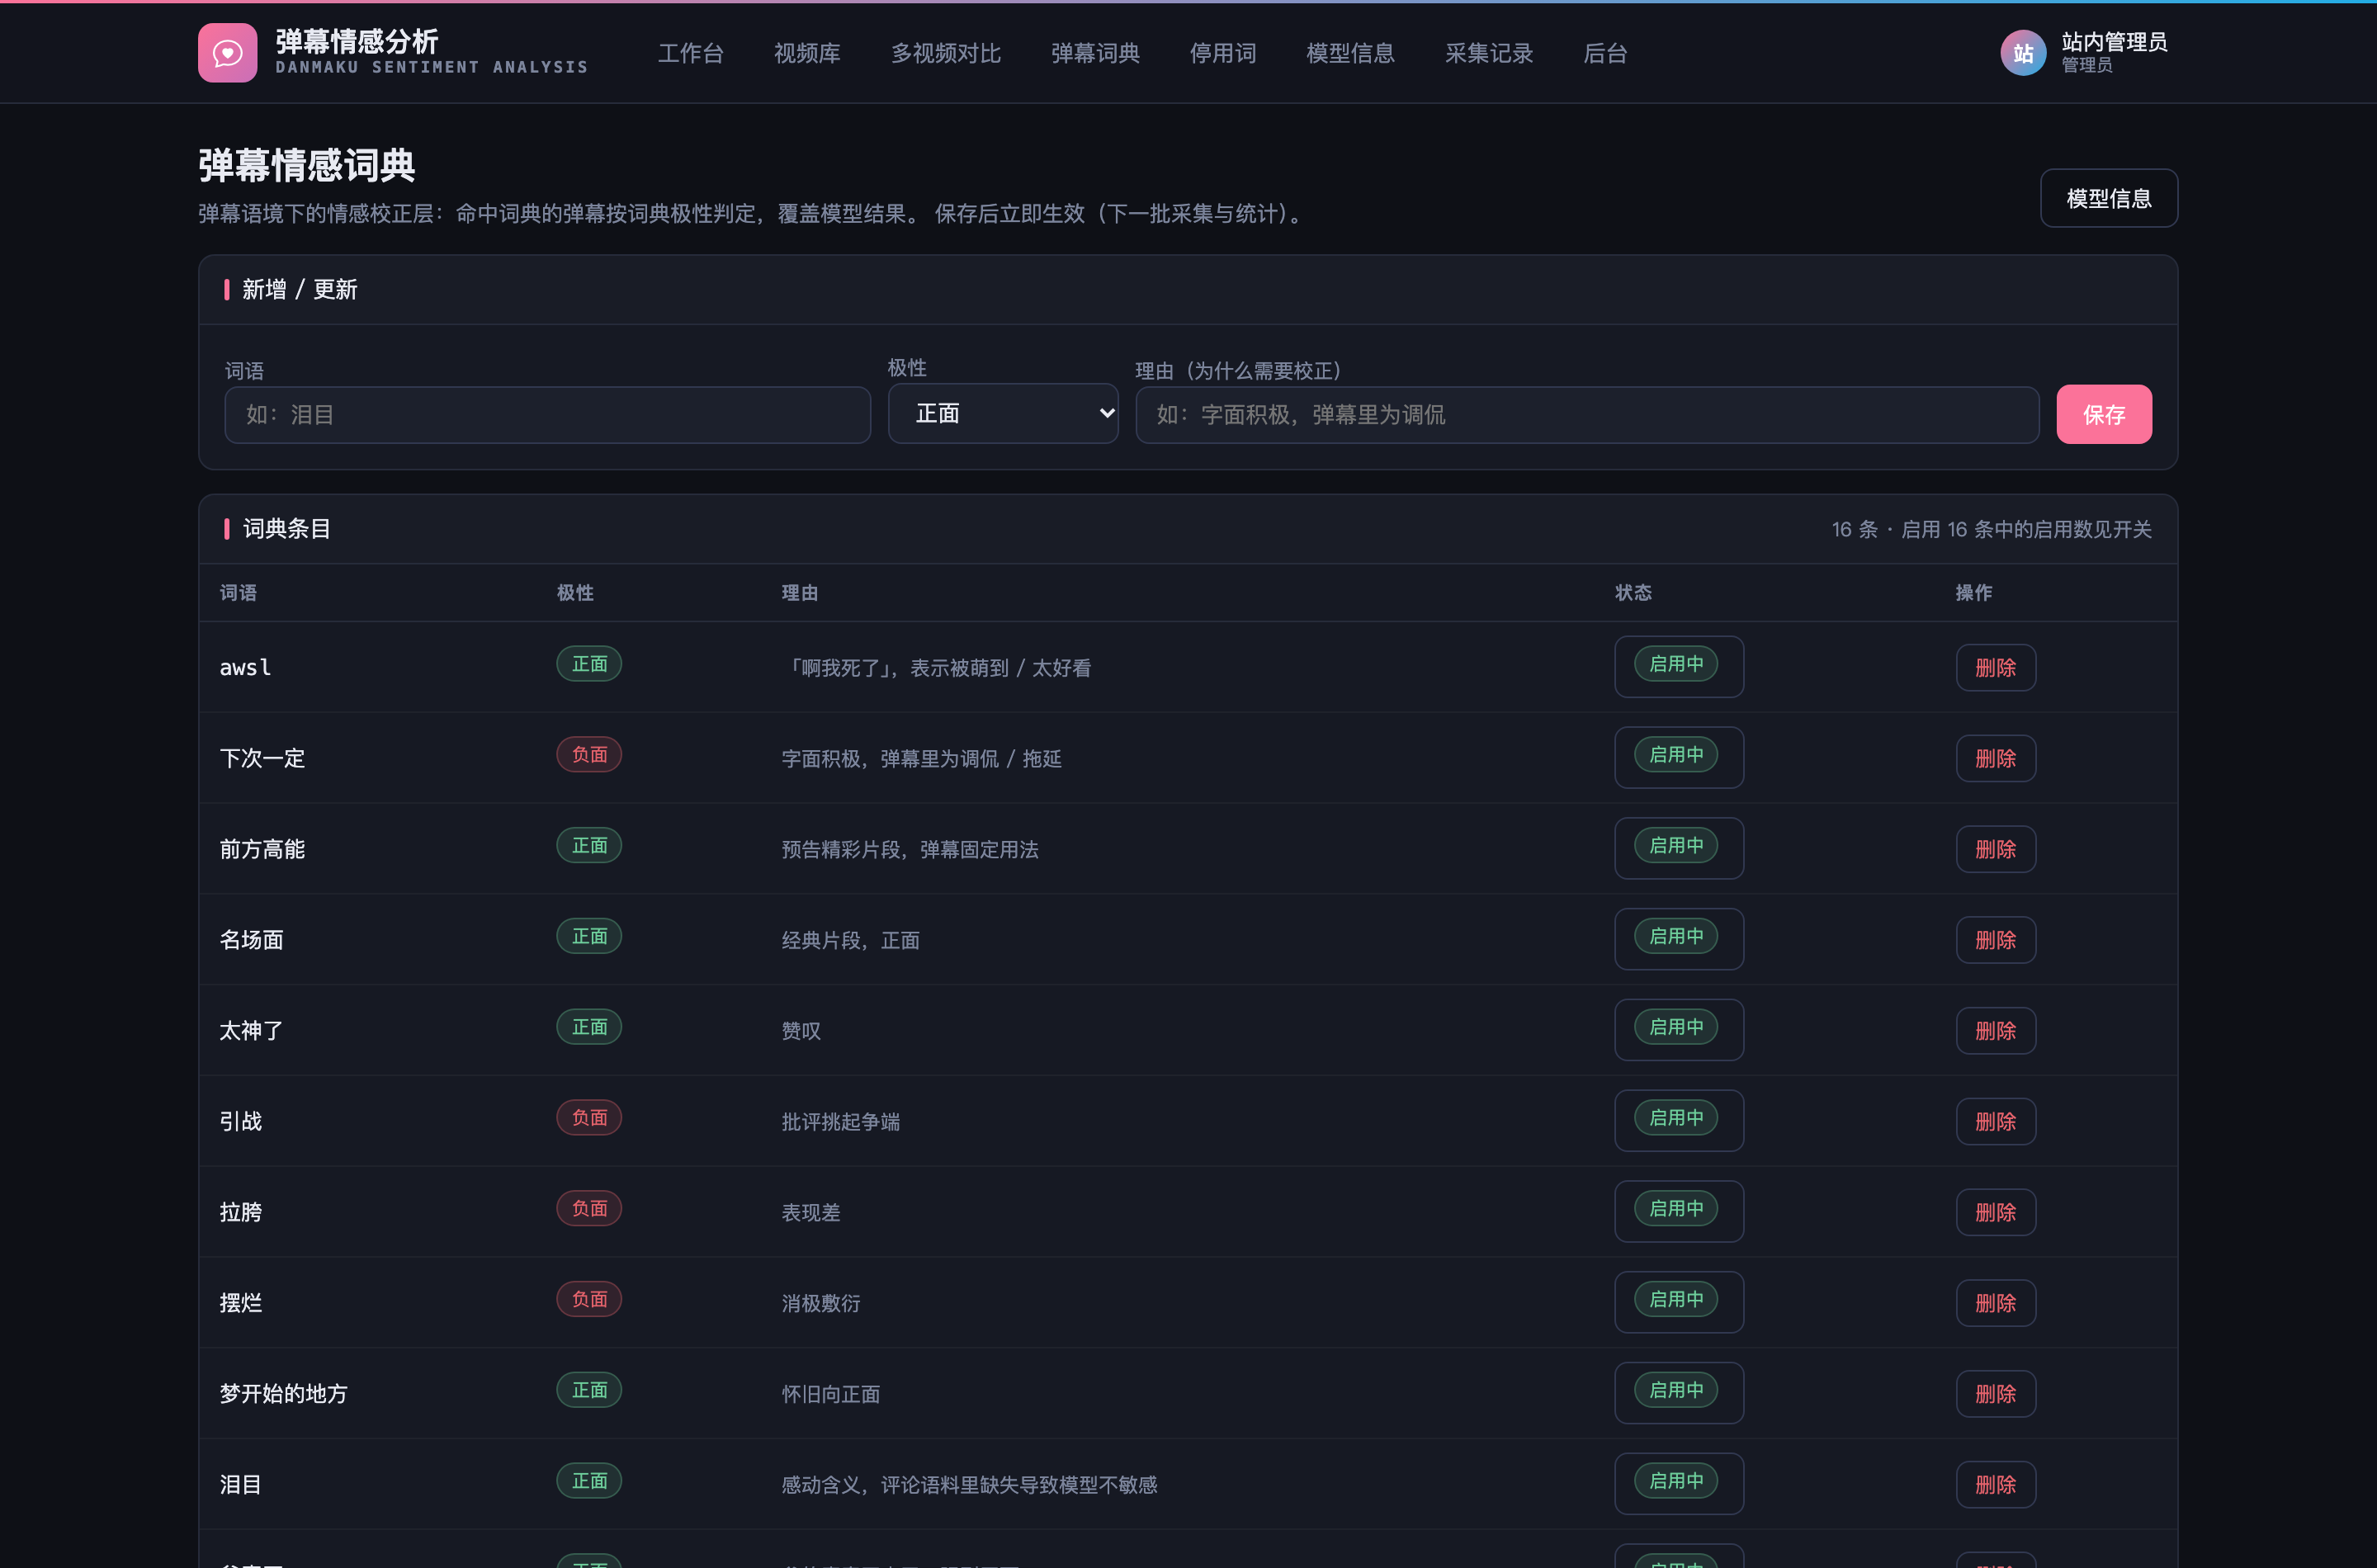
- 弹幕情感词典校正层:「泪目 / 下次一定」等弹幕语境词按人工极性覆盖模型结果,规则带理由可维护
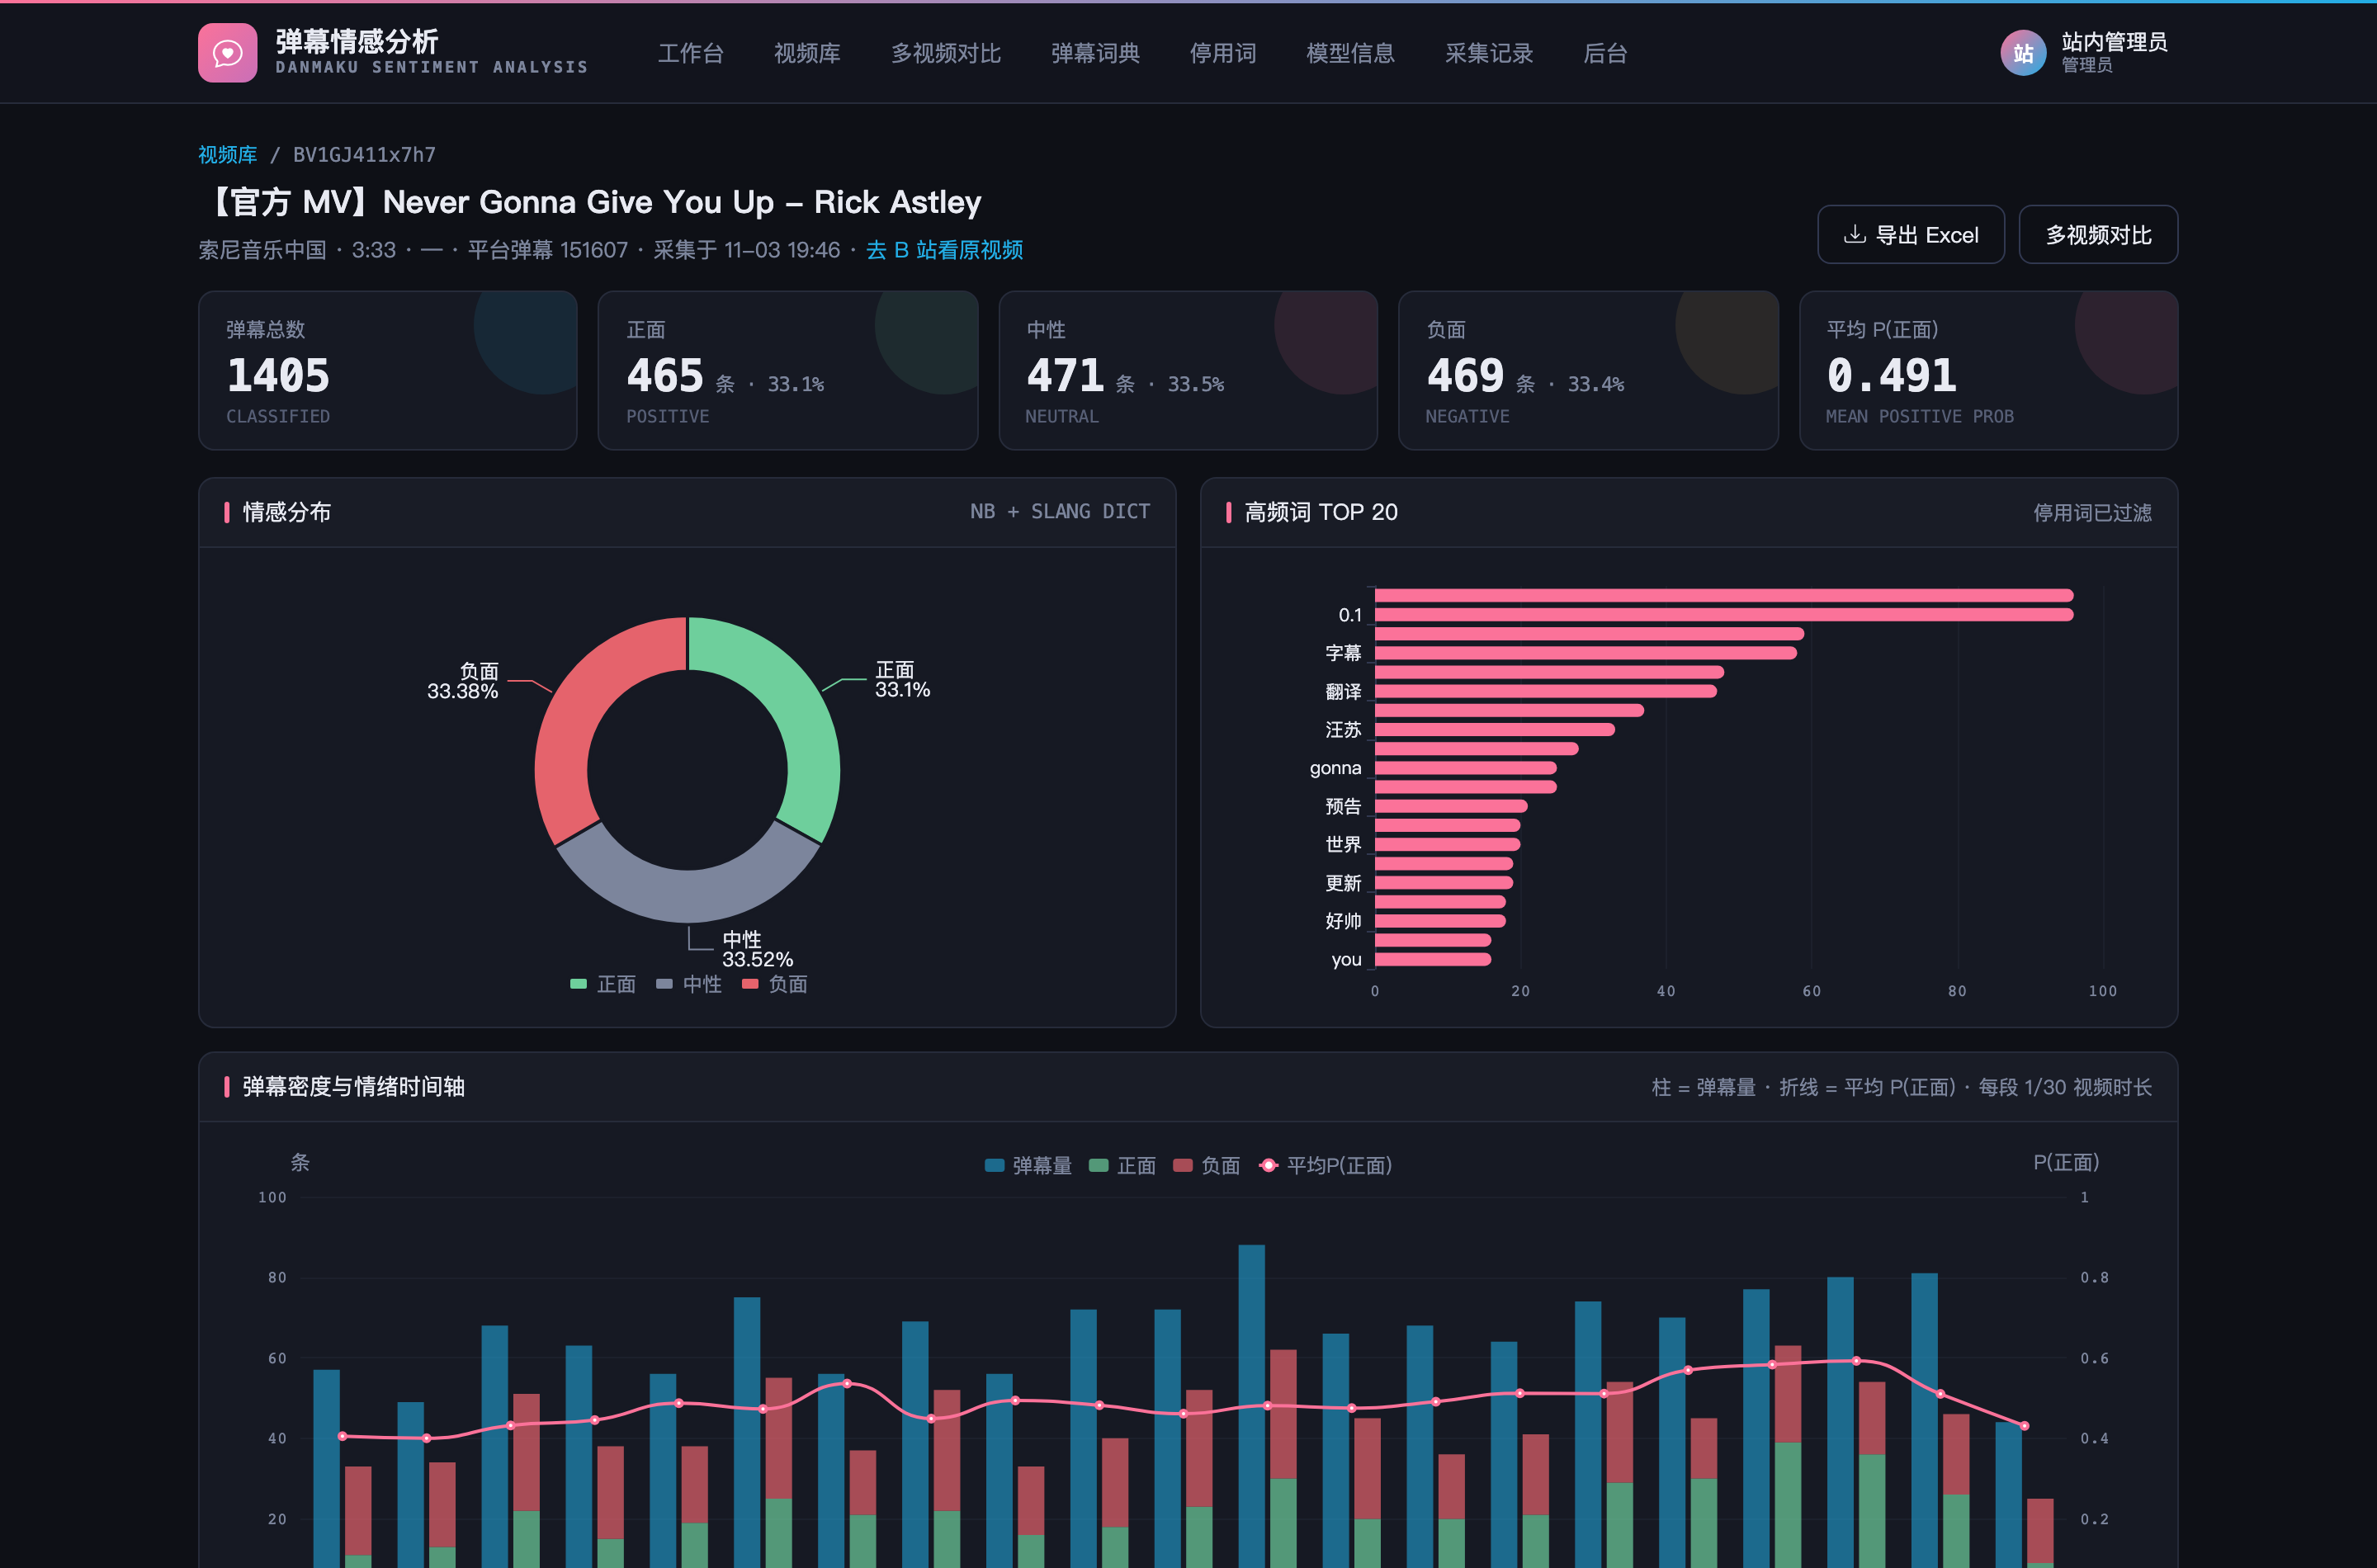
- 分析报告:情感分布环形图、弹幕密度 + 情绪双轴时间轴、高频词 TOP20、关键词词云
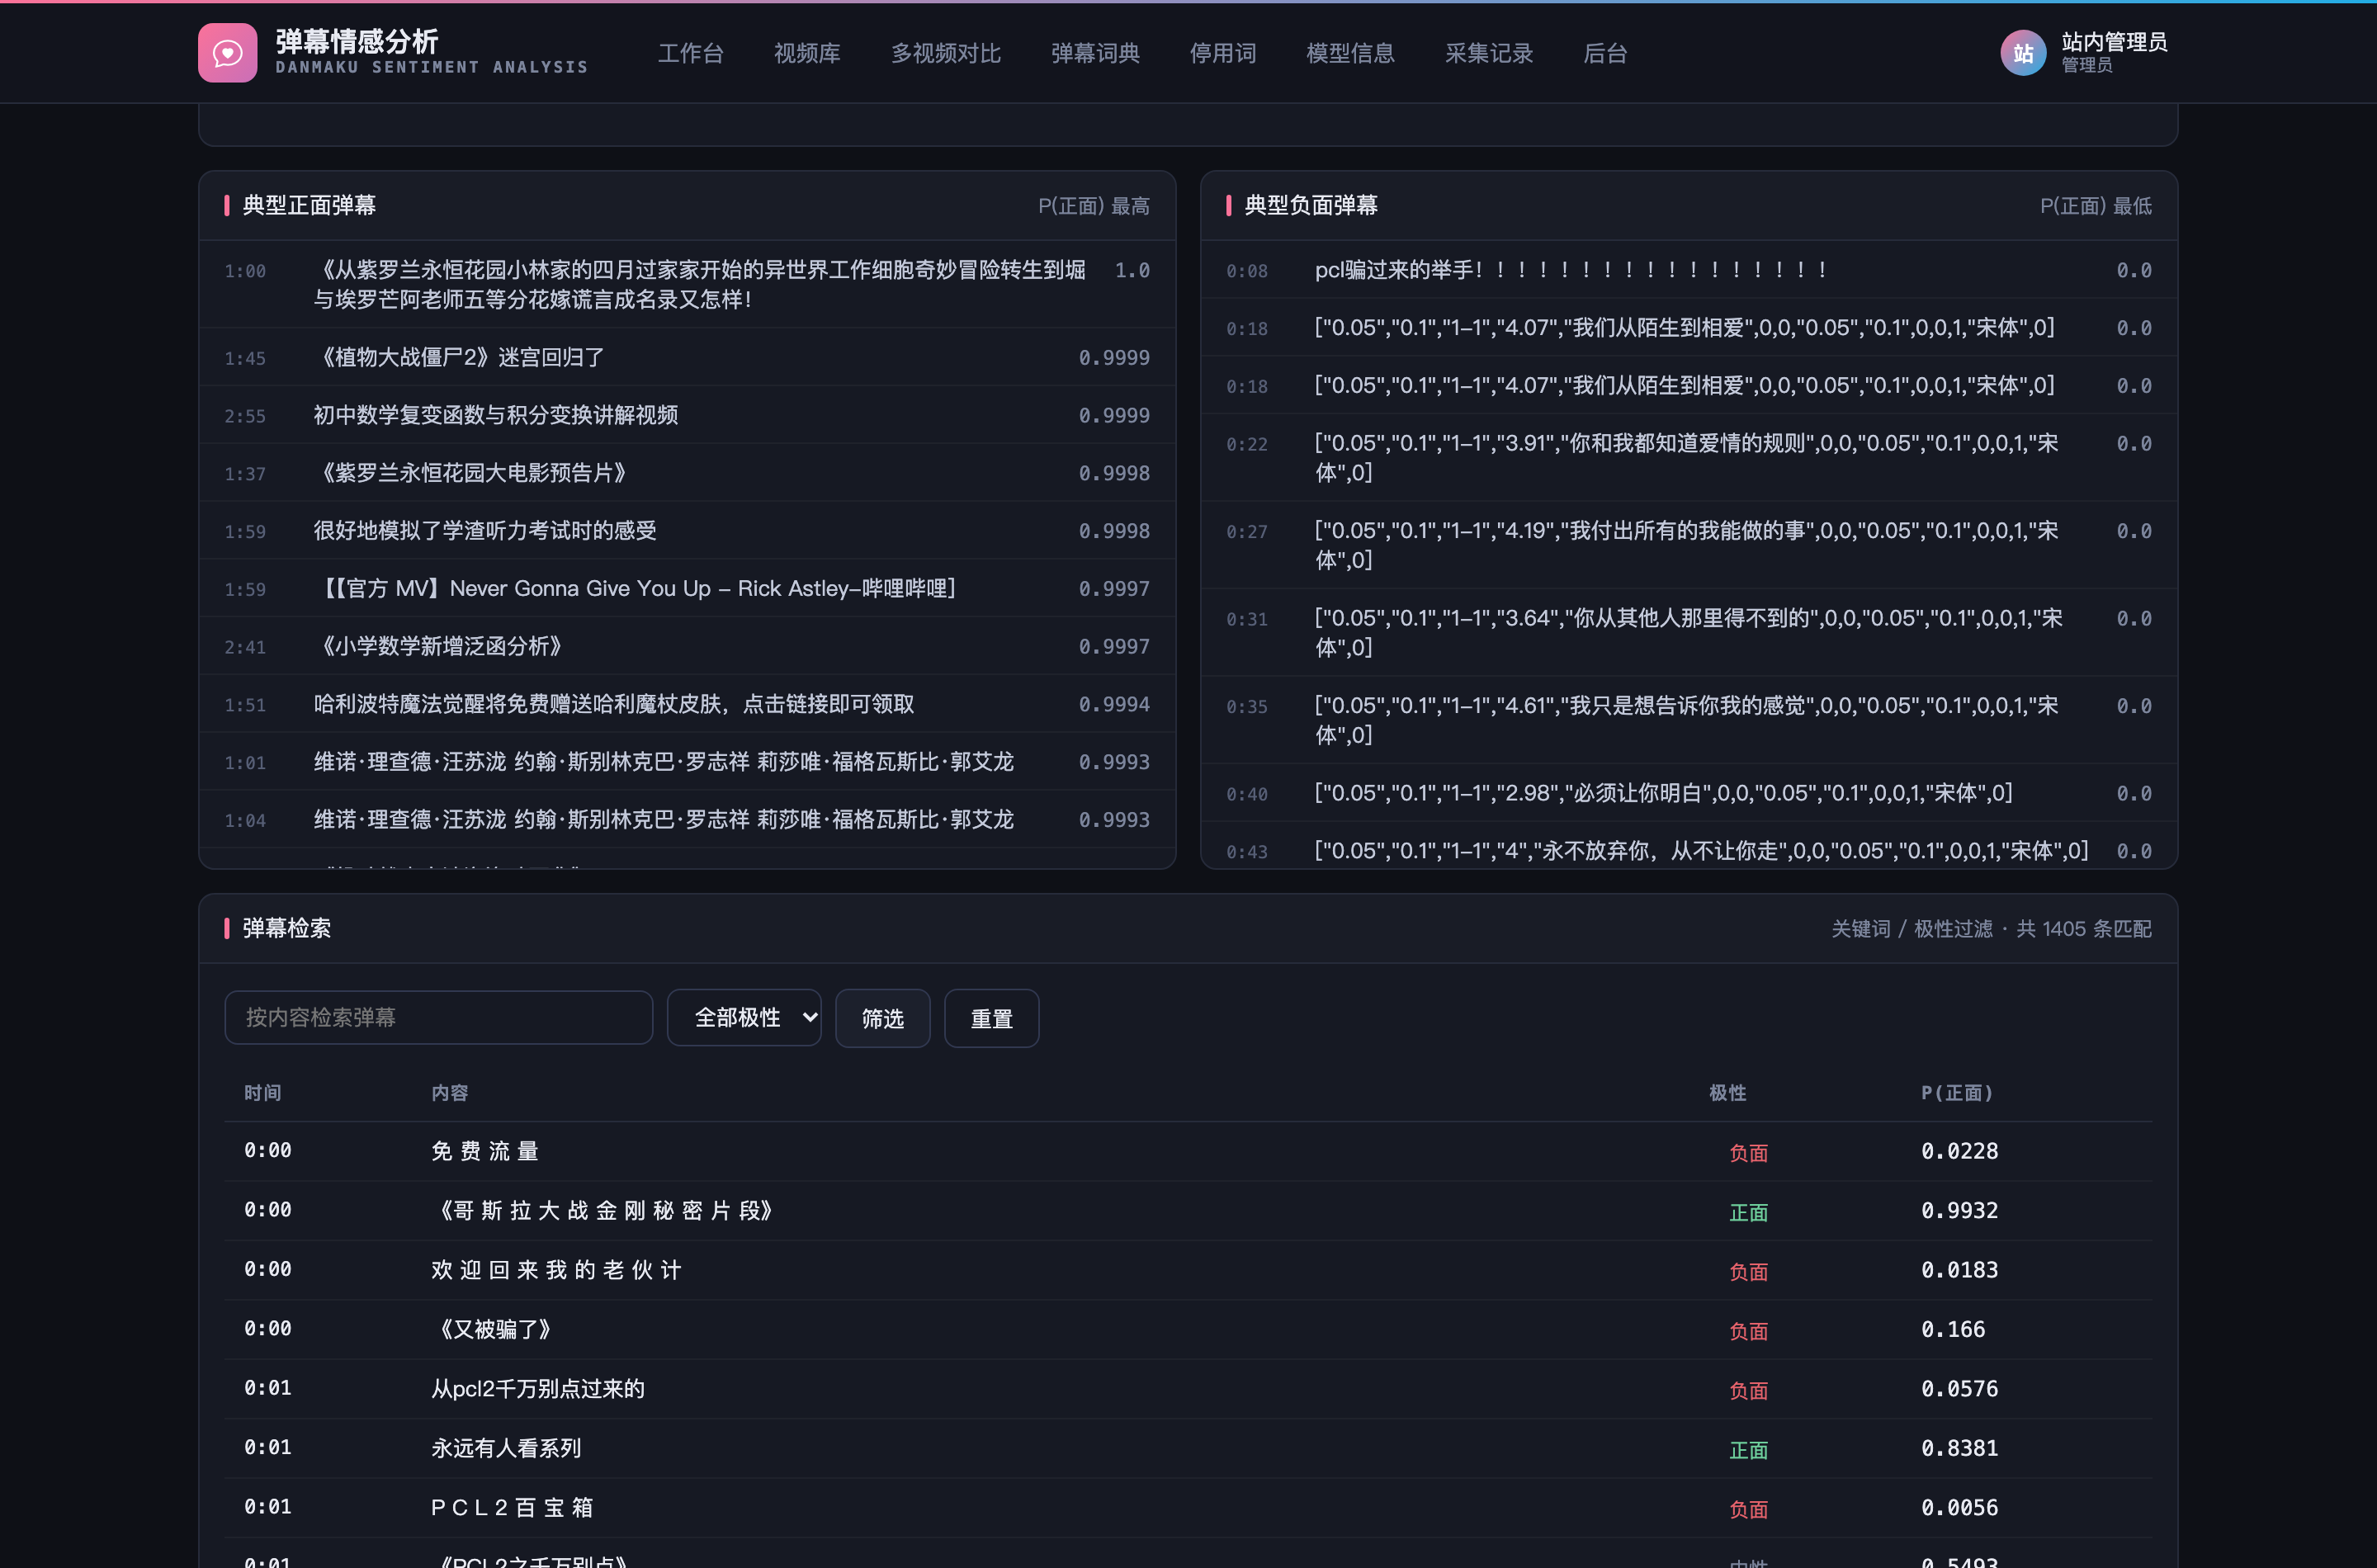
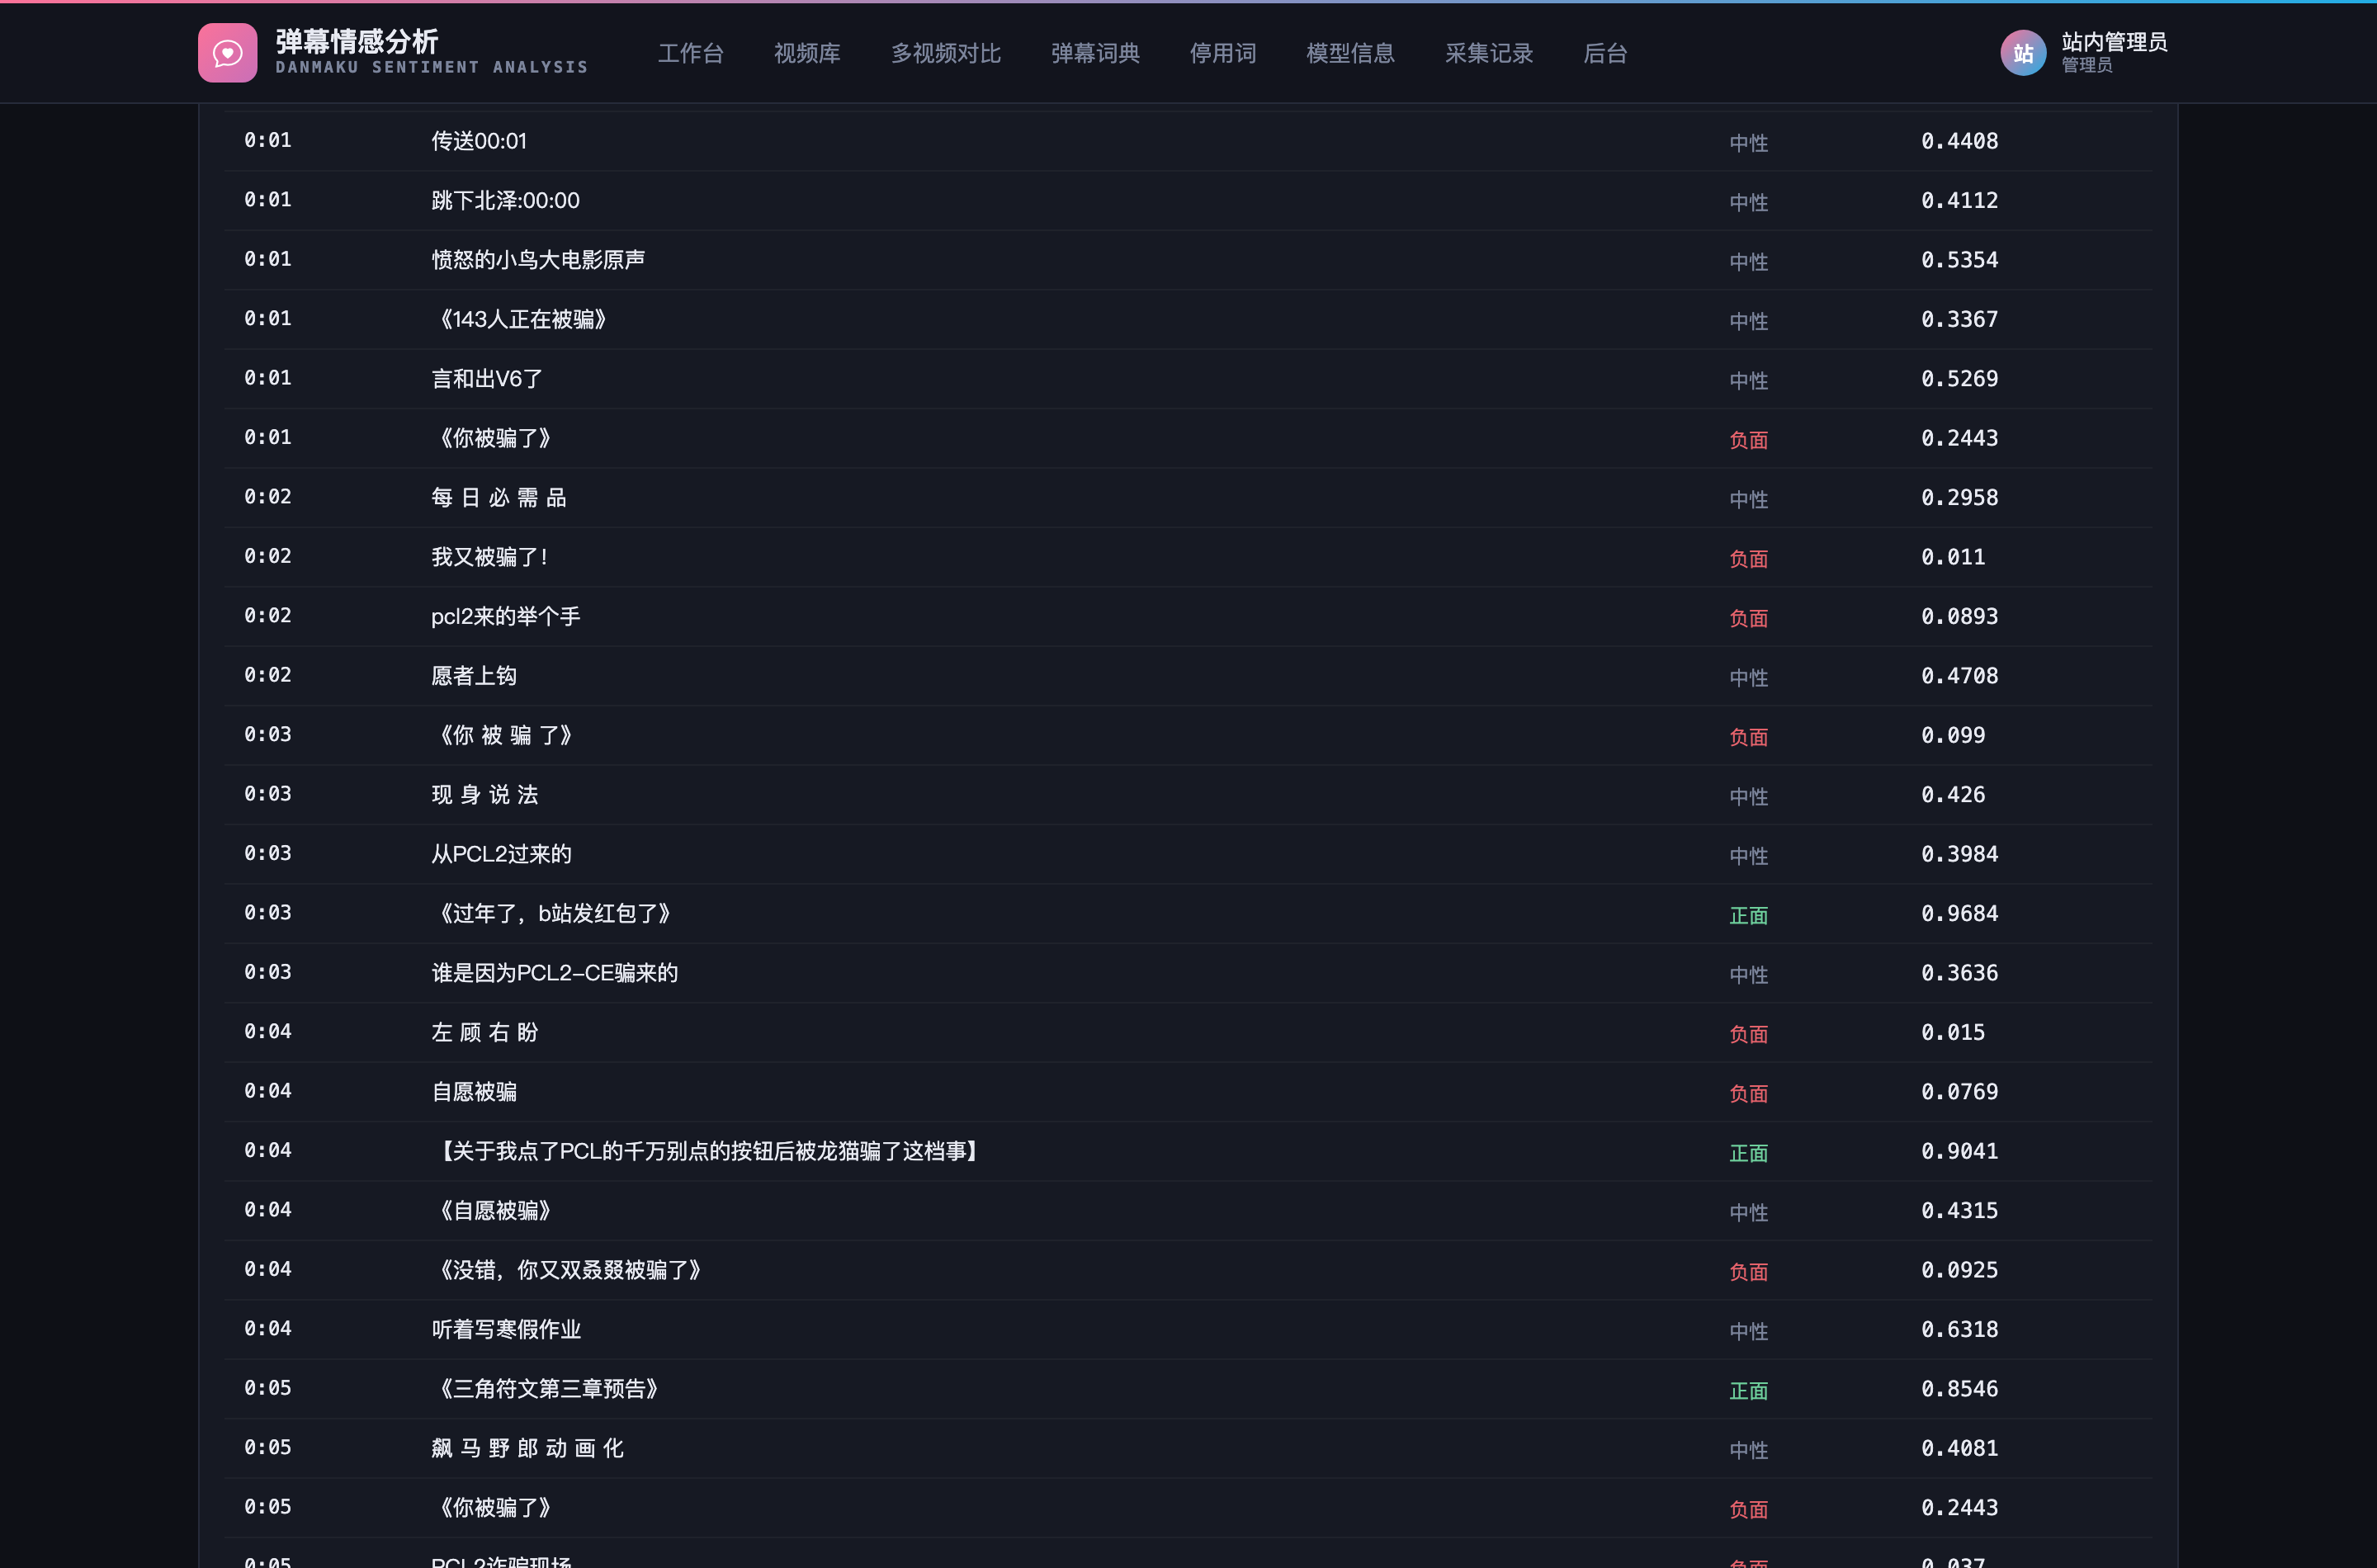
- 典型样例与检索:P(正面) 最高的正面 / 负面弹幕样例,按内容与极性检索弹幕
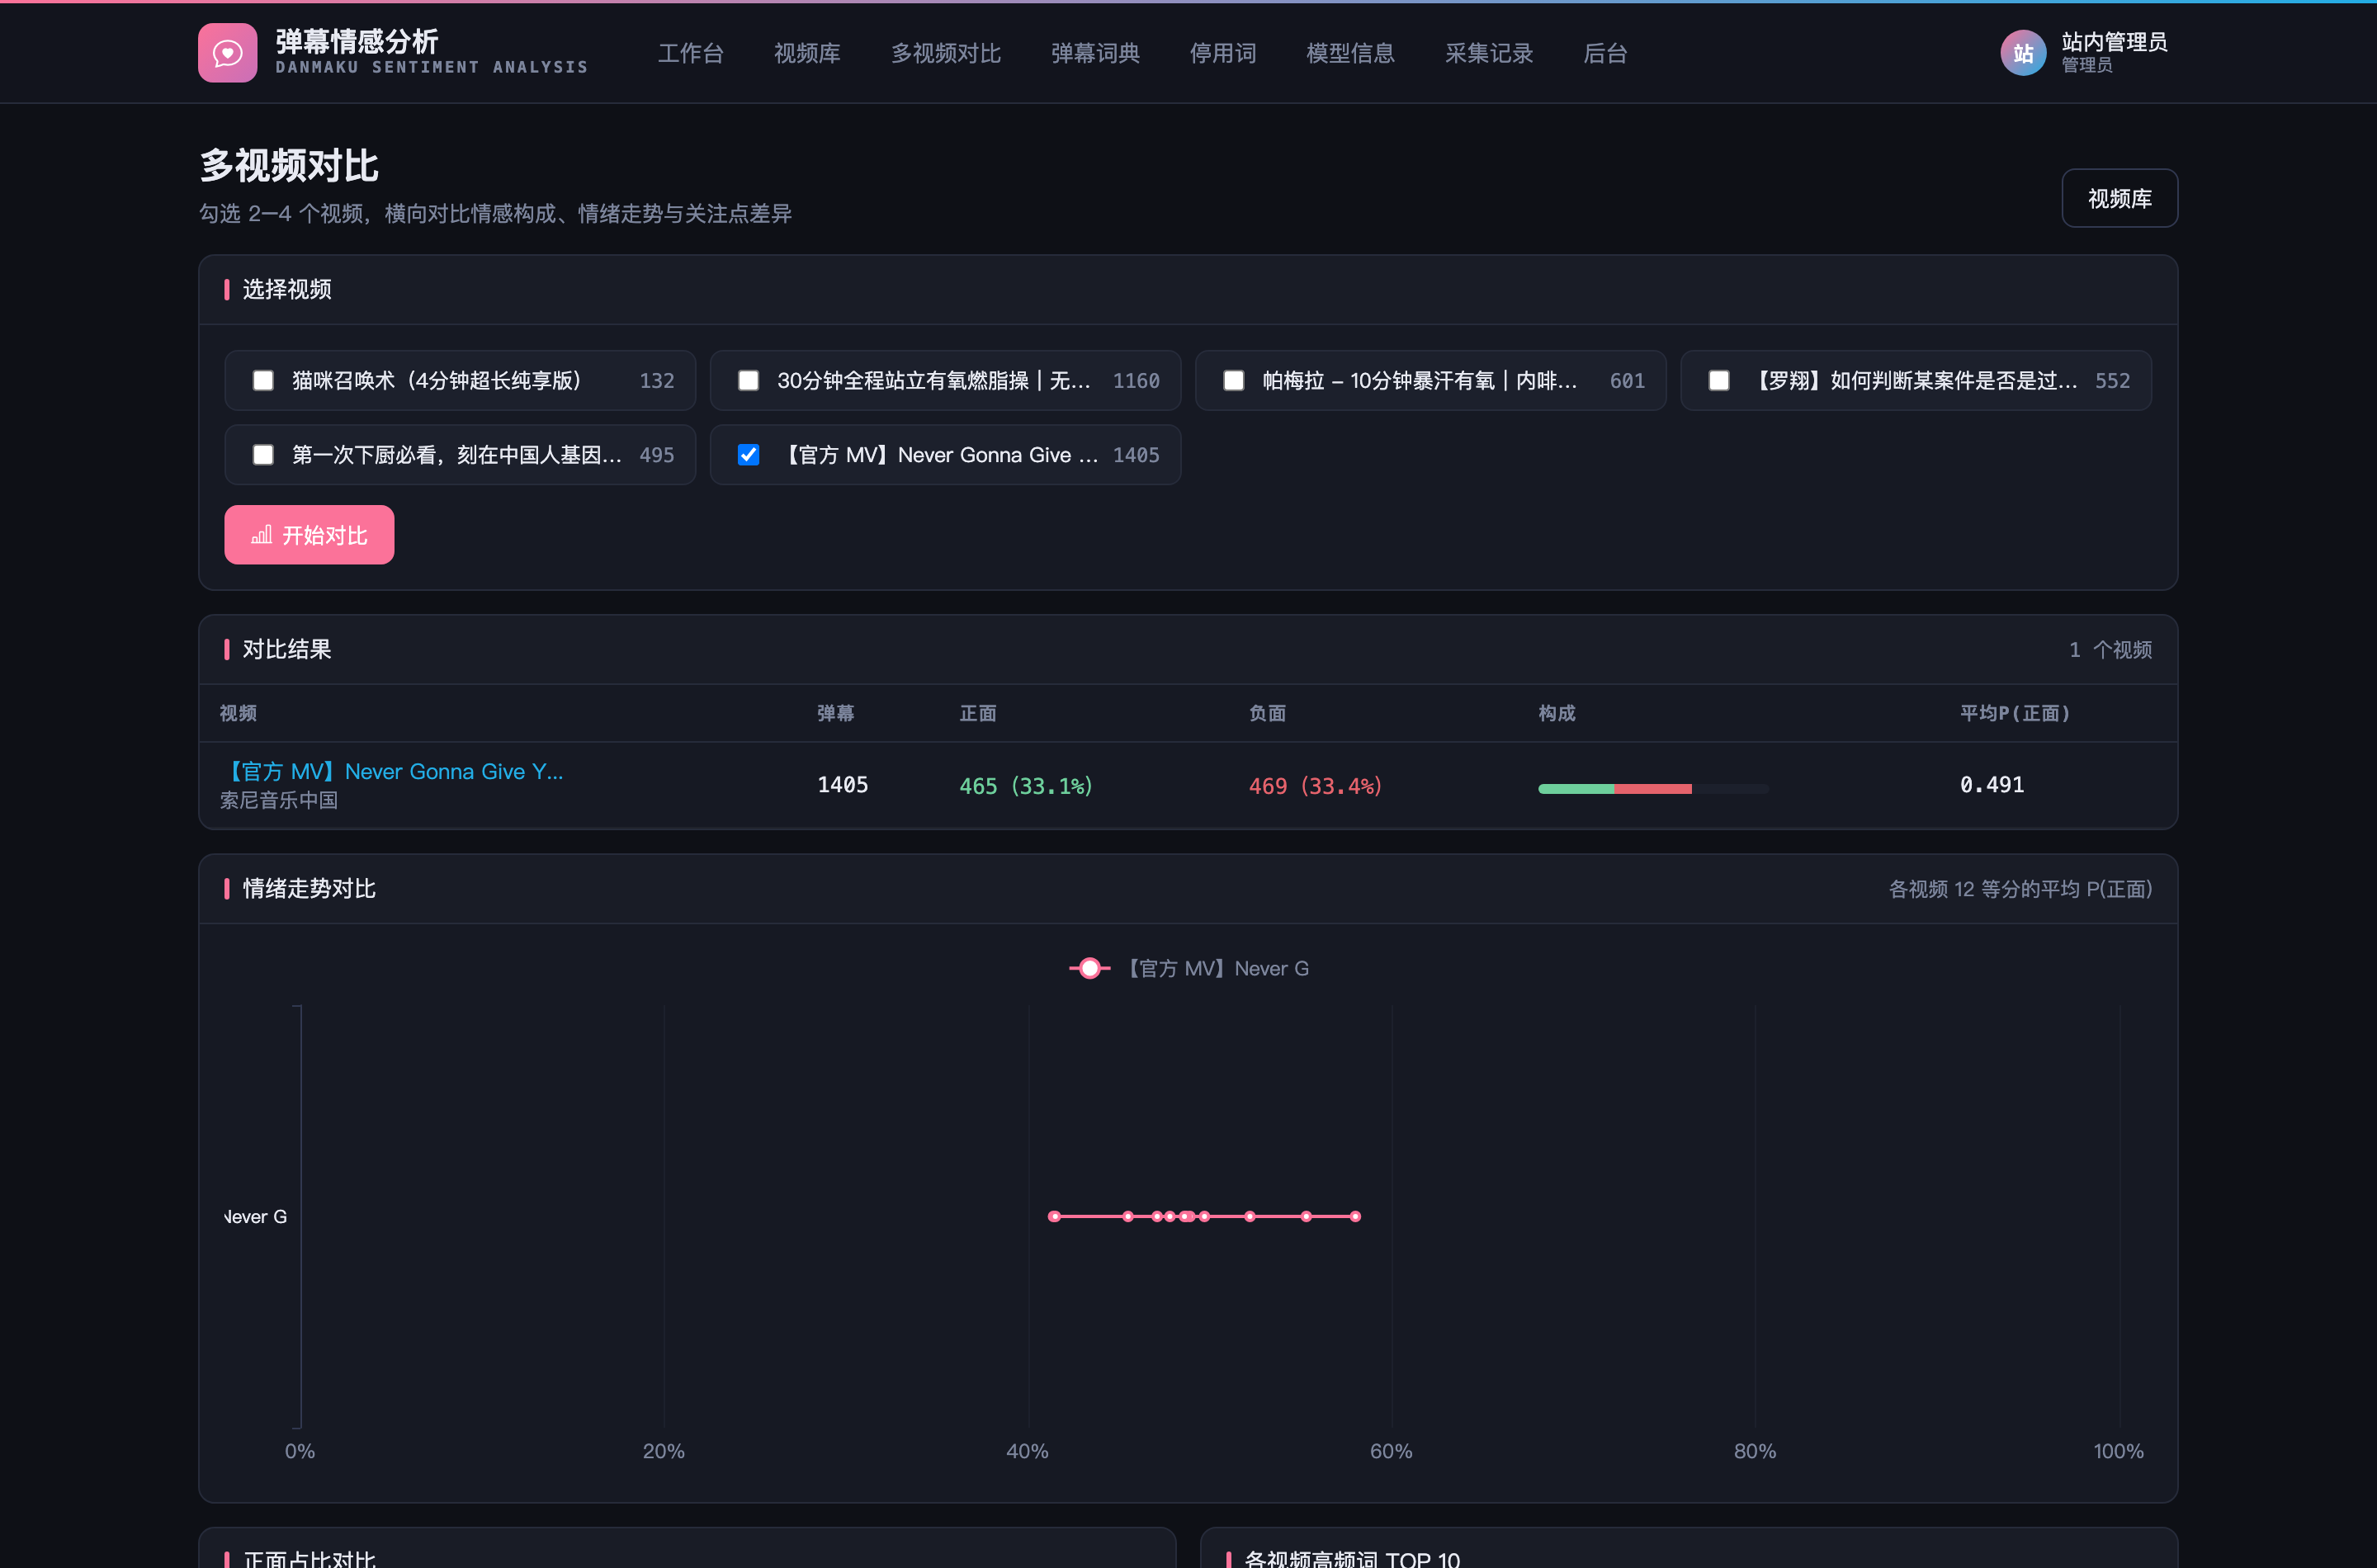
- 多视频对比:2–4 个视频的情感构成、情绪走势与高频词横向对比
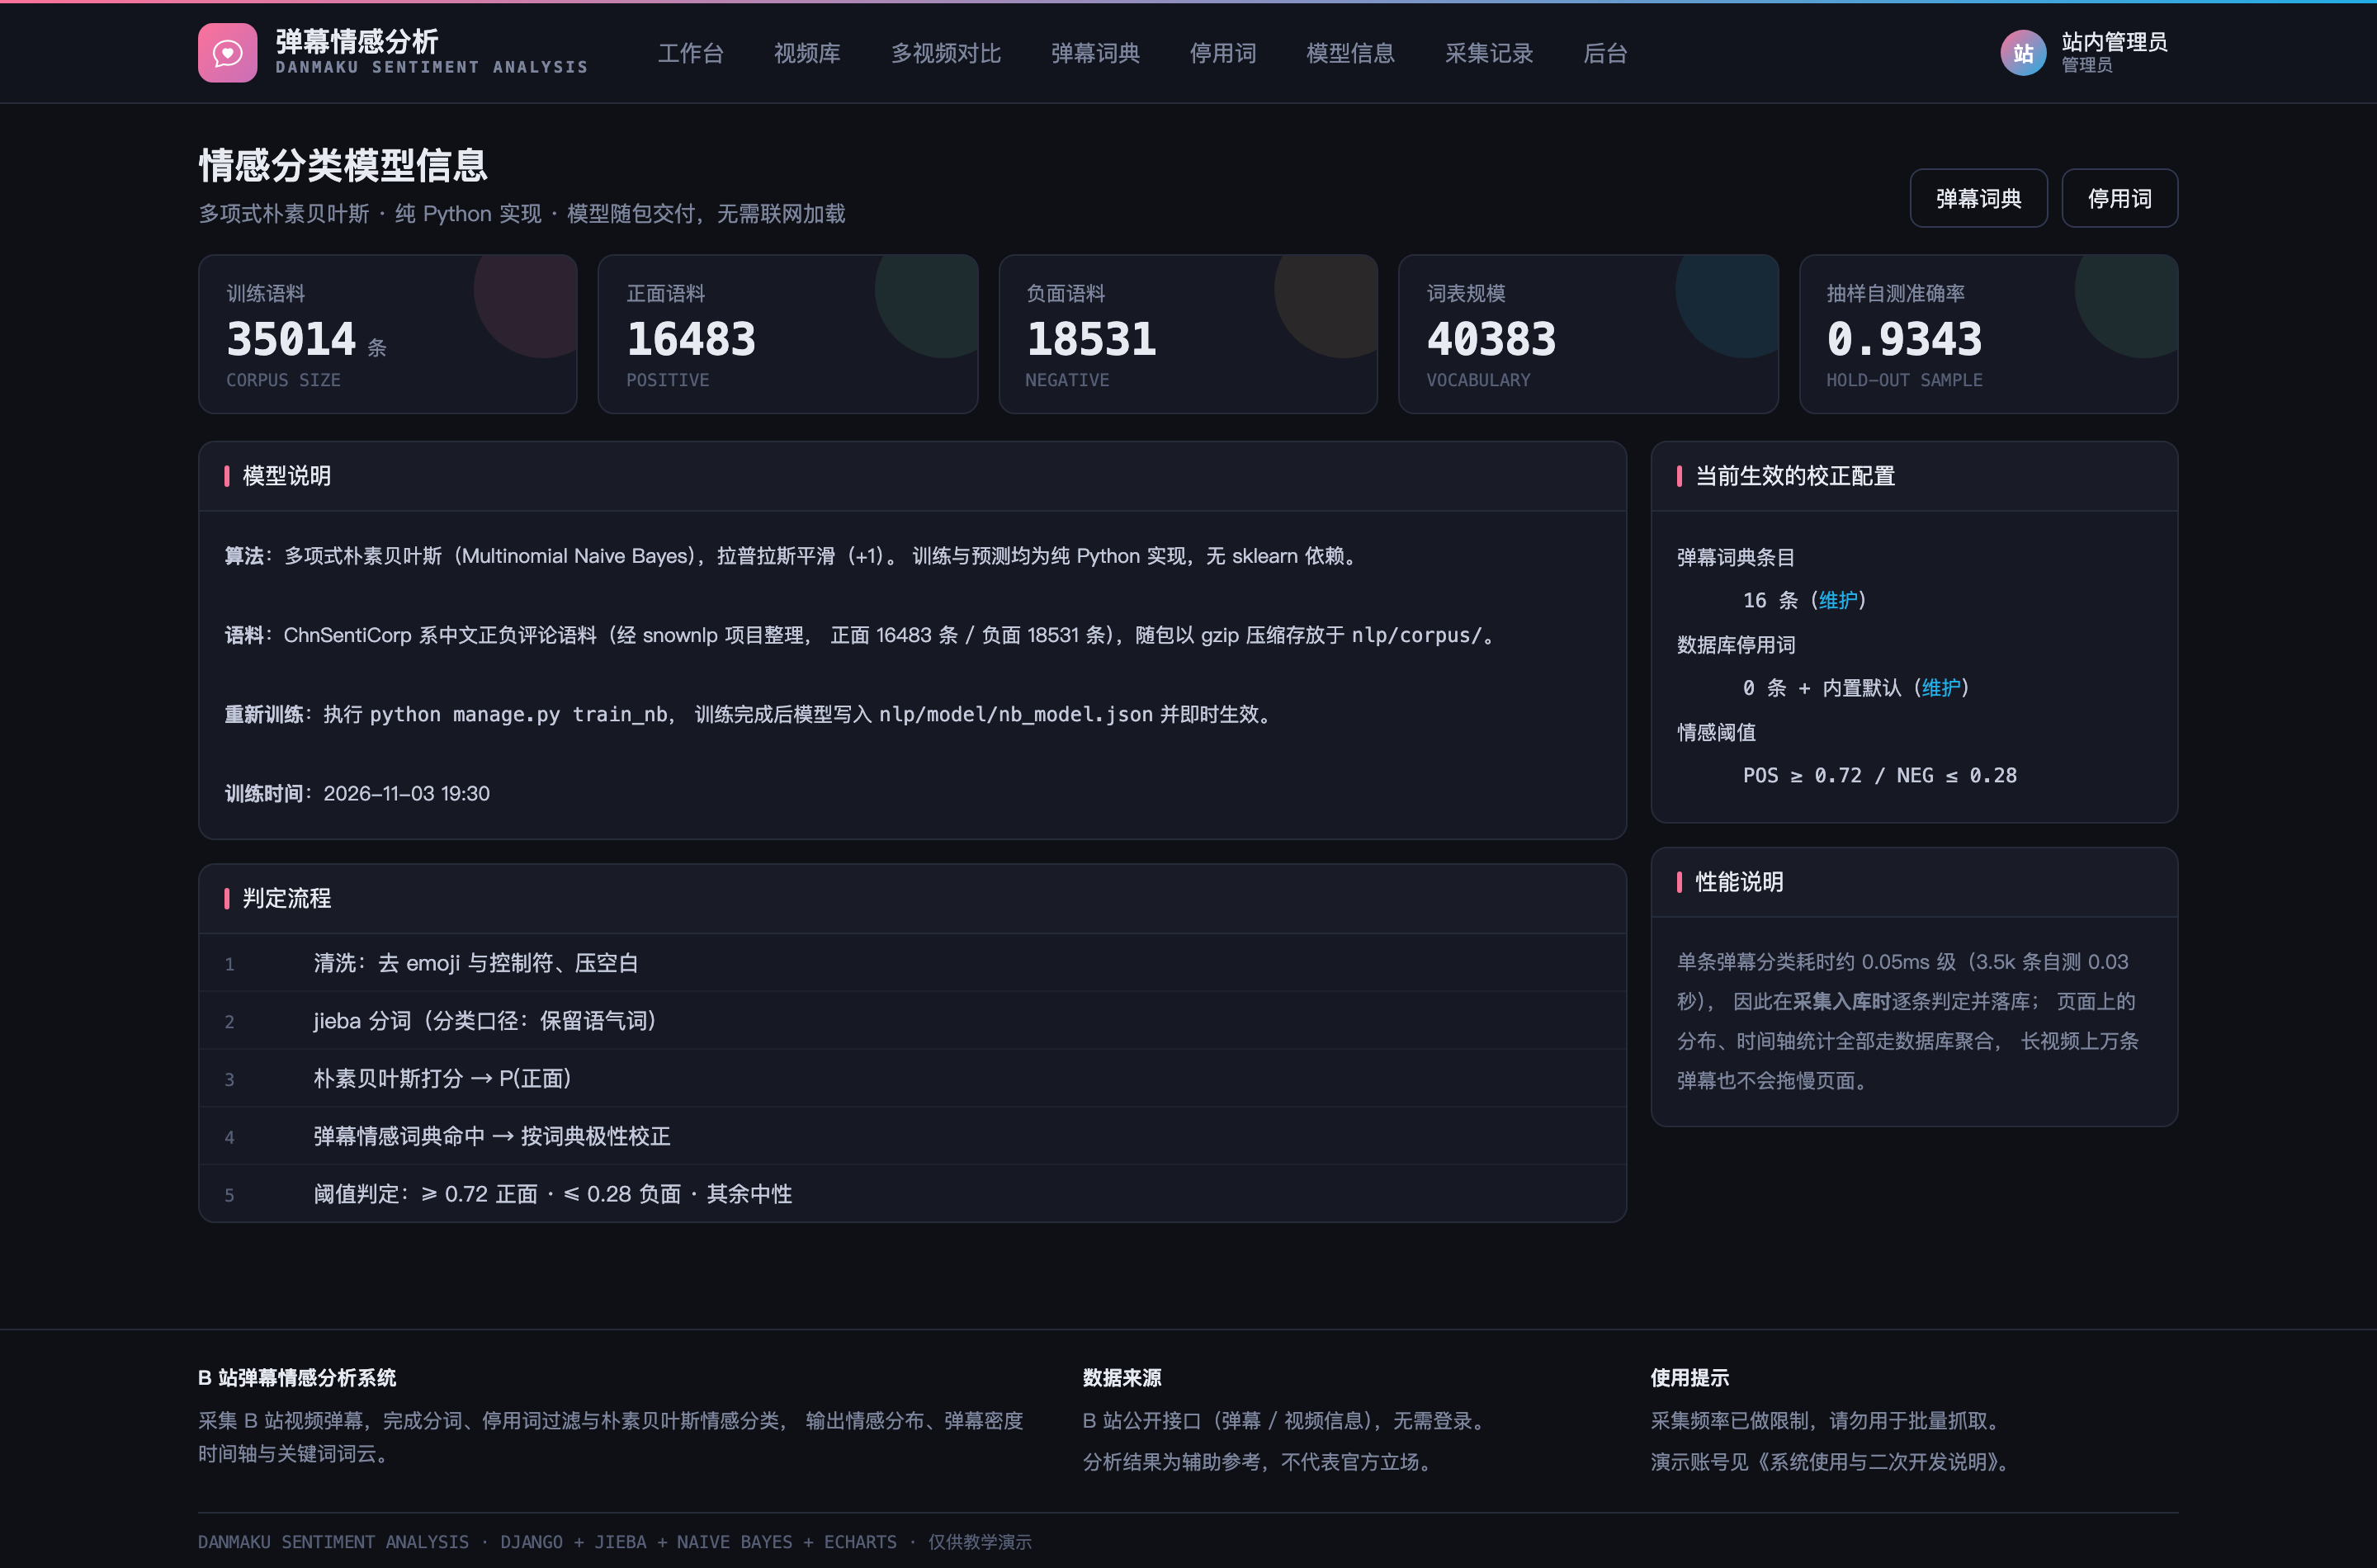
- 维护页面:弹幕词典与停用词增删即时生效;模型信息展示语料规模与判定流程
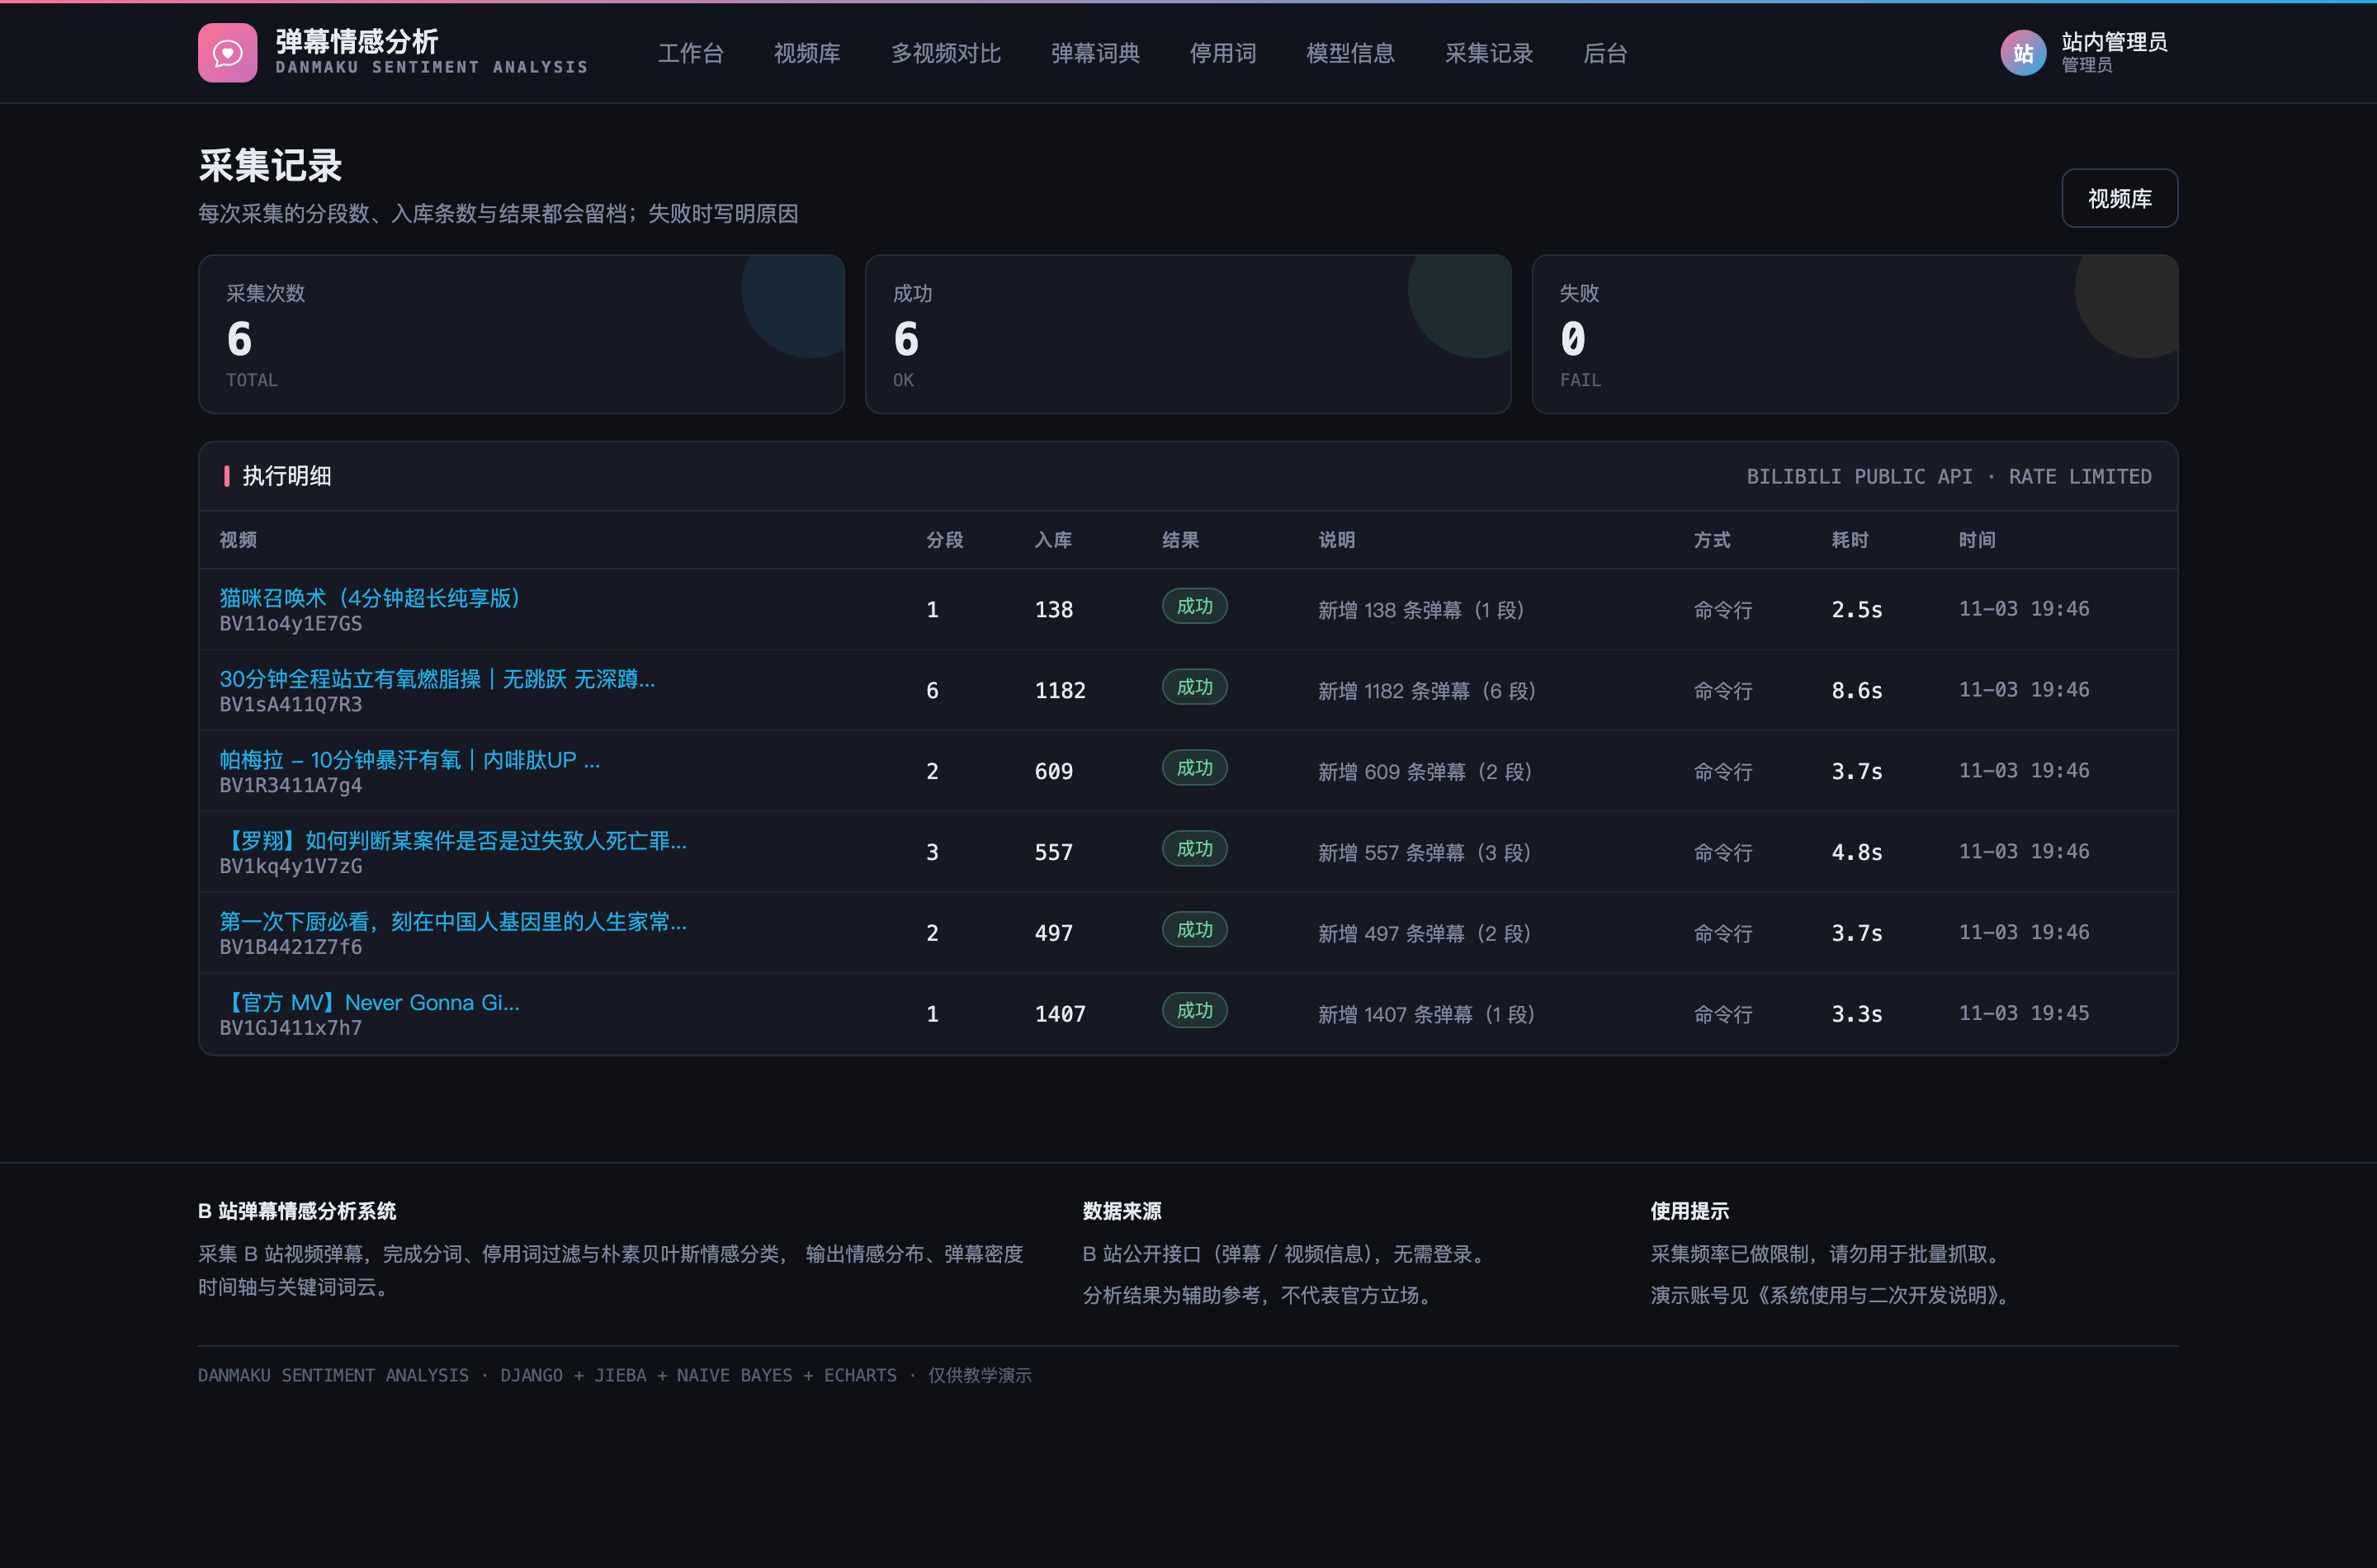
- 采集记录与导出:分段数 / 条数 / 耗时 / 结果全程留档;四张工作表 Excel 导出
交付内容
- 完整源码(已跑通,含 6 个真实视频、4300+ 条已分类弹幕的演示库)
- 训练好的朴素贝叶斯模型与训练语料(可重新训练)
- B 站采集模块(WBI 签名 + protobuf 解码,可独立复用)
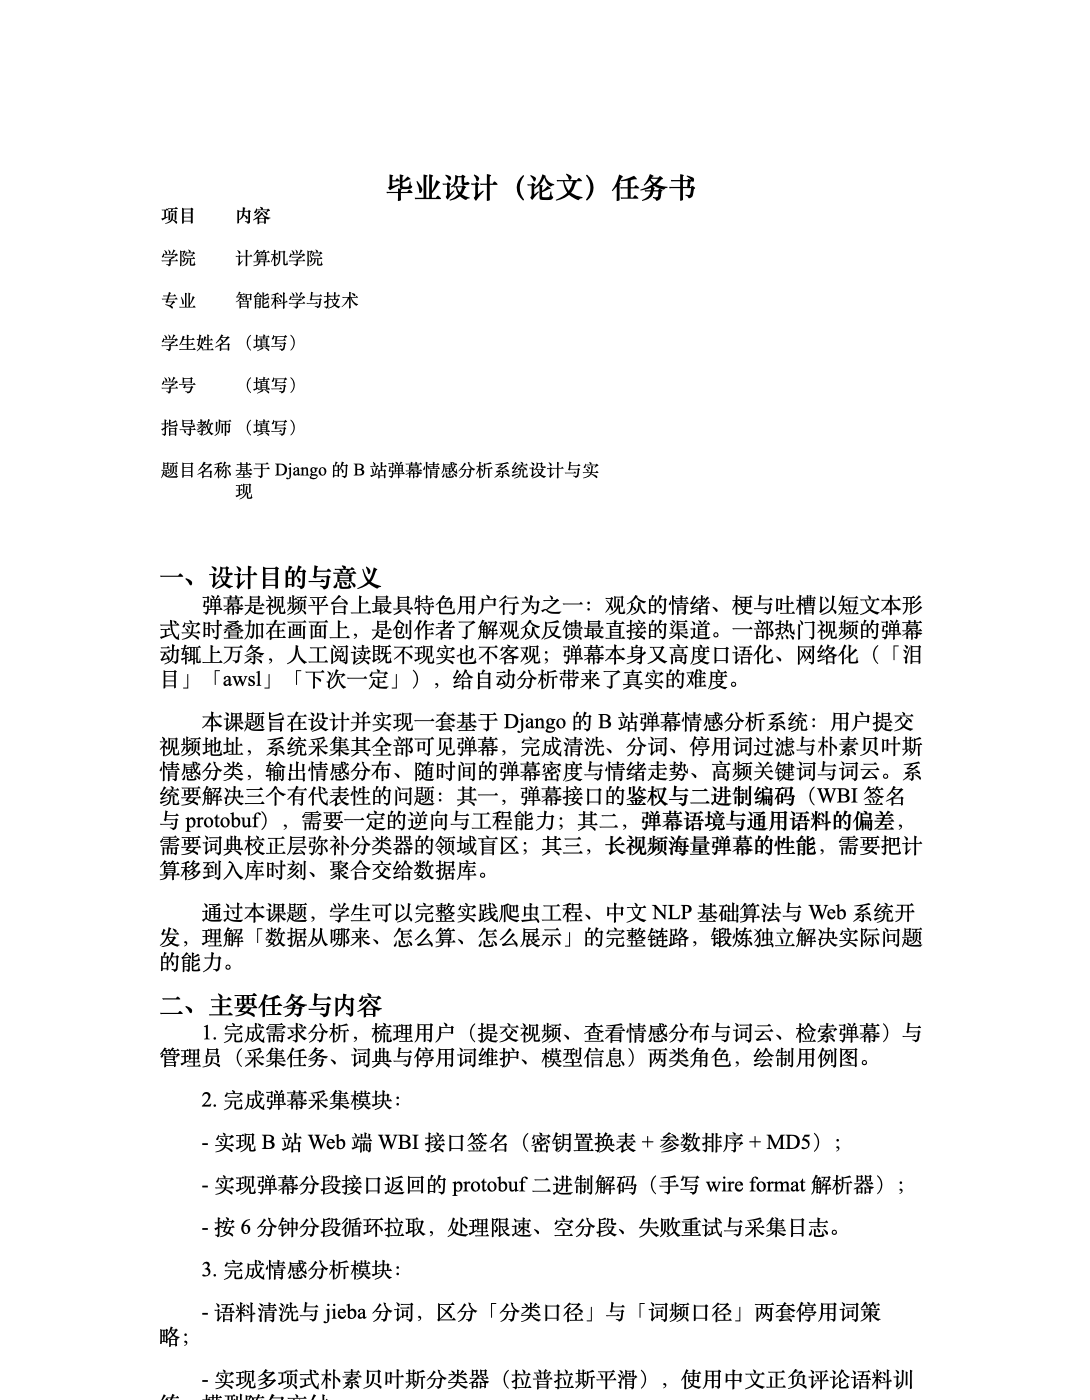
- 毕业设计任务书(Word)
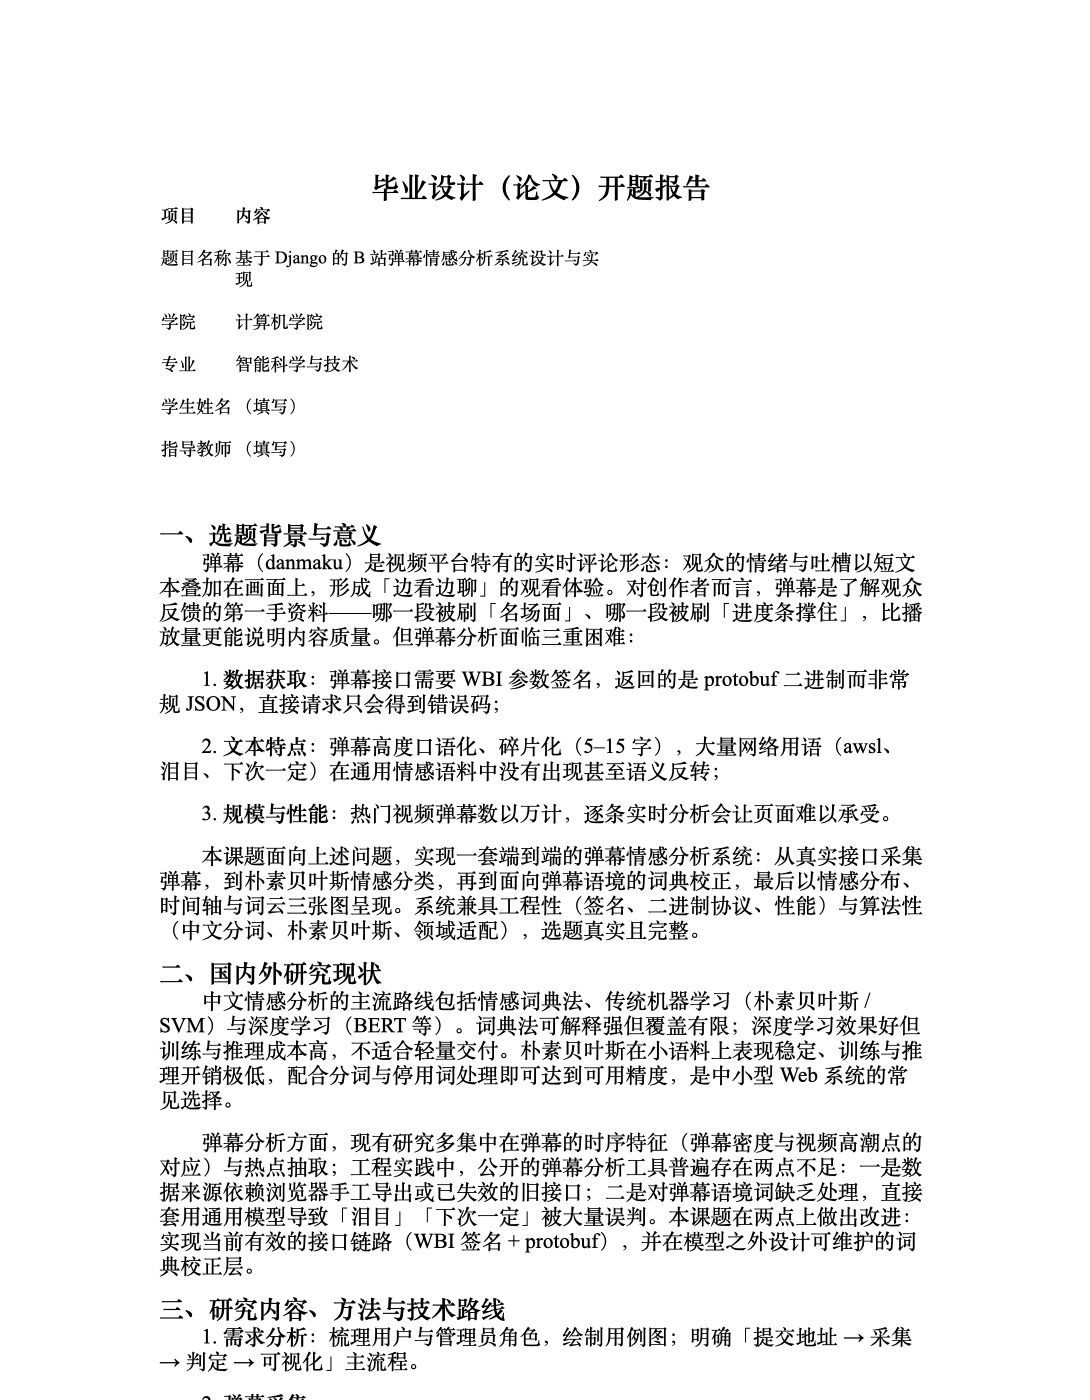
- 开题报告(Word)
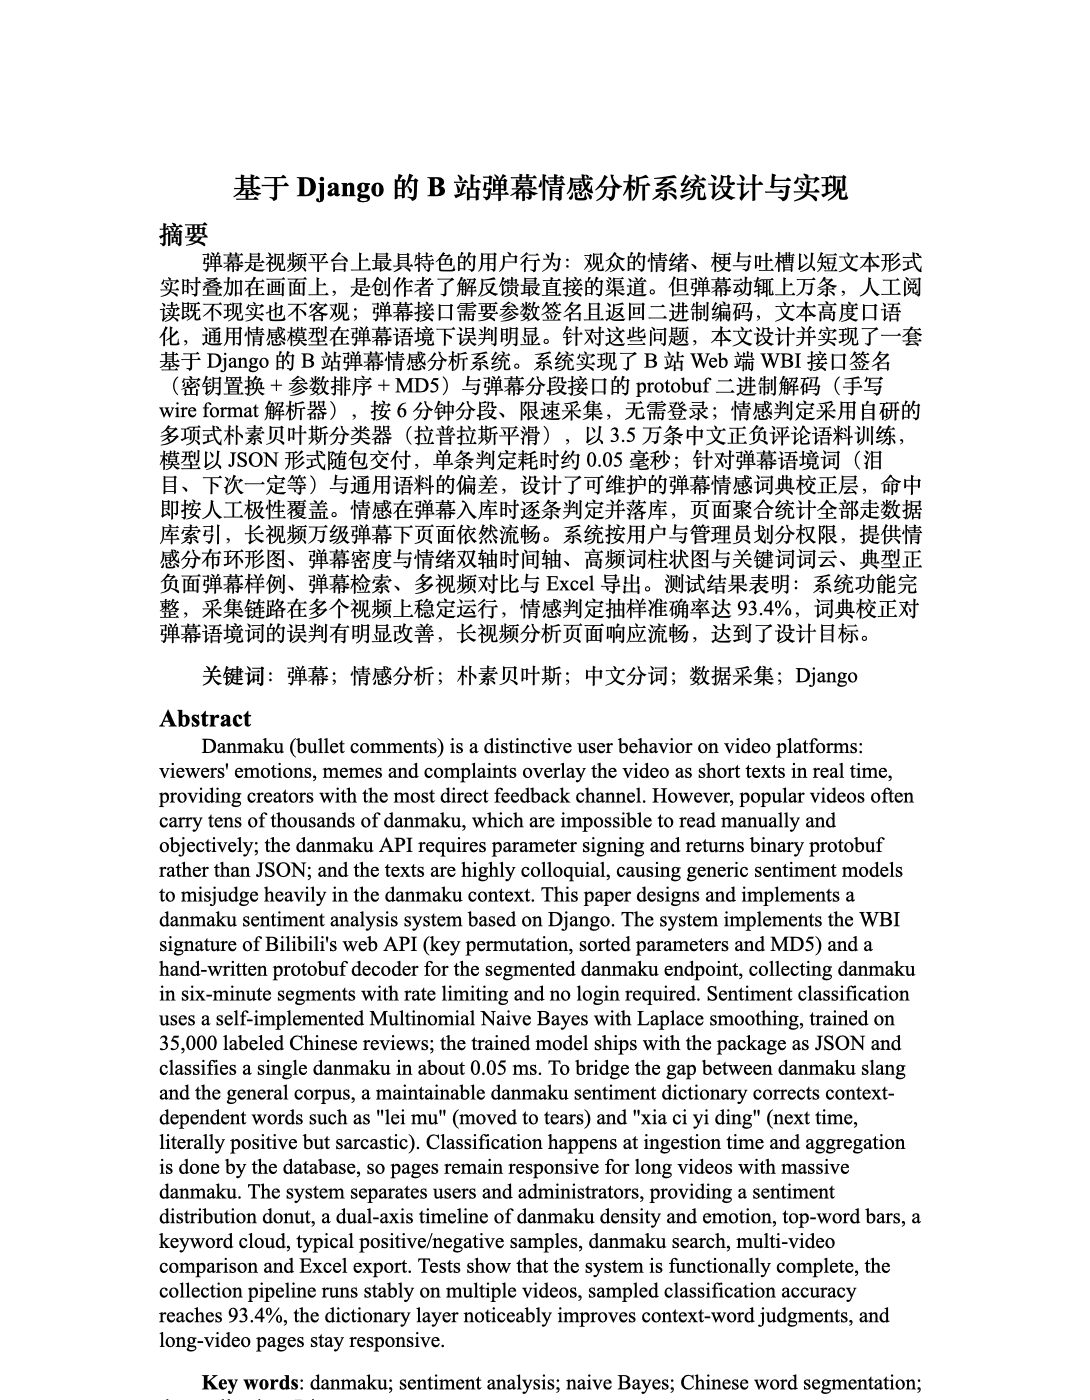
- 毕业论文(Word,七章制,含采集设计与情感判定设计章节)
- 系统使用与二次开发说明(Word + md)
- 10 张系统运行截图
最终成品目录结构
下面是交付包里的真实目录,共 94 个文件。只展示文件名,不含文件内容; 点击文件夹可逐层展开,看到每个模块是怎么拆分的。
界面截图
点击任意一张可放大,支持左右切换(也可用键盘 ← → 键)
文档预览
交付的任务书、开题报告与论文均为 Word 文档,下面是真实页面预览;点击可放大并左右切换:
常见问题
项目能直接跑起来吗?
能。交付包里已带数据库(6 个真实视频、4300+ 条已分类弹幕),安装依赖后双击一键脚本即可;想采新视频需要联网,无需登录 B 站。
弹幕是真实数据吗?
是。弹幕与视频信息来自 B 站公开接口,系统自实现了 WBI 接口签名与 protobuf 解码;每次采集的分段数、条数、耗时都会在「采集记录」留档。
为什么弹幕数比平台显示的少?
B 站接口对历史弹幕有回放上限,系统采集到的是接口当前返回的可见部分,页面上如实展示条数。
情感判定准不准?
训练语料留出自测准确率 93.4%;真实弹幕人工抽查中,明确正负面弹幕准确率约 85%。弹幕多为短句与语气词,中性占比高属正常;每条弹幕保留 P(正面) 可核查。
「泪目」「下次一定」这类词怎么处理?
通用评论语料里缺少或语义反转这类弹幕用语,系统设计了弹幕情感词典校正层:命中即按人工极性覆盖模型结果,每条规则带理由、可在页面维护。
为什么没有实时分析大按钮?
情感在弹幕入库时逐条判定并落库(单条约 0.05ms),页面聚合走数据库索引——长视频万级弹幕也不会卡页面;这也符合真实系统的做法。
采集会不会太快把账号弄封?
采集无需登录,且已内置 1.2 秒/请求限速、失败降级;请勿用于批量抓取。
能换成 MySQL 吗?
能。设置 DB_ENGINE=mysql 与连接参数后 migrate 即可;交付默认 SQLite 是为了免安装。