基于 SpringBoot 的培训机构排课与考勤系统设计与实现
项目简介
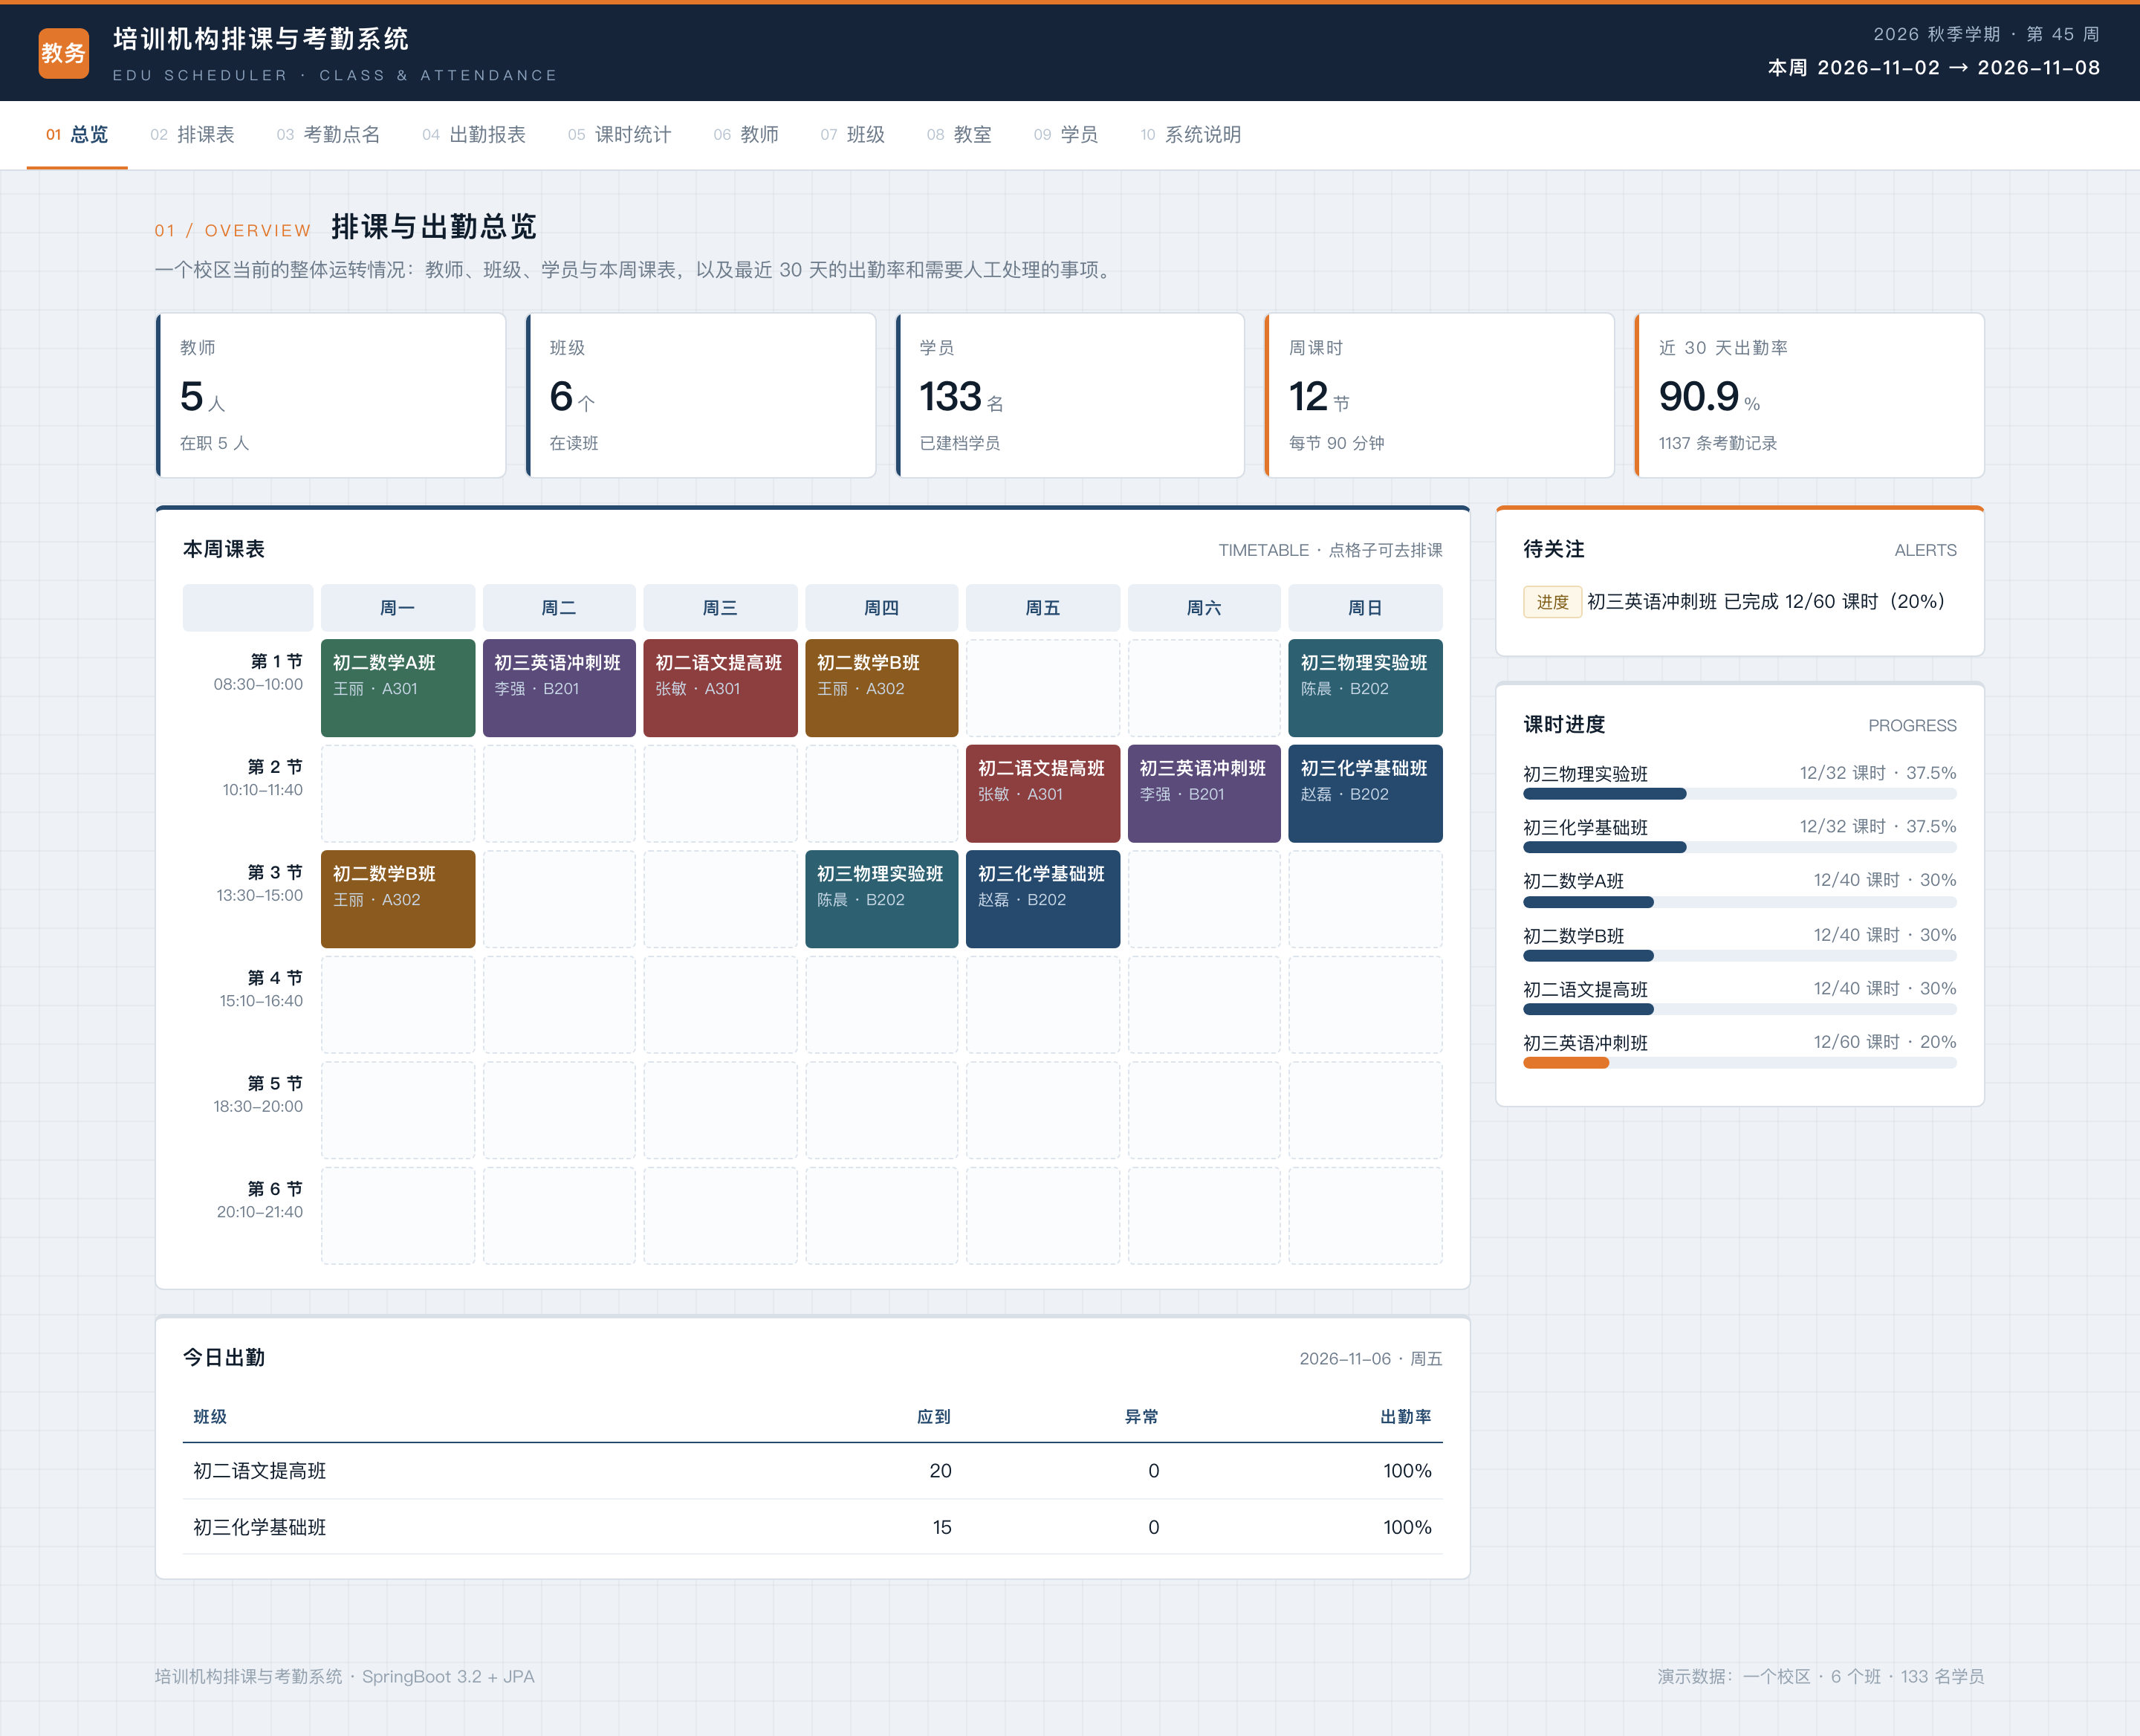
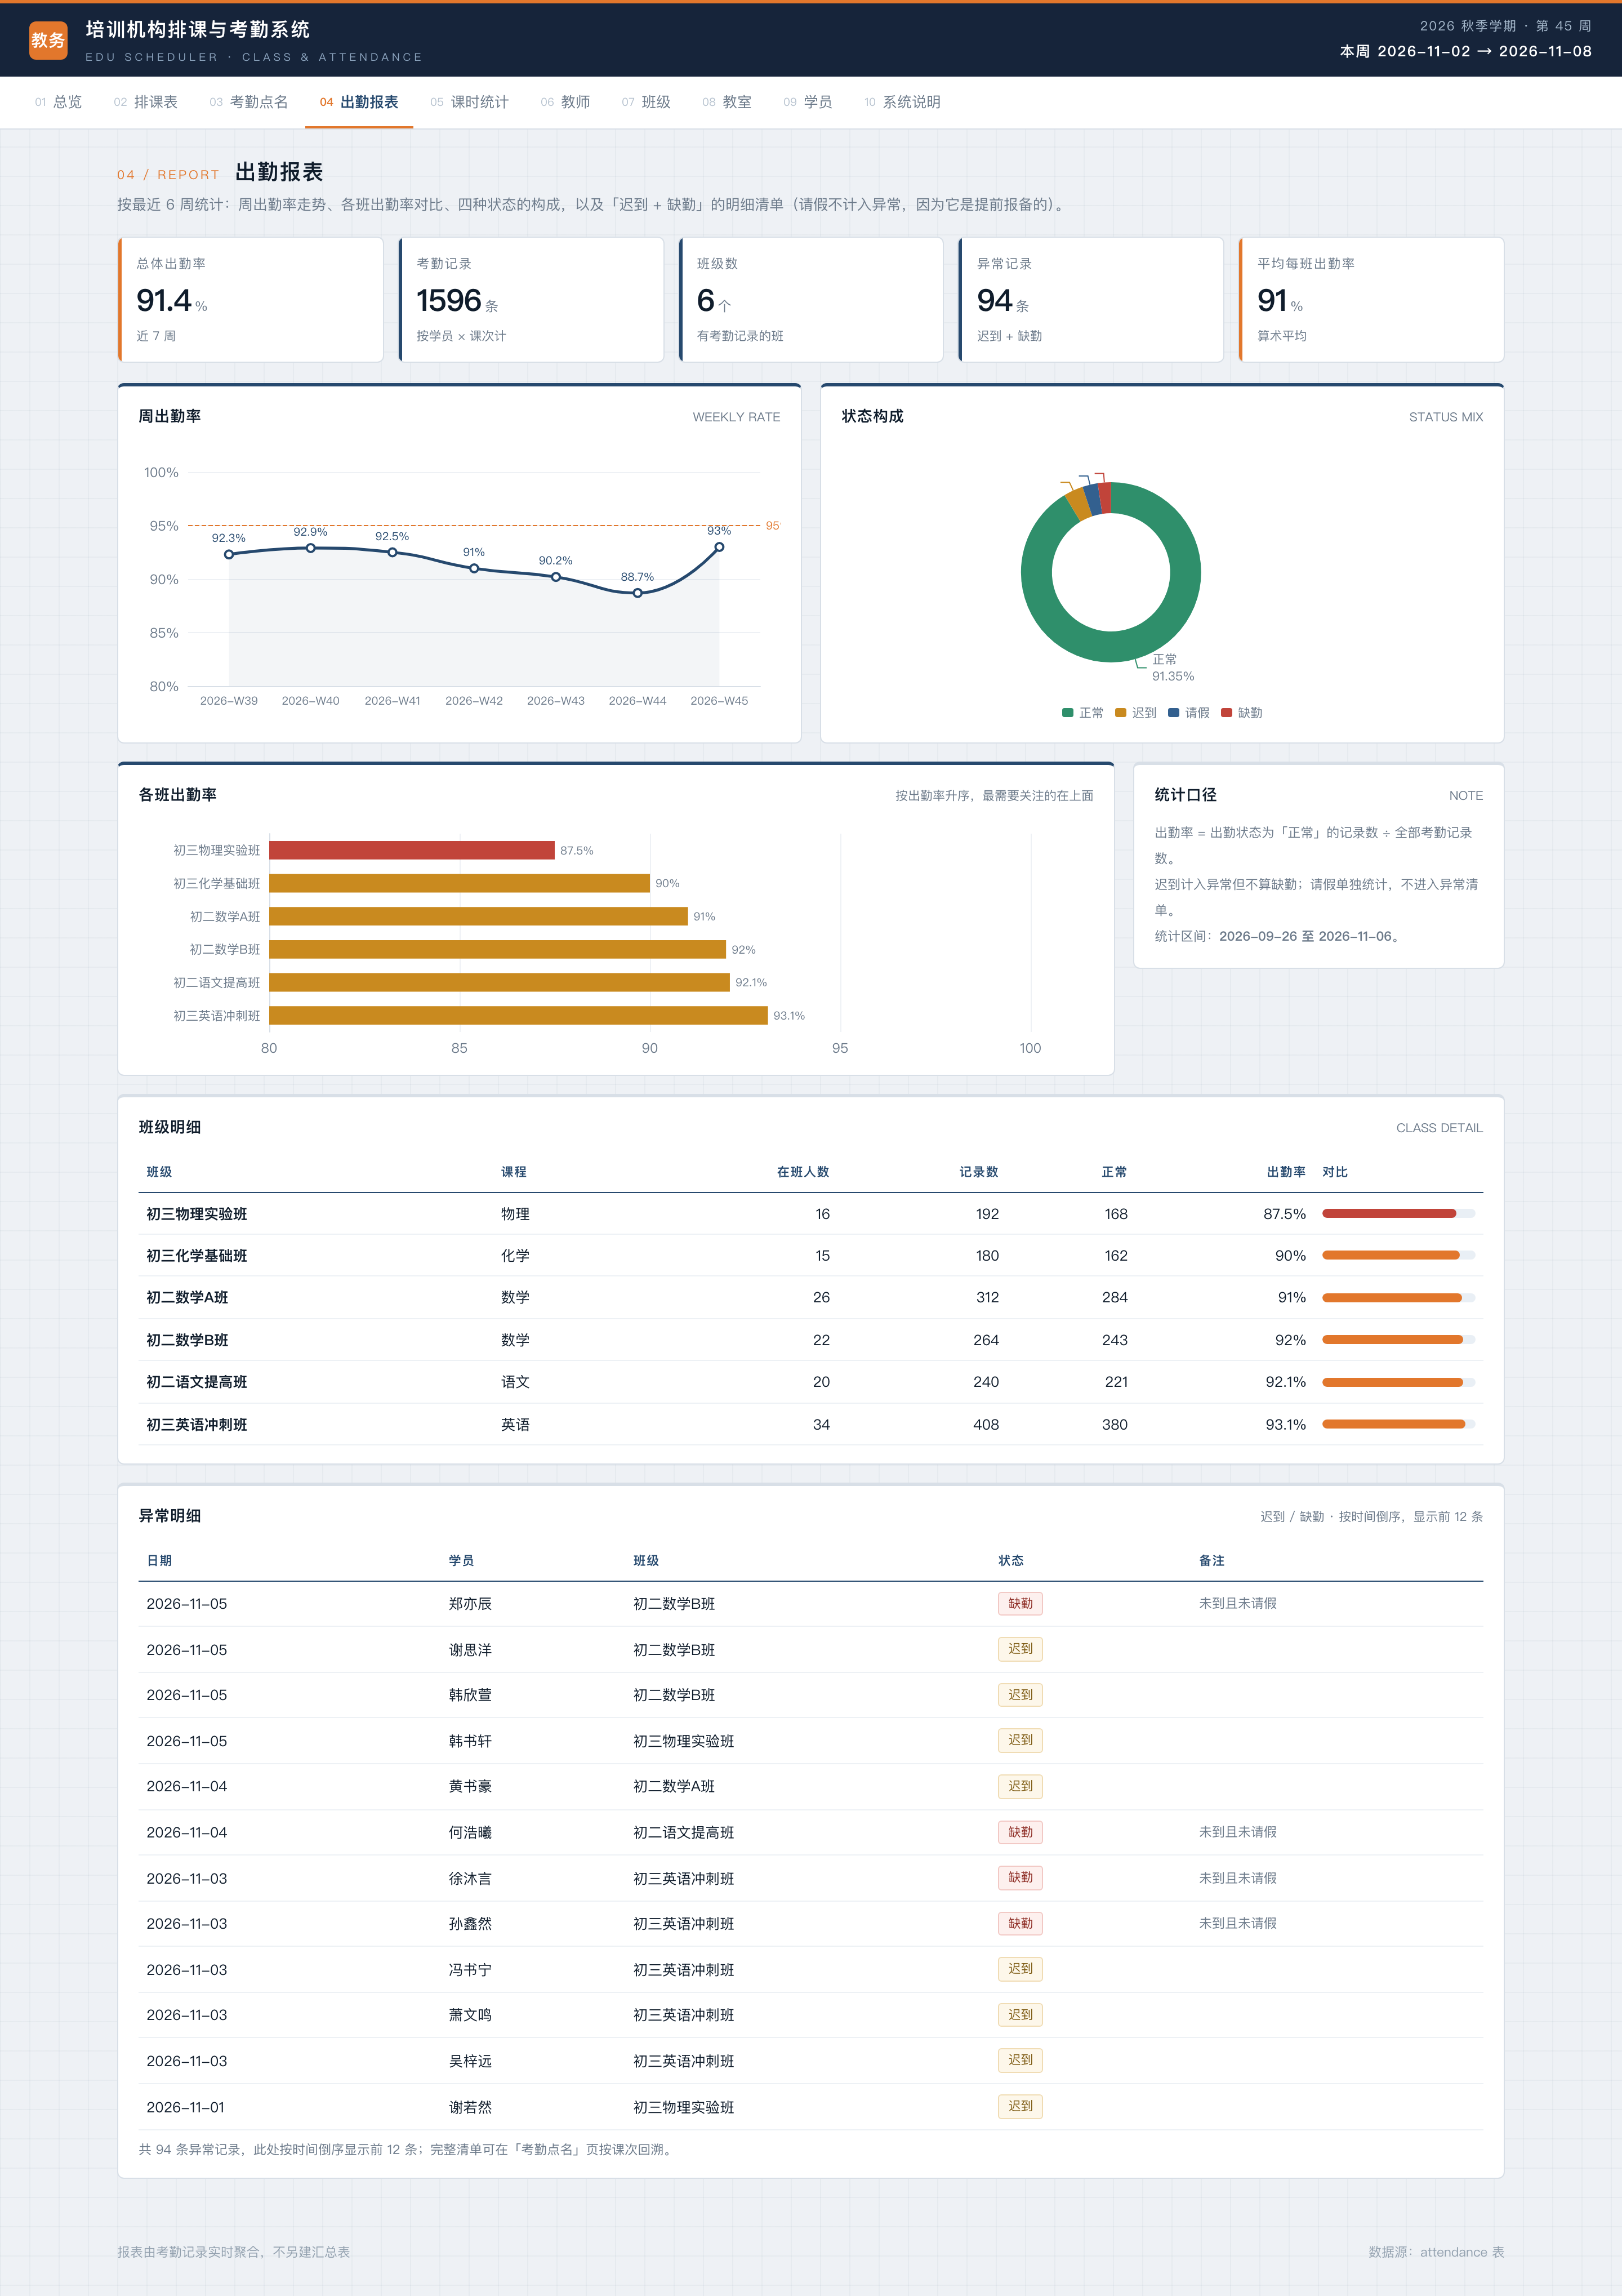
面向单校区培训机构的排课与考勤系统:把「教师、教室、班级时段互斥 + 教室容量」四条约束写成可解释的冲突清单,排不了时直接说清被谁占了;配套课次点名、出勤报表与课时统计(6 周 72 课次 1596 条考勤)。Java 17 + SpringBoot 3.2.5 + JPA,H2 免安装、jar 双击即启动,第 23 套「教务排班风」界面。
演示视频
视频也可在 B 站视频页 观看
运行环境
| 编程语言 | Java 17 |
|---|---|
| 后端框架 | SpringBoot 3.2.5、Spring Data JPA、Bean Validation |
| 数据库 | MySQL 8.0(交付默认 H2 文件库,免安装、可切换) |
| 前端 | 原生 HTML + CSS + JavaScript(随 jar 发布,无构建步骤) |
| 可视化 | ECharts 5(已内置本地文件,离线可用) |
| 数据规模 | 7 张表 / 12 个接口 / 10 个页面;演示数据 6 班 133 名学员 1596 条考勤 |
| 操作系统 | Windows / macOS / Linux |
| 启动方式 | 双击一键脚本,或 java -jar edu-schedule.jar --server.port=8089 |
功能模块
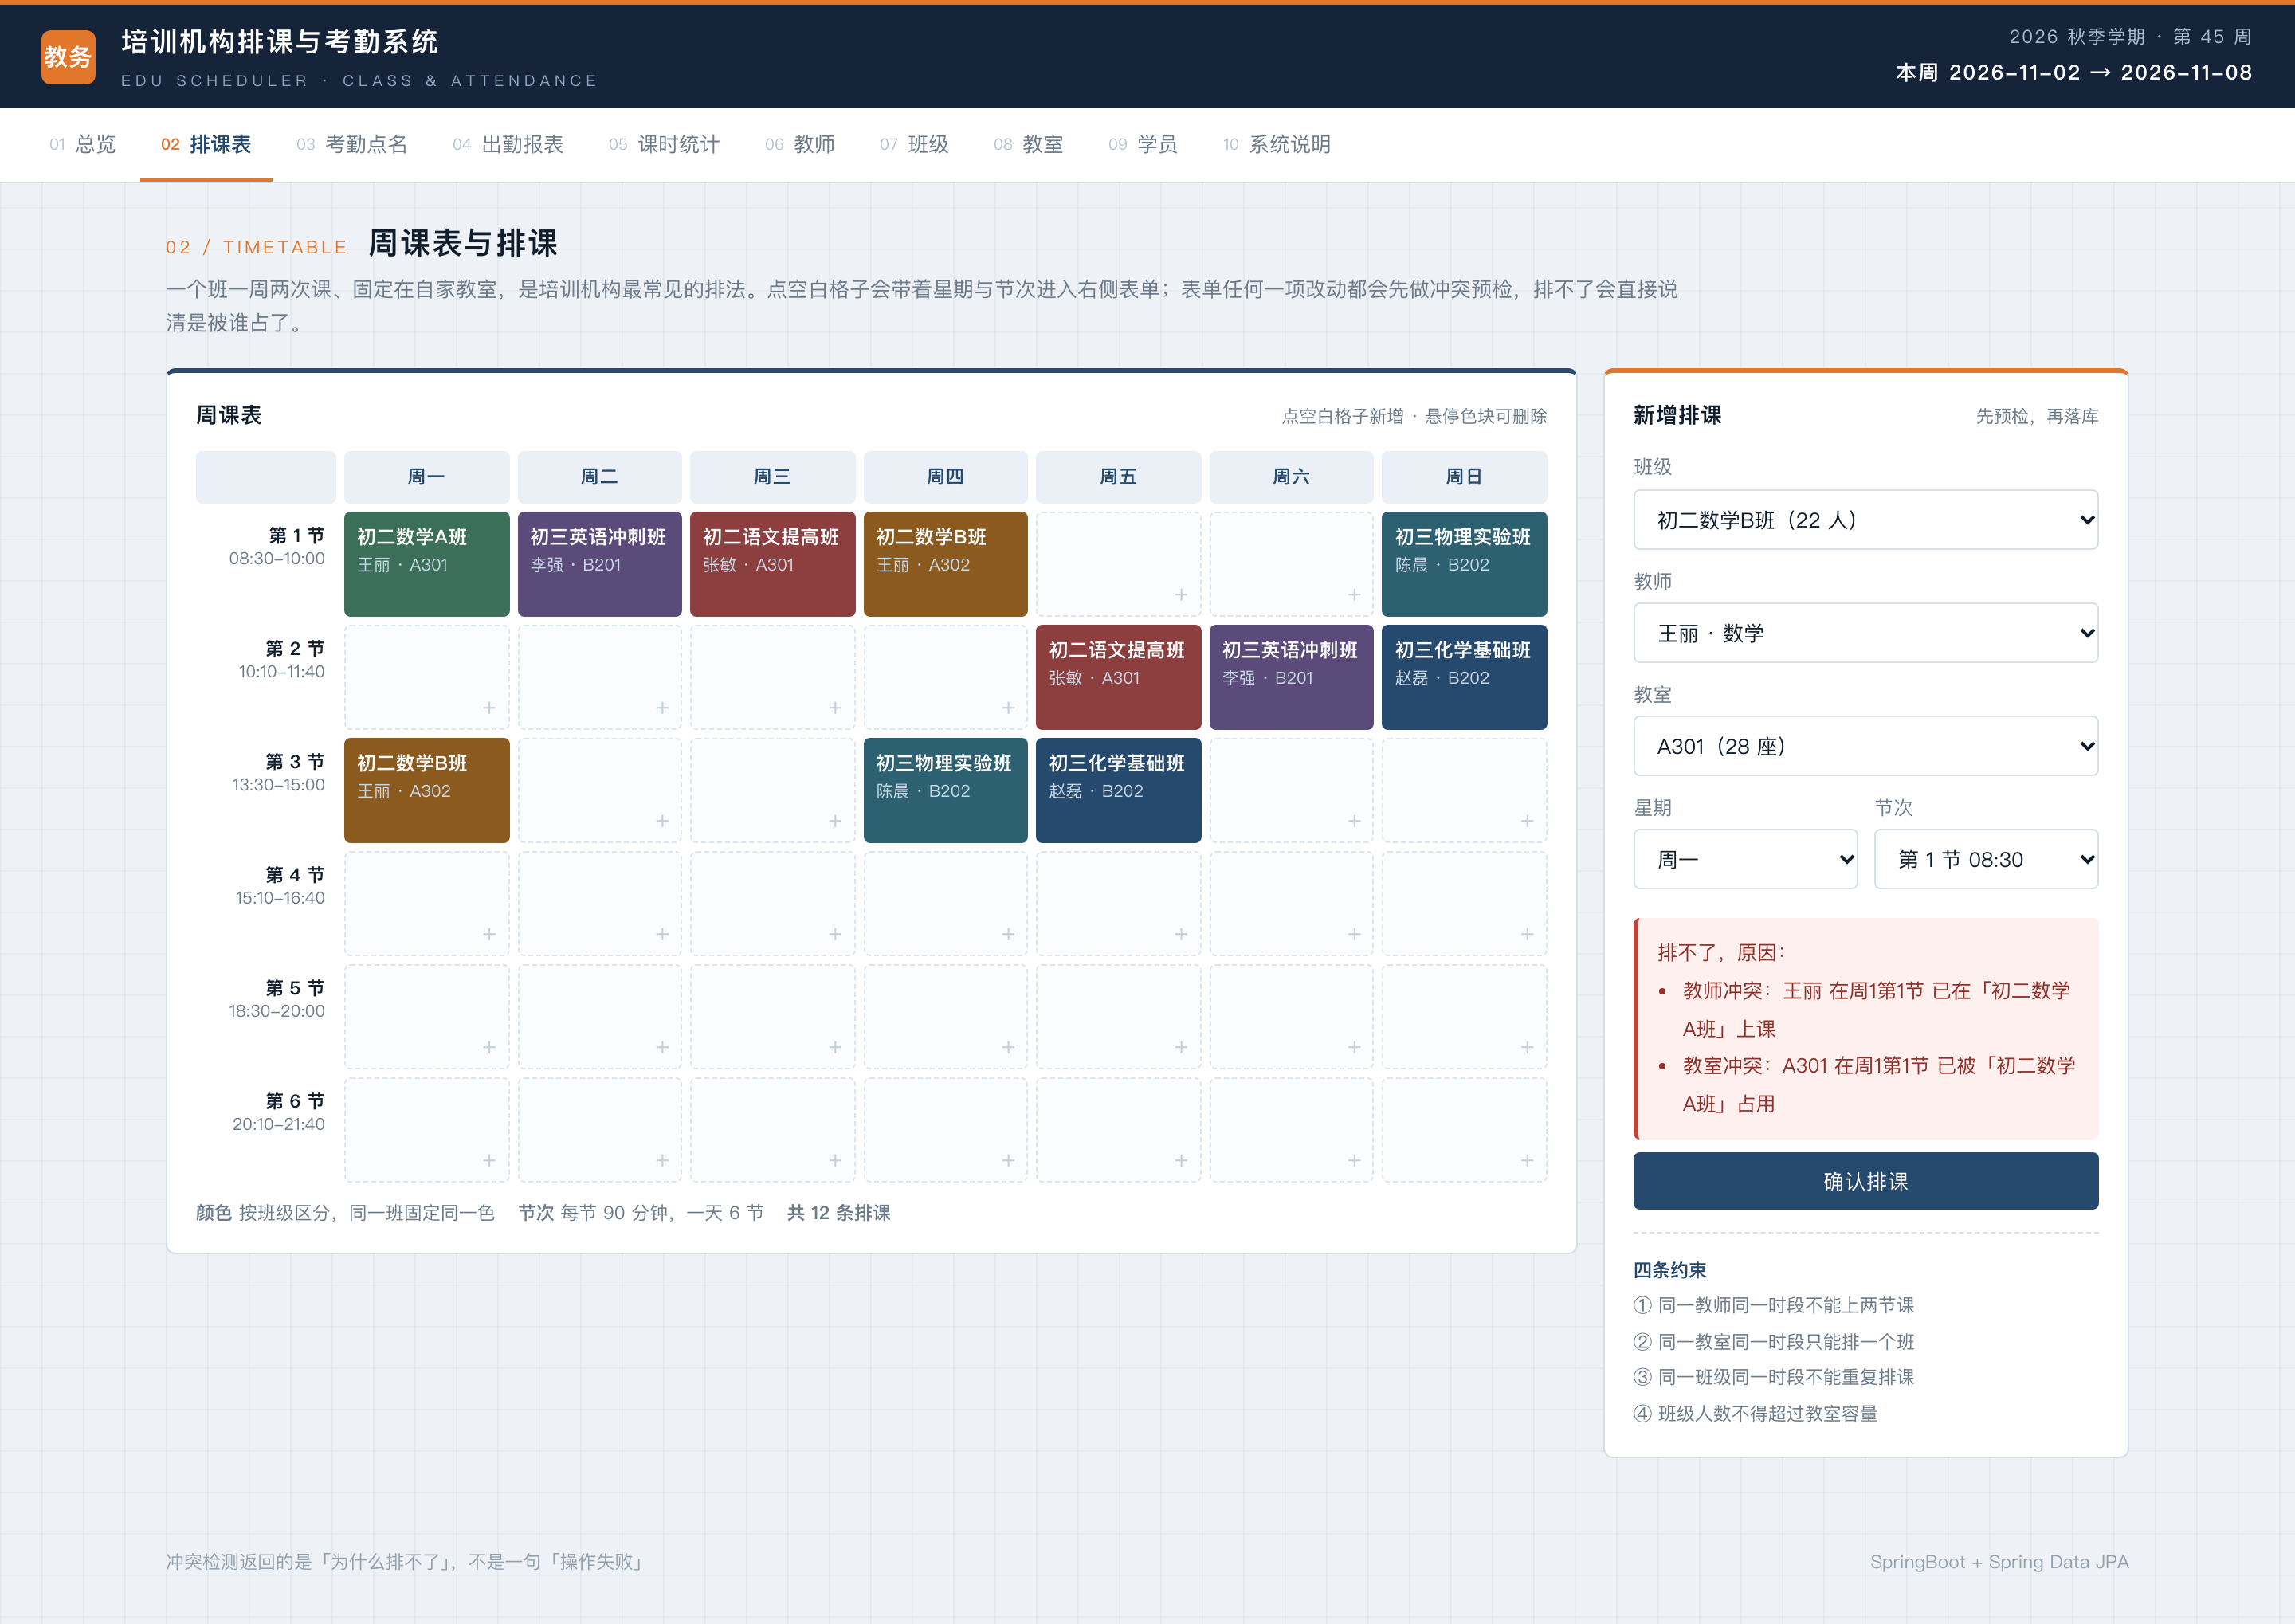
- 可解释的冲突检测:四条规则分别实现,命中时生成带名称的描述(如「教师冲突:王丽 在周1第1节 已在「初二数学A班」上课」),一次返回全部原因而不是一句「操作失败」
- 两级校验:/api/schedule/check 只校验不落库(表单改动即预检),POST /api/schedule 写入前复检,防止绕过界面直接调接口写冲突数据
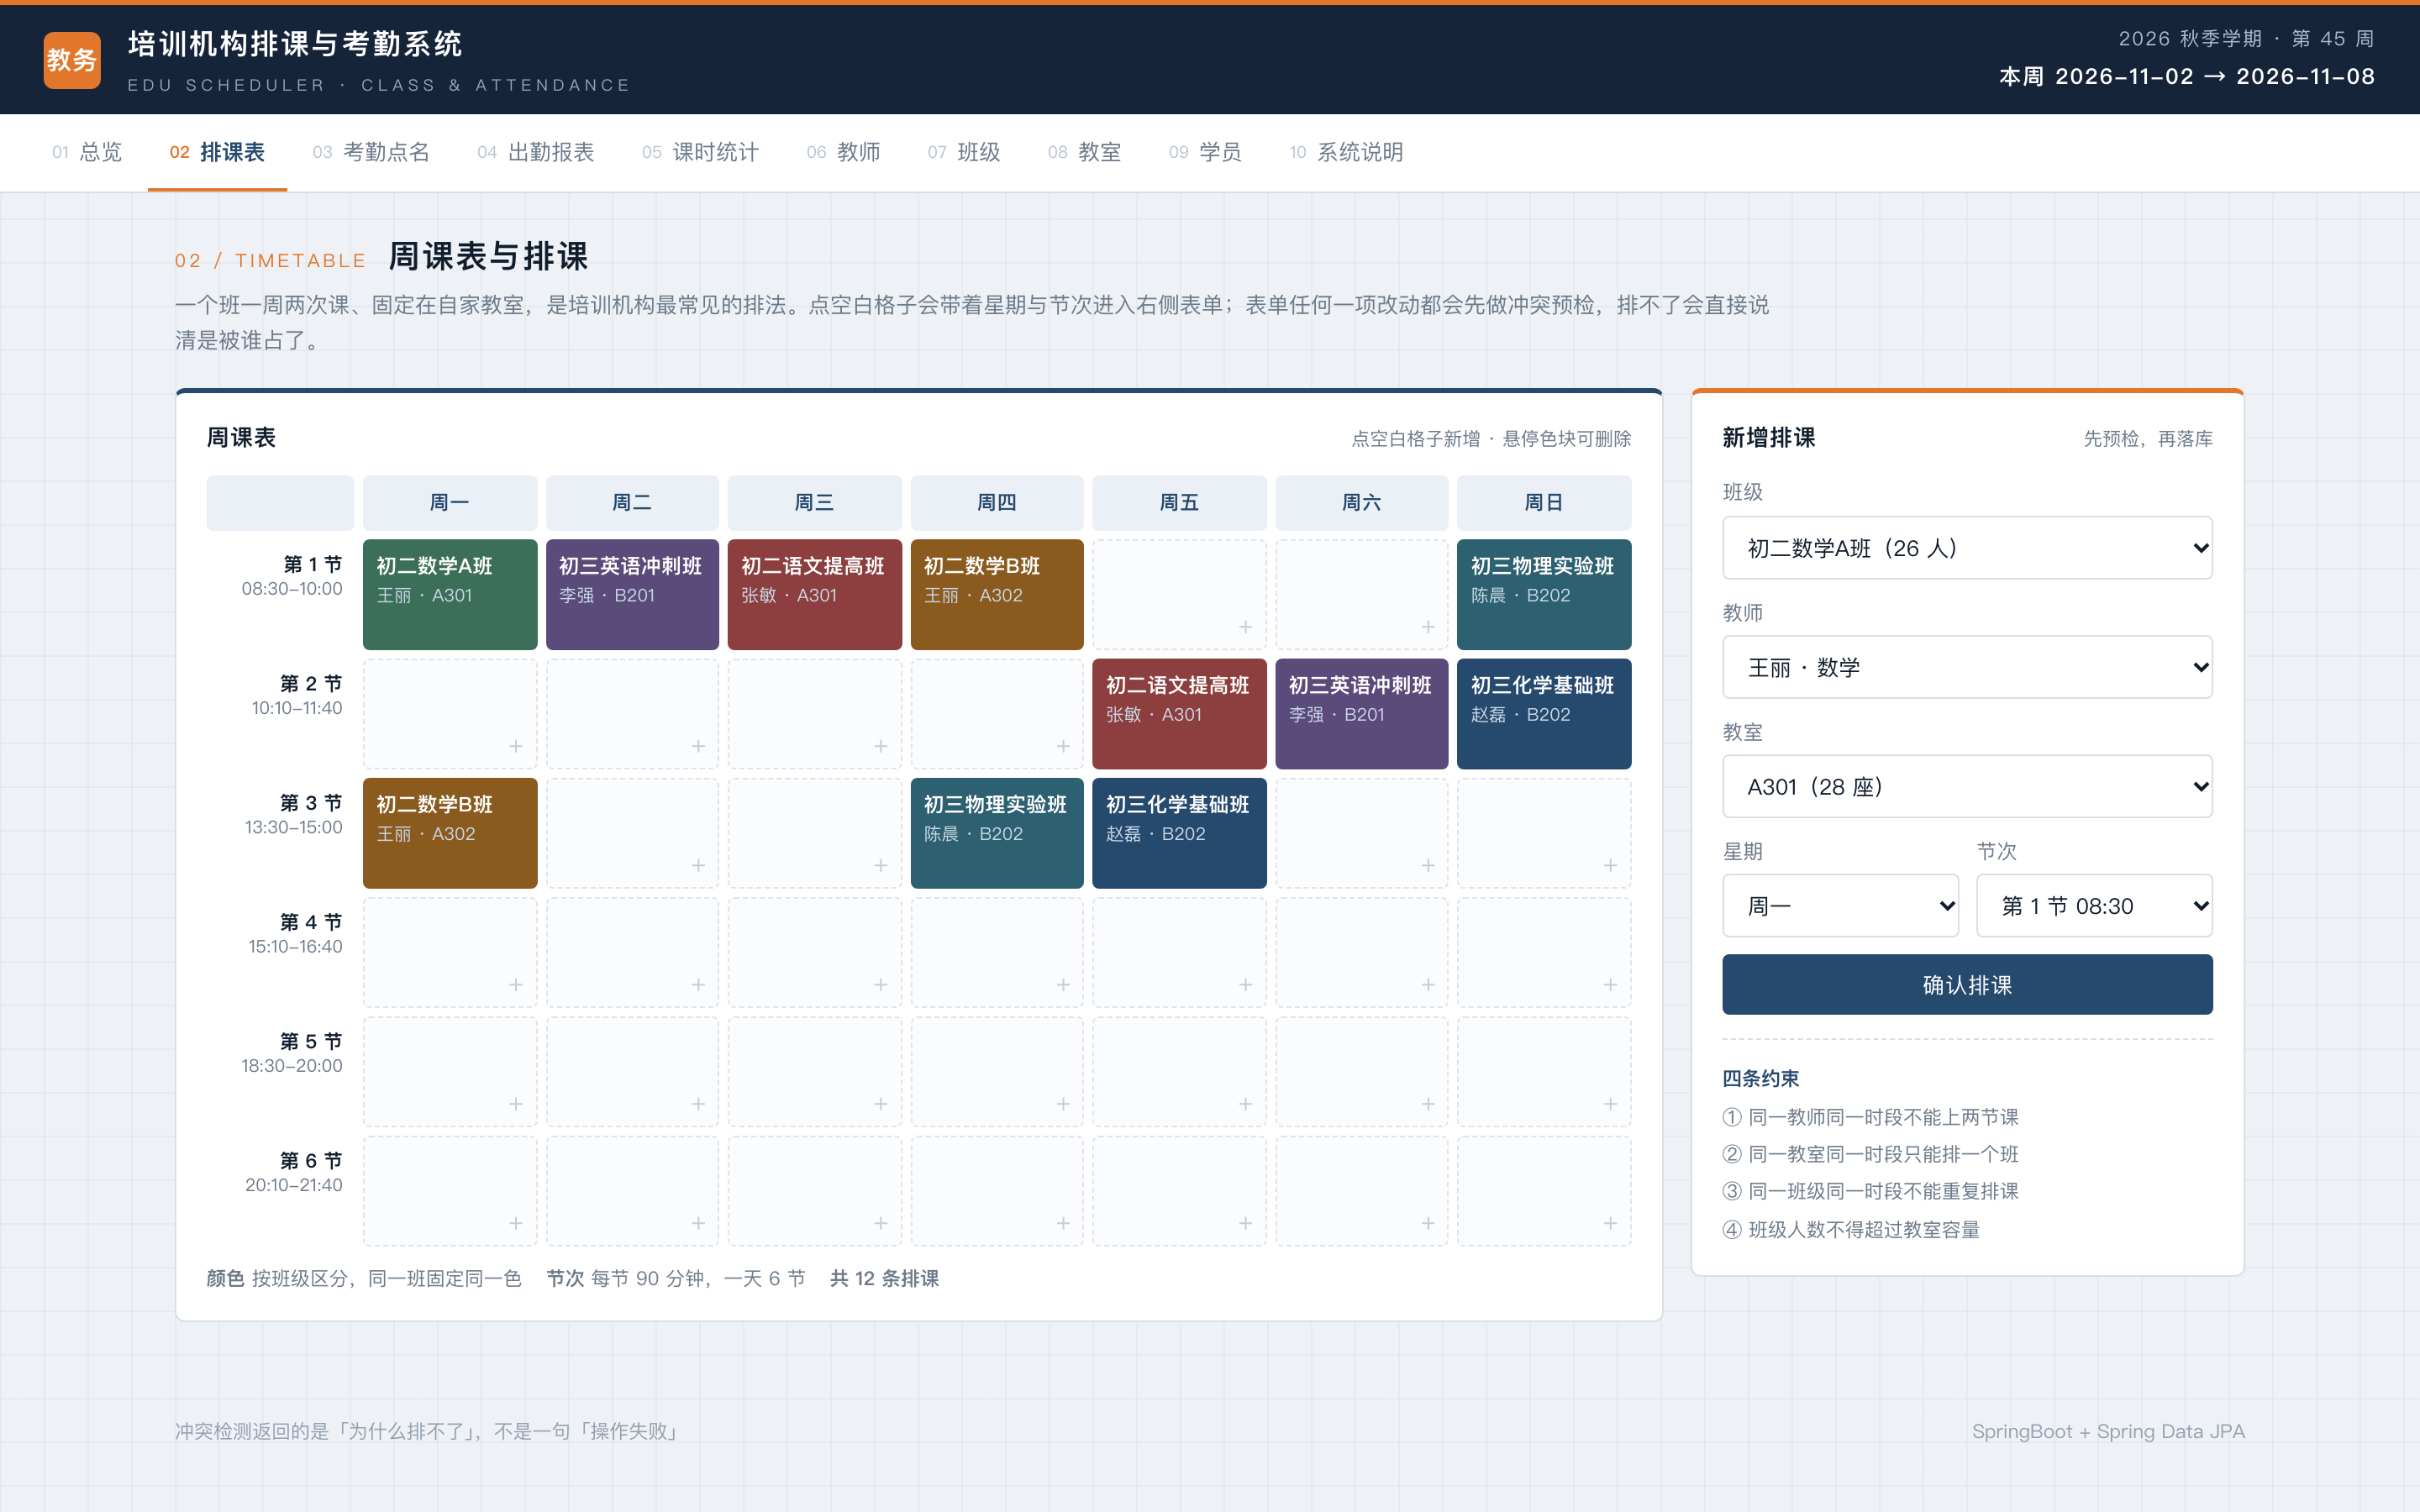
- 周课表网格:7 天 × 6 节用 CSS Grid 绘制,点空白格带入星期与节次发起排课,悬停色块可删除,选班级自动带出该班教师
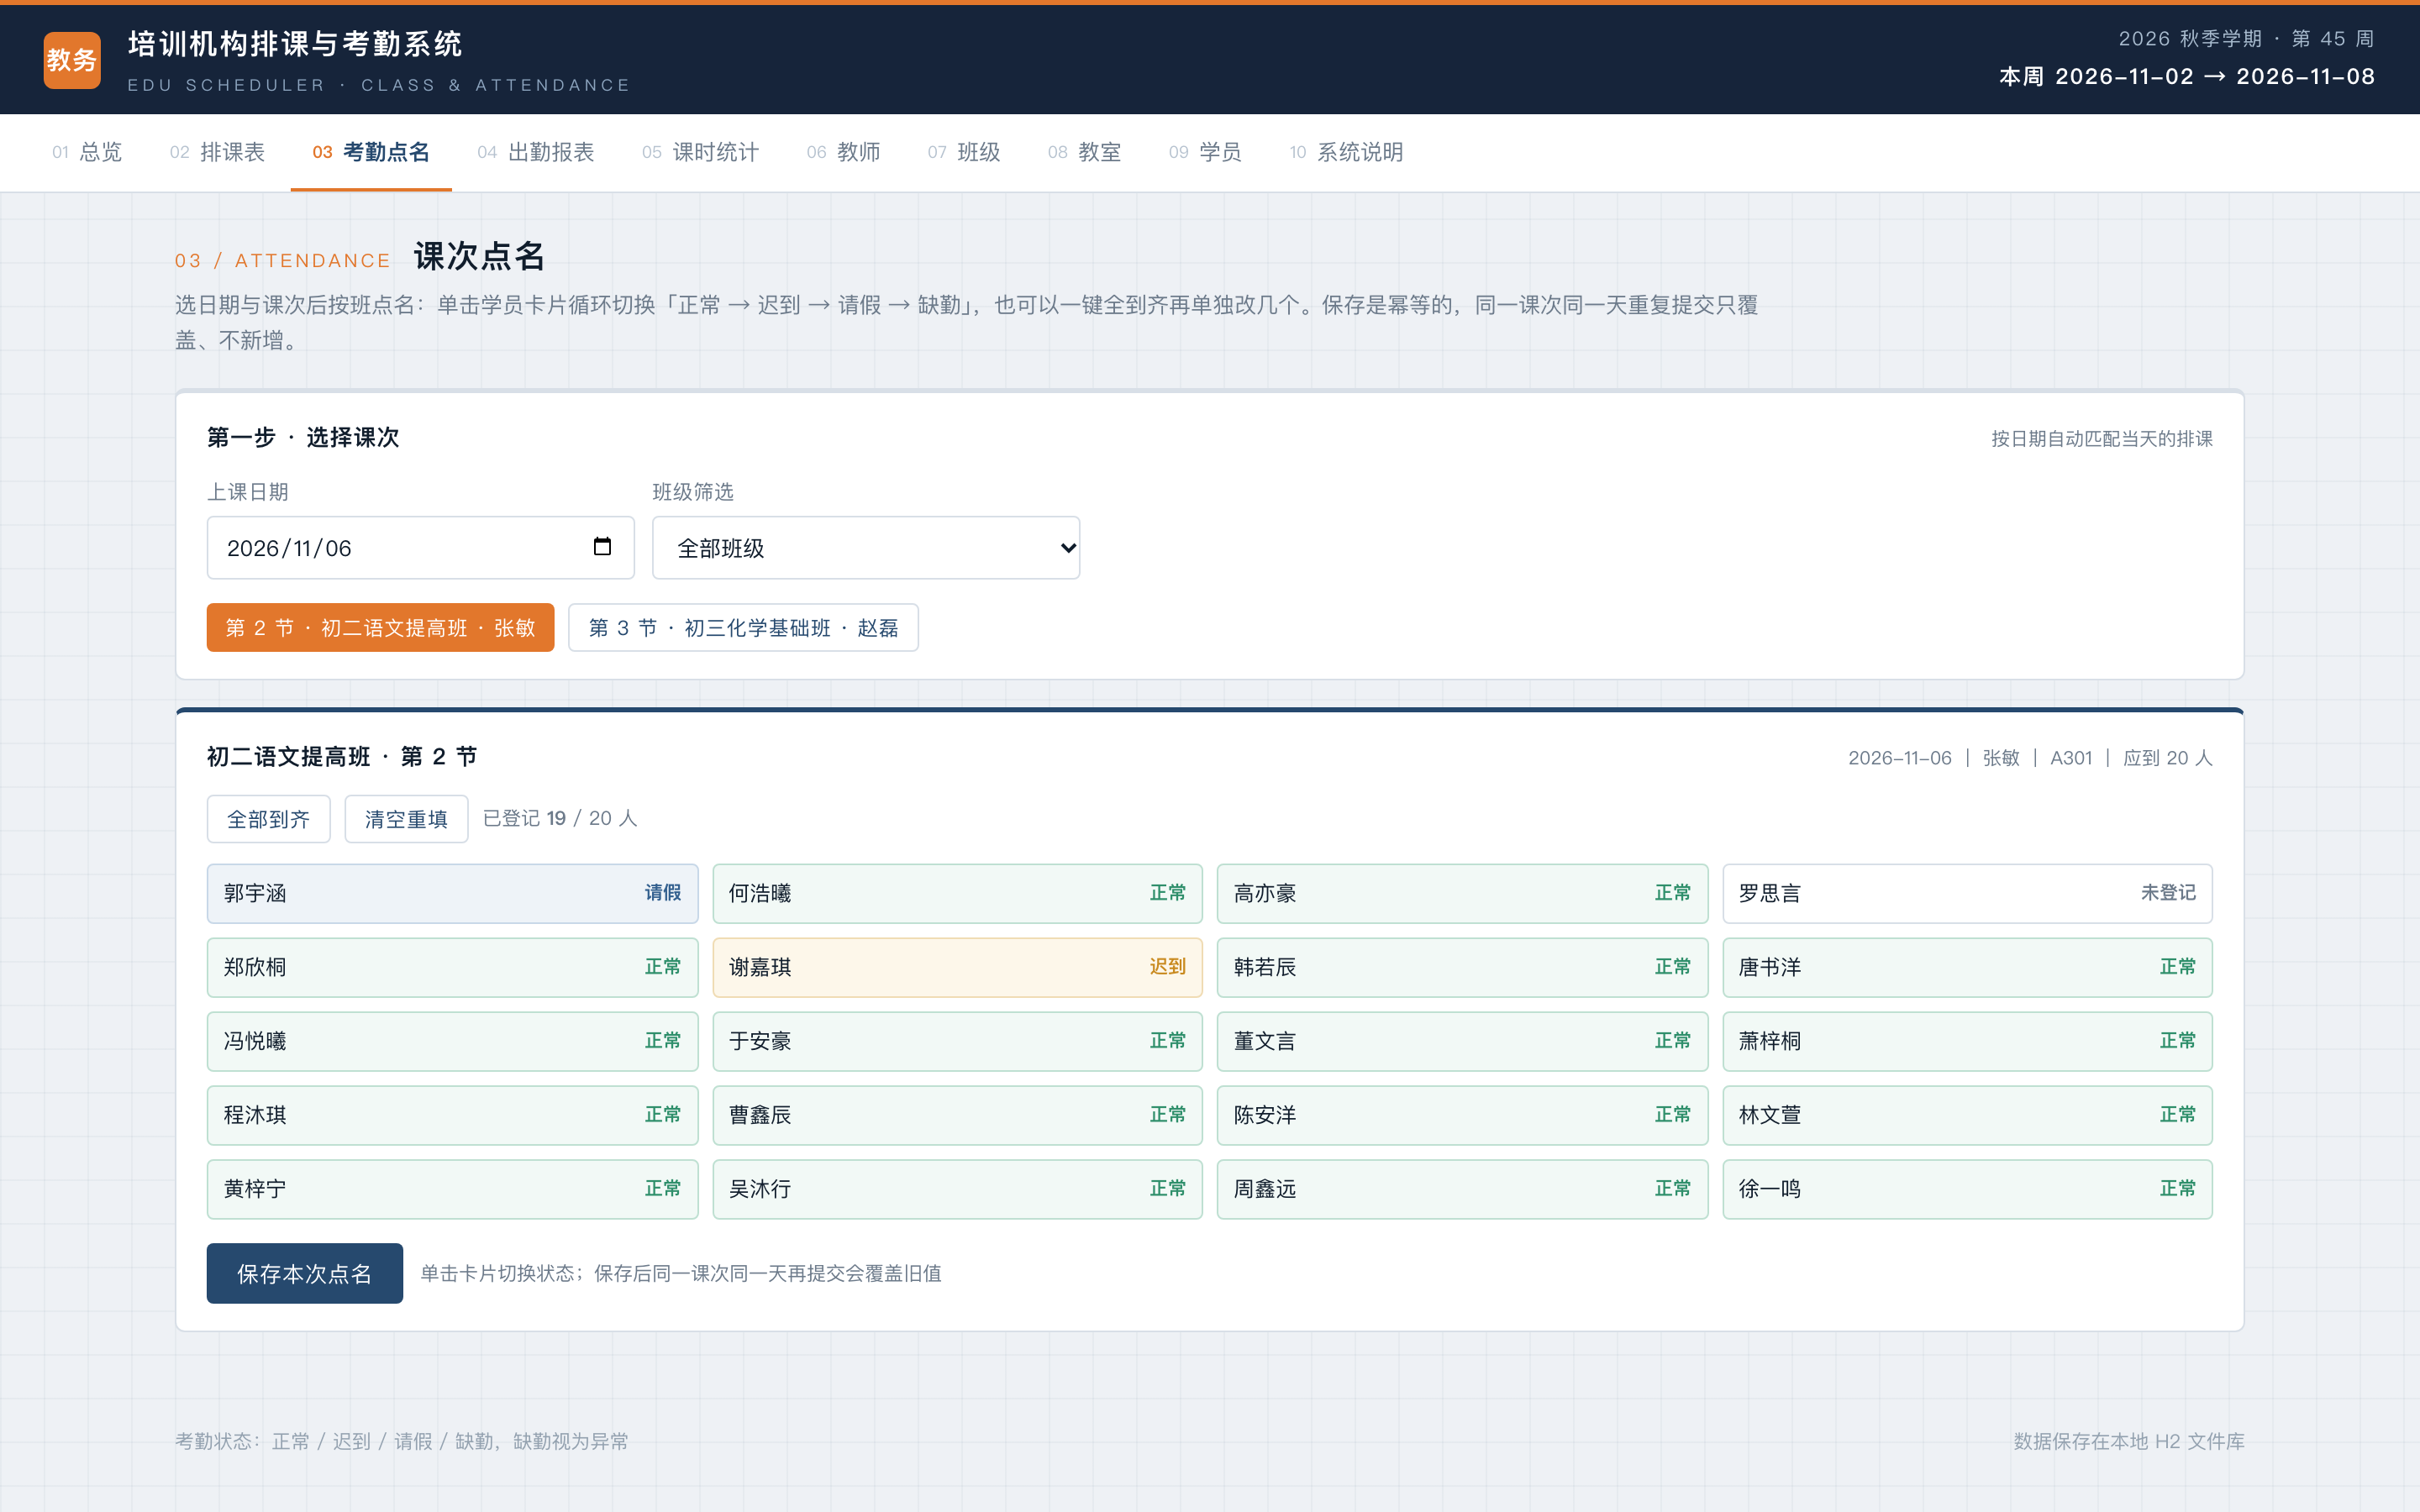
- 点名幂等:对「课次 + 日期 + 学员」覆盖写,重复提交不产生脏数据;未登记状态不默认成「正常」,避免漏点被算成到课
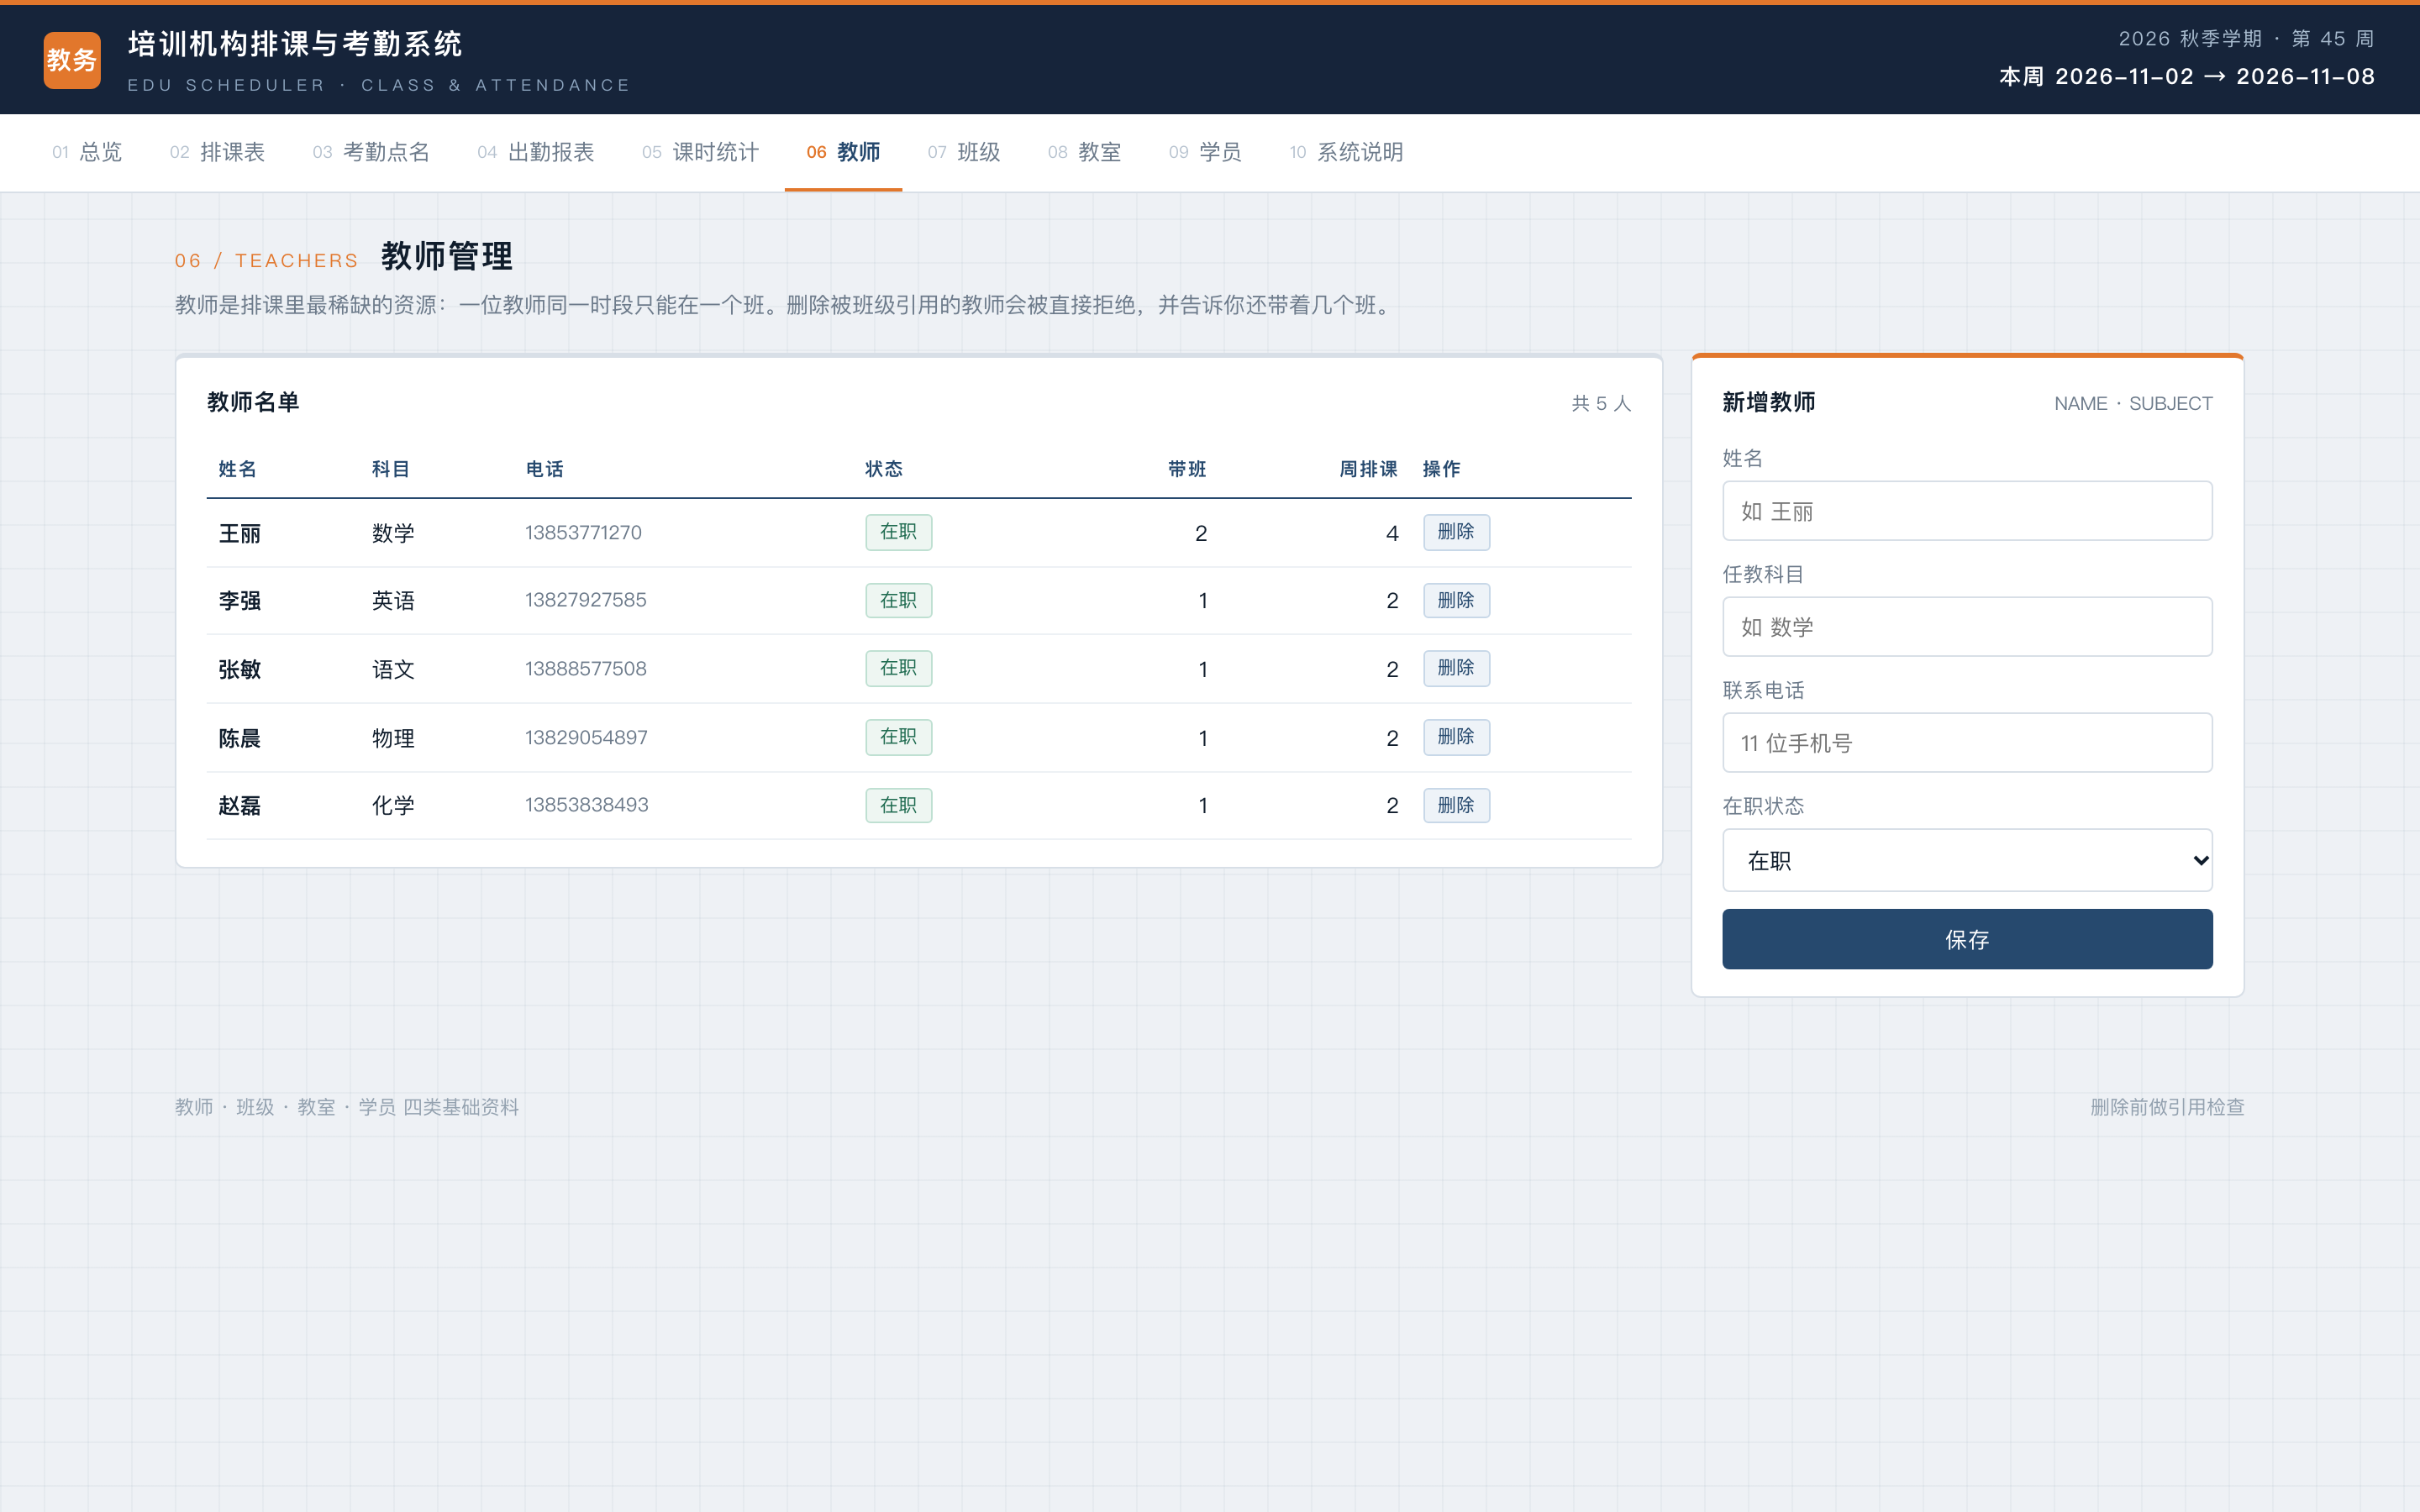
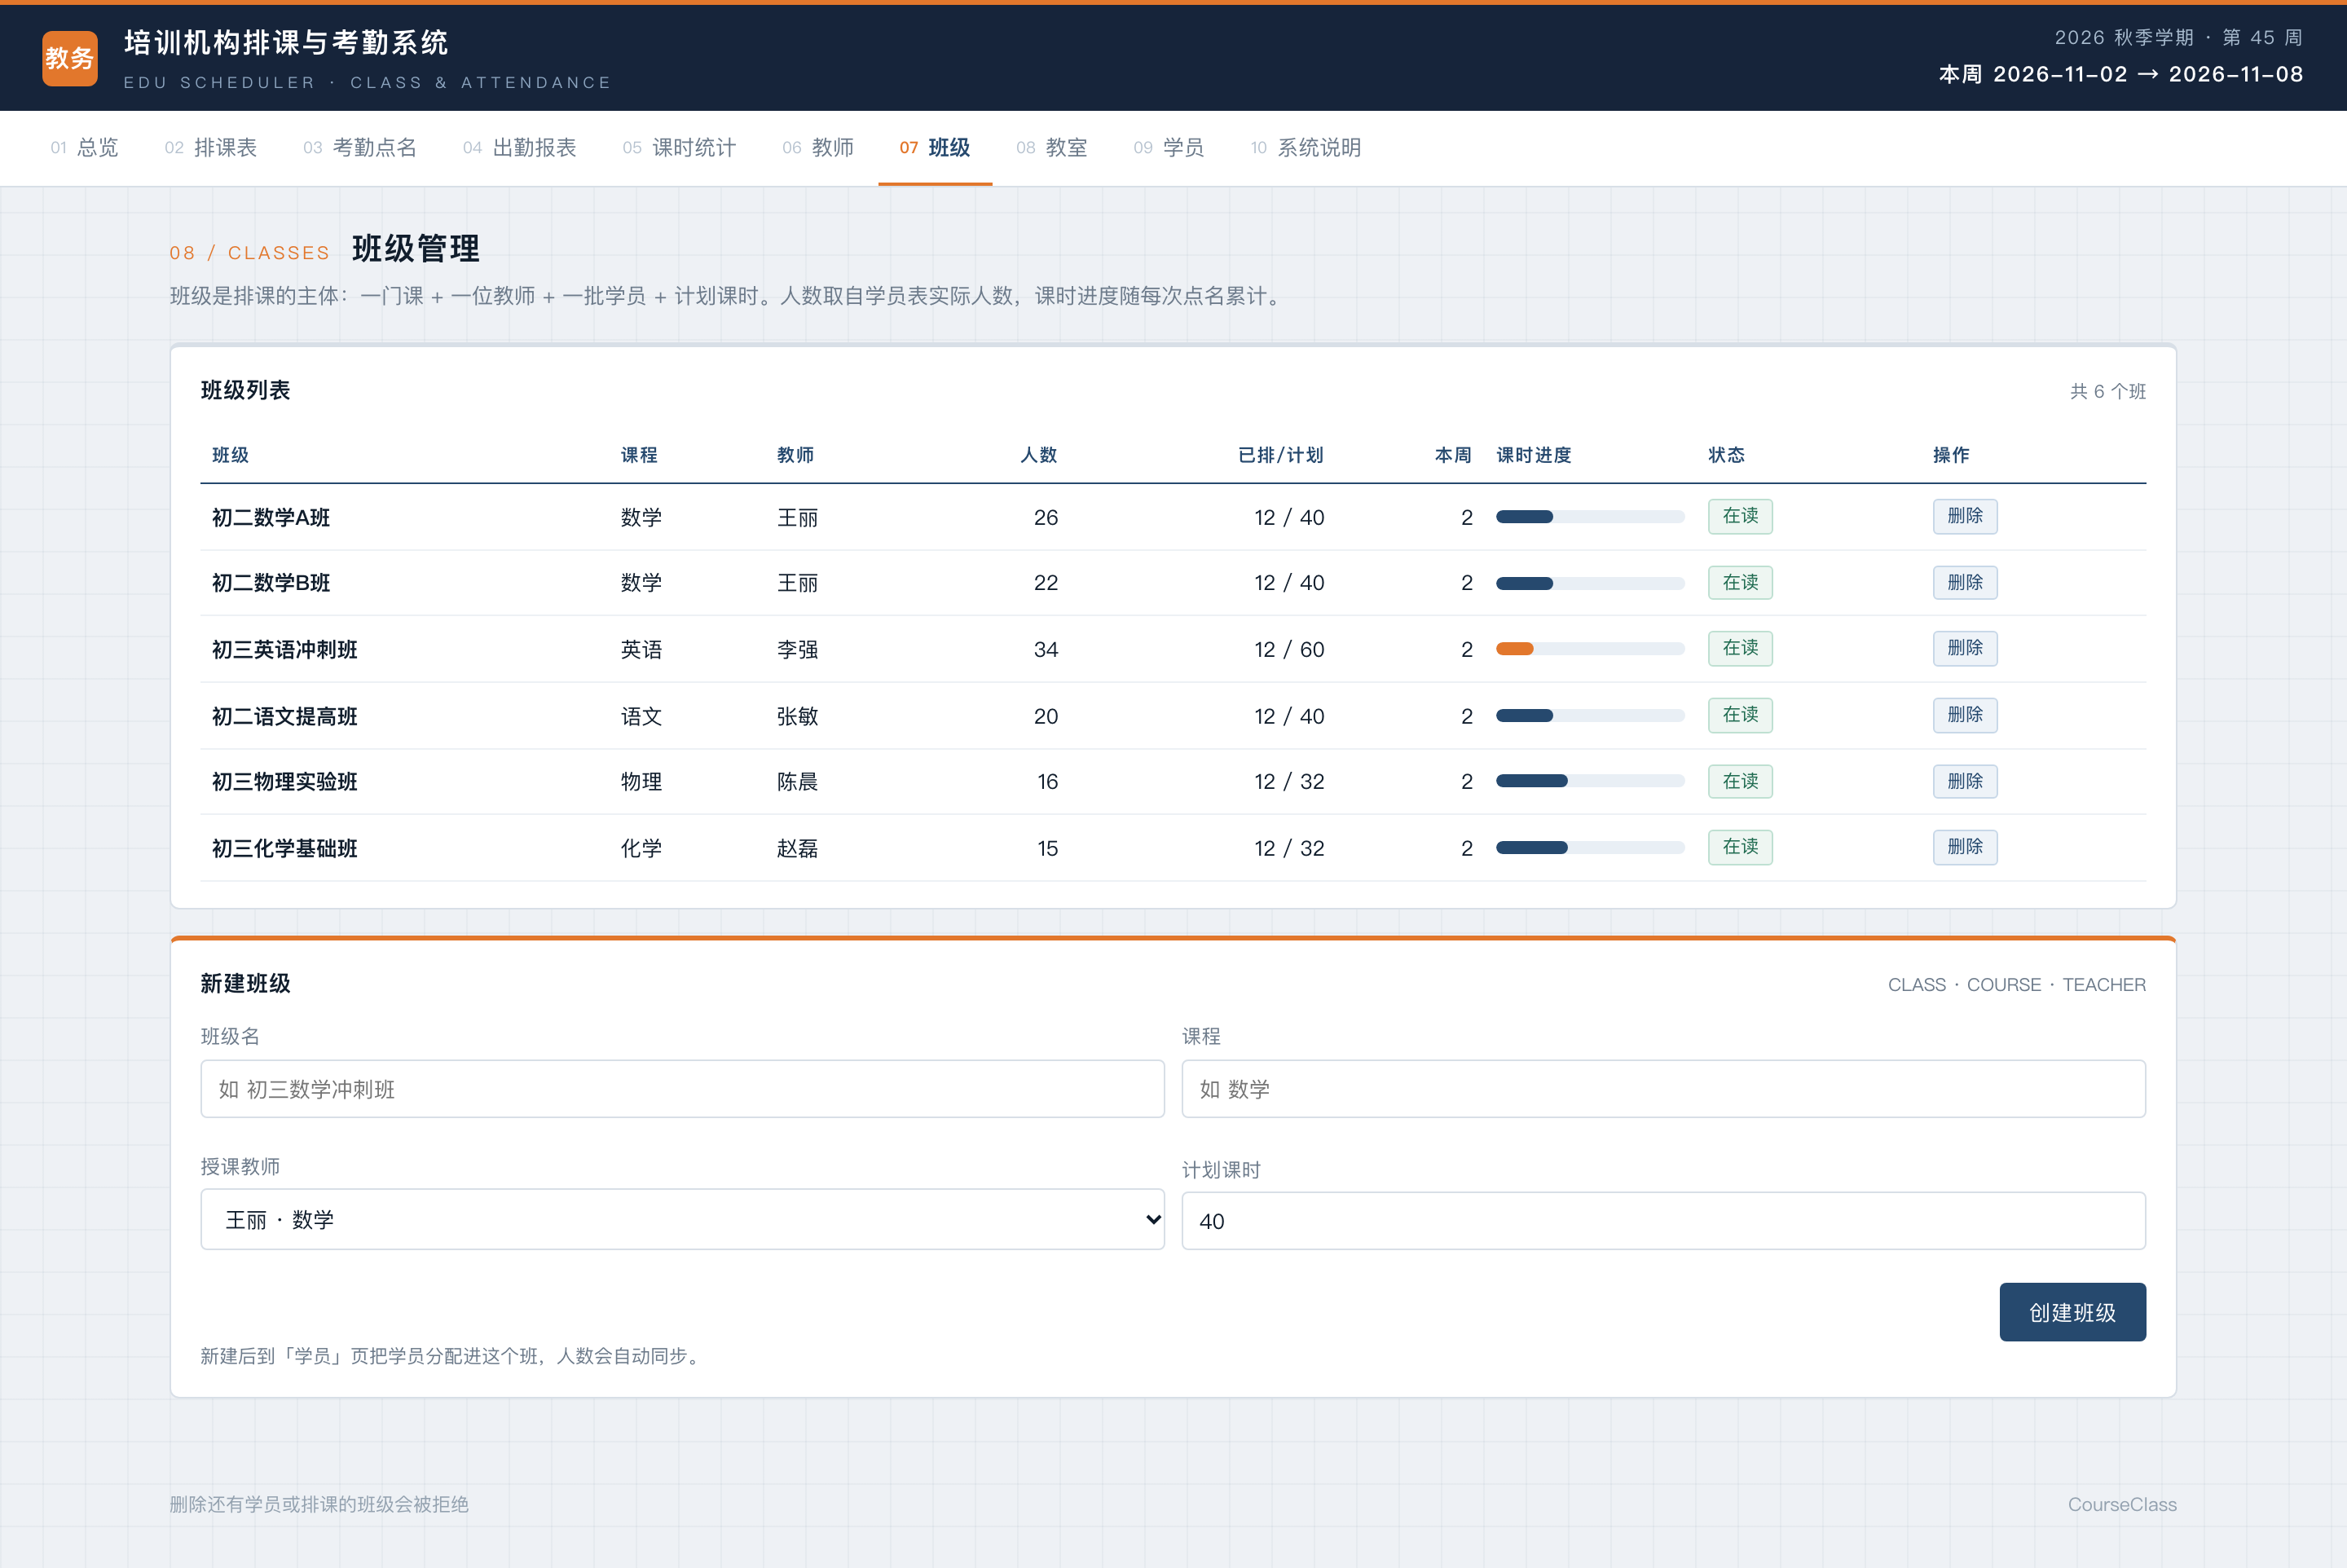
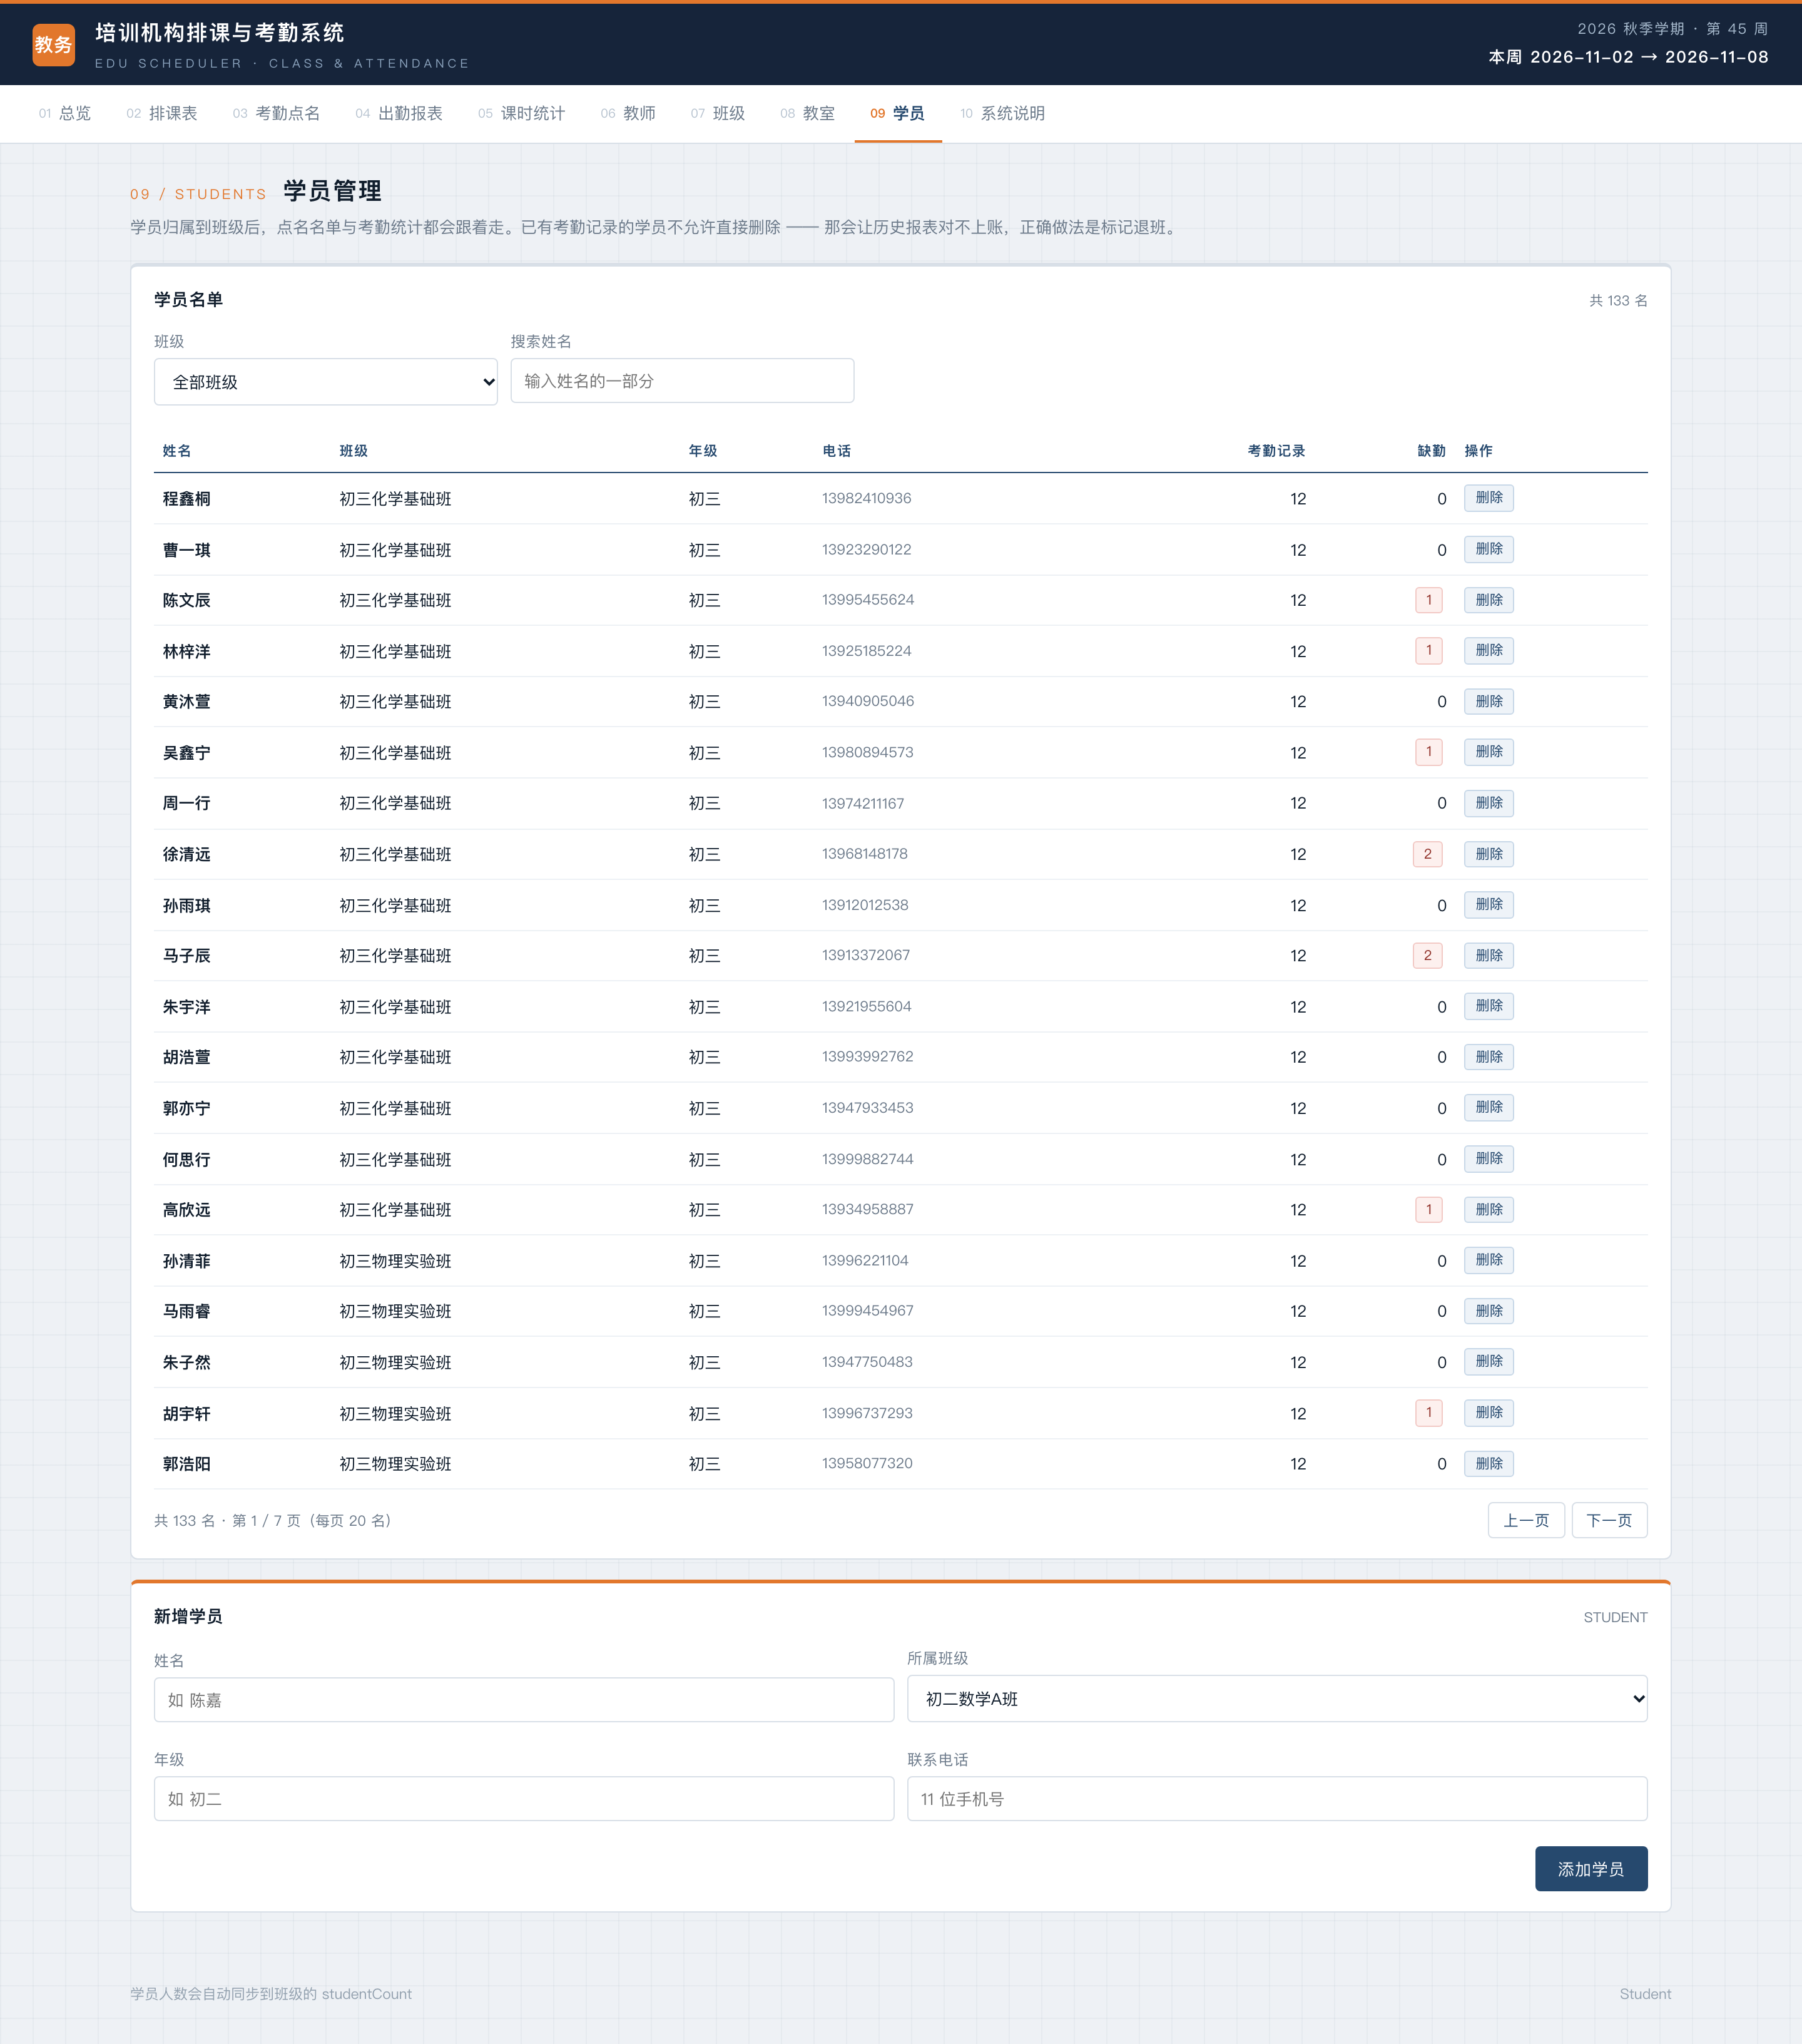
- 引用检查式删除:删被班级引用的教师、删还有学员或排课的班级、删已有考勤记录的学员,都会被拒绝并说明还被谁引用
- 出勤数据分析:6 周 1596 条记录,总体出勤率 91.4%(迟到 3.51% / 请假 2.76% / 缺勤 2.38%);迟到多于缺勤,说明管理重心在到课时间
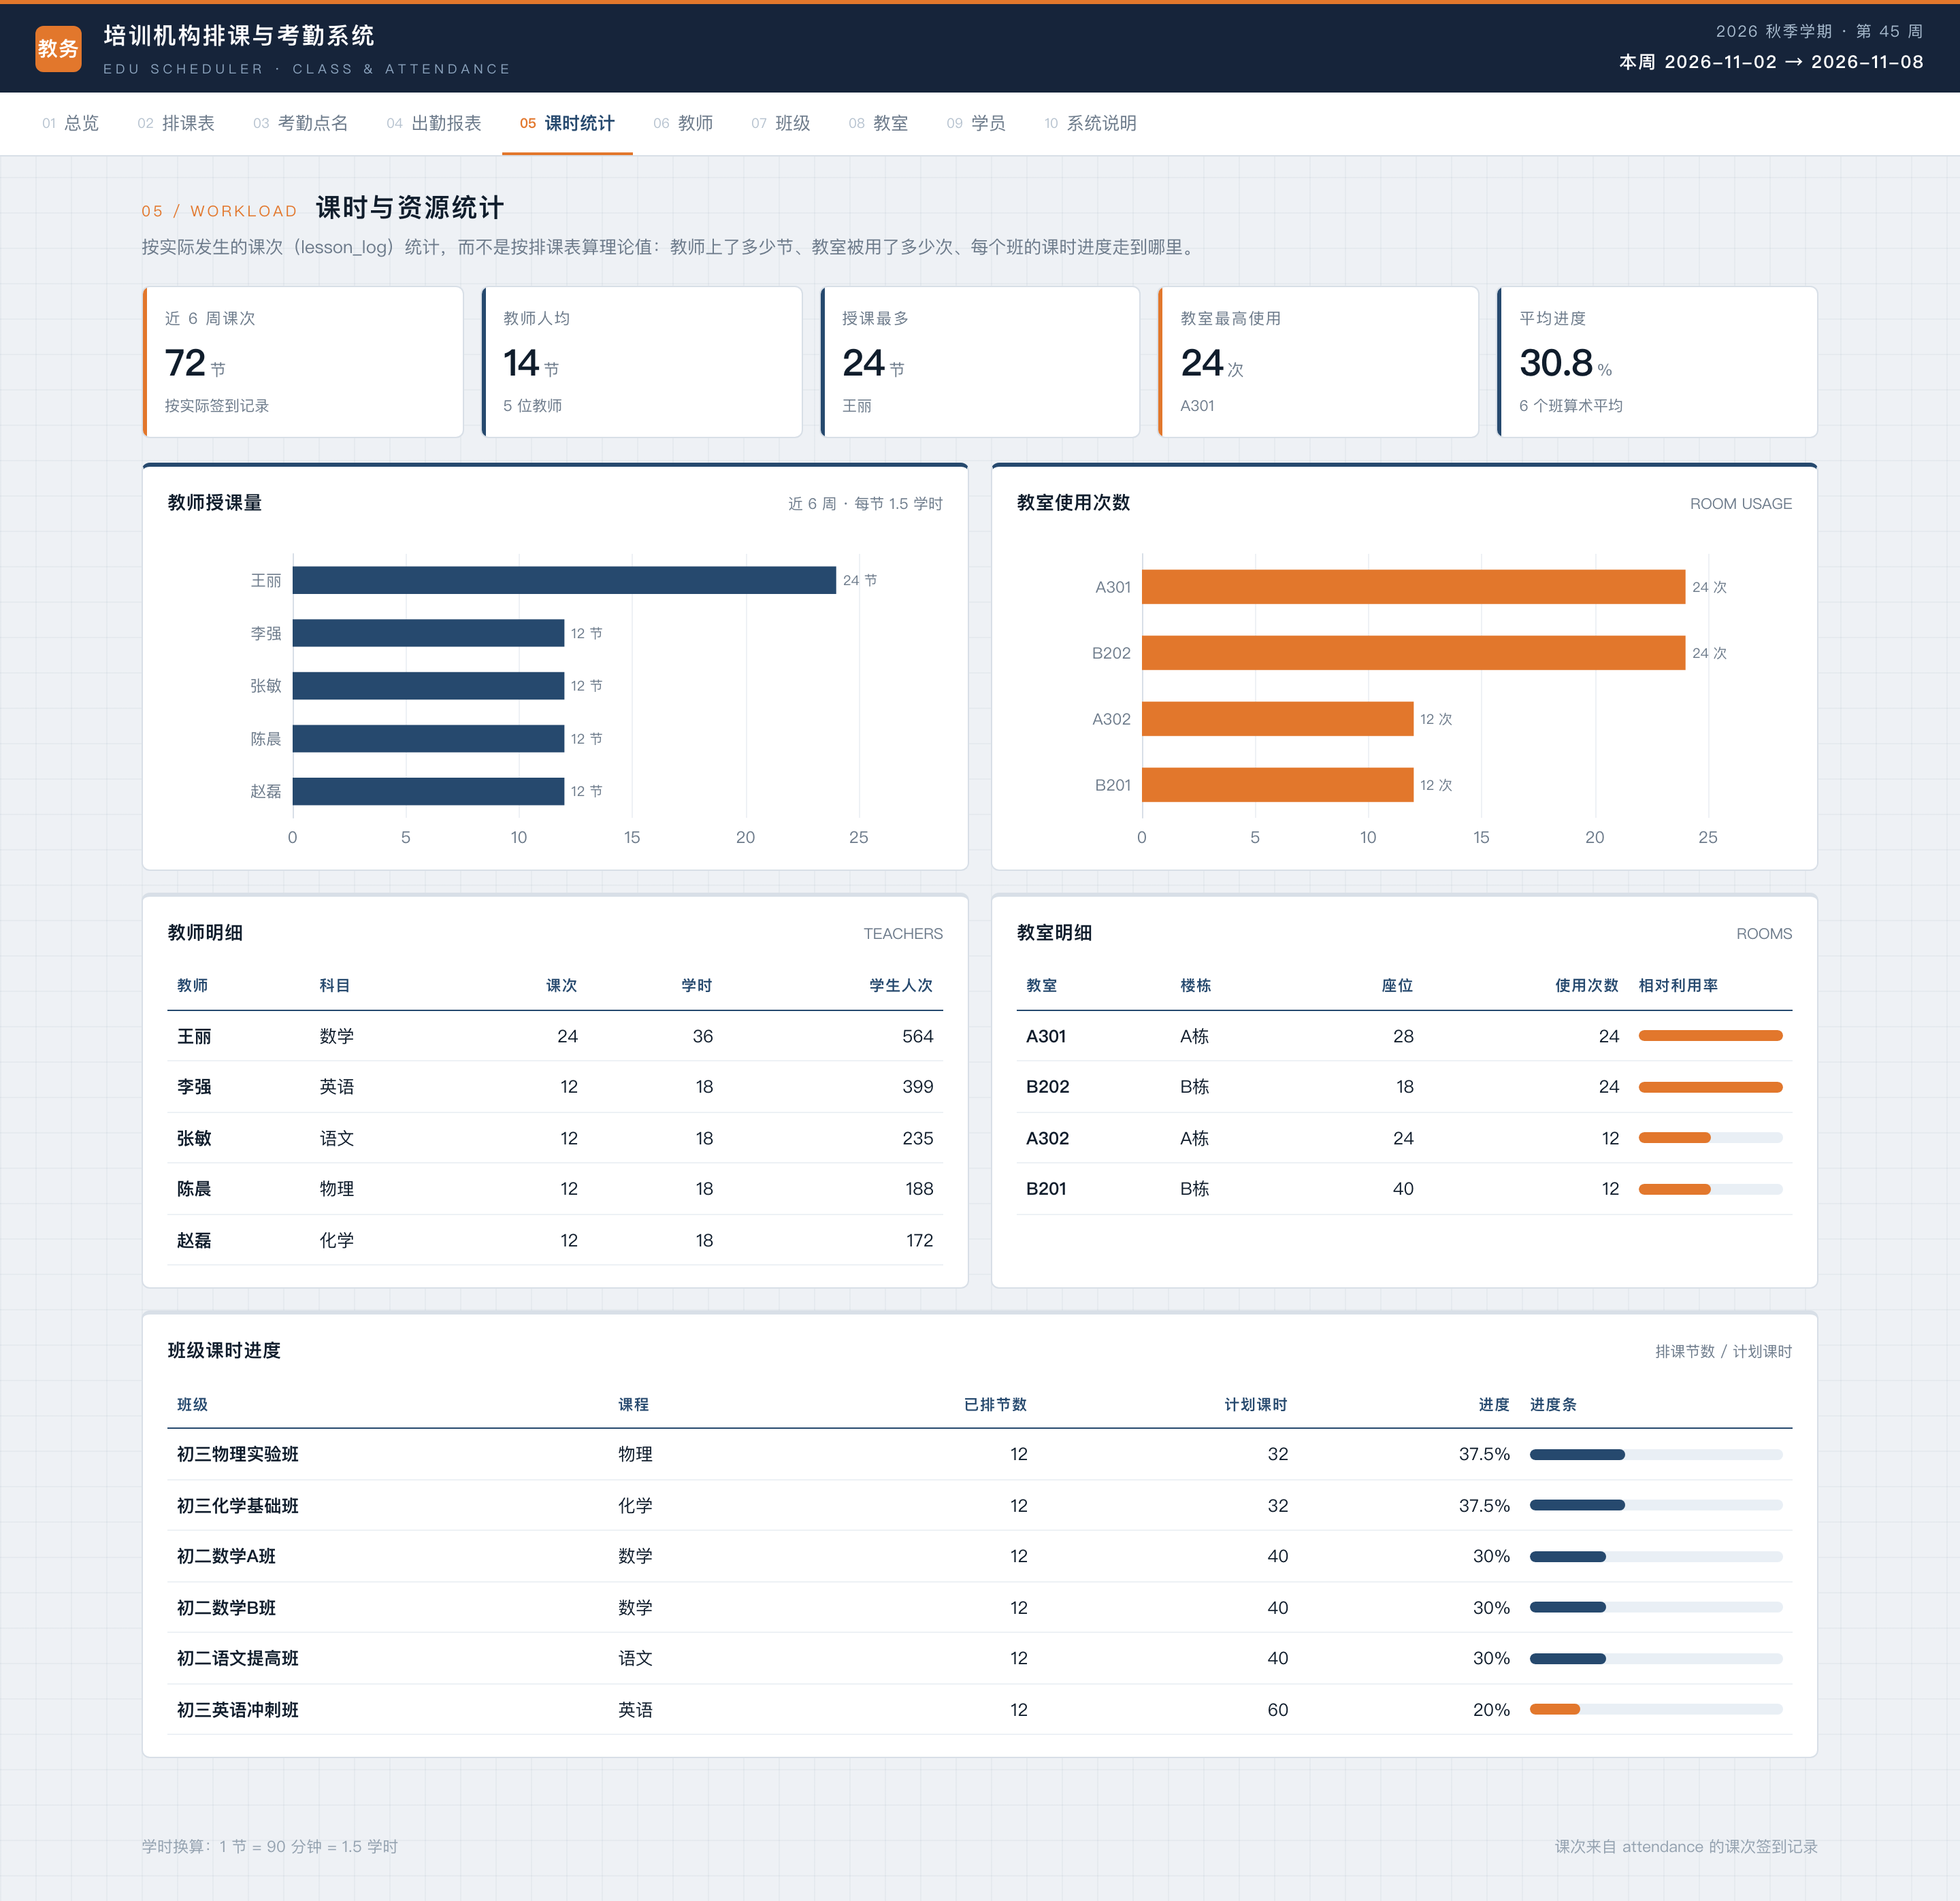
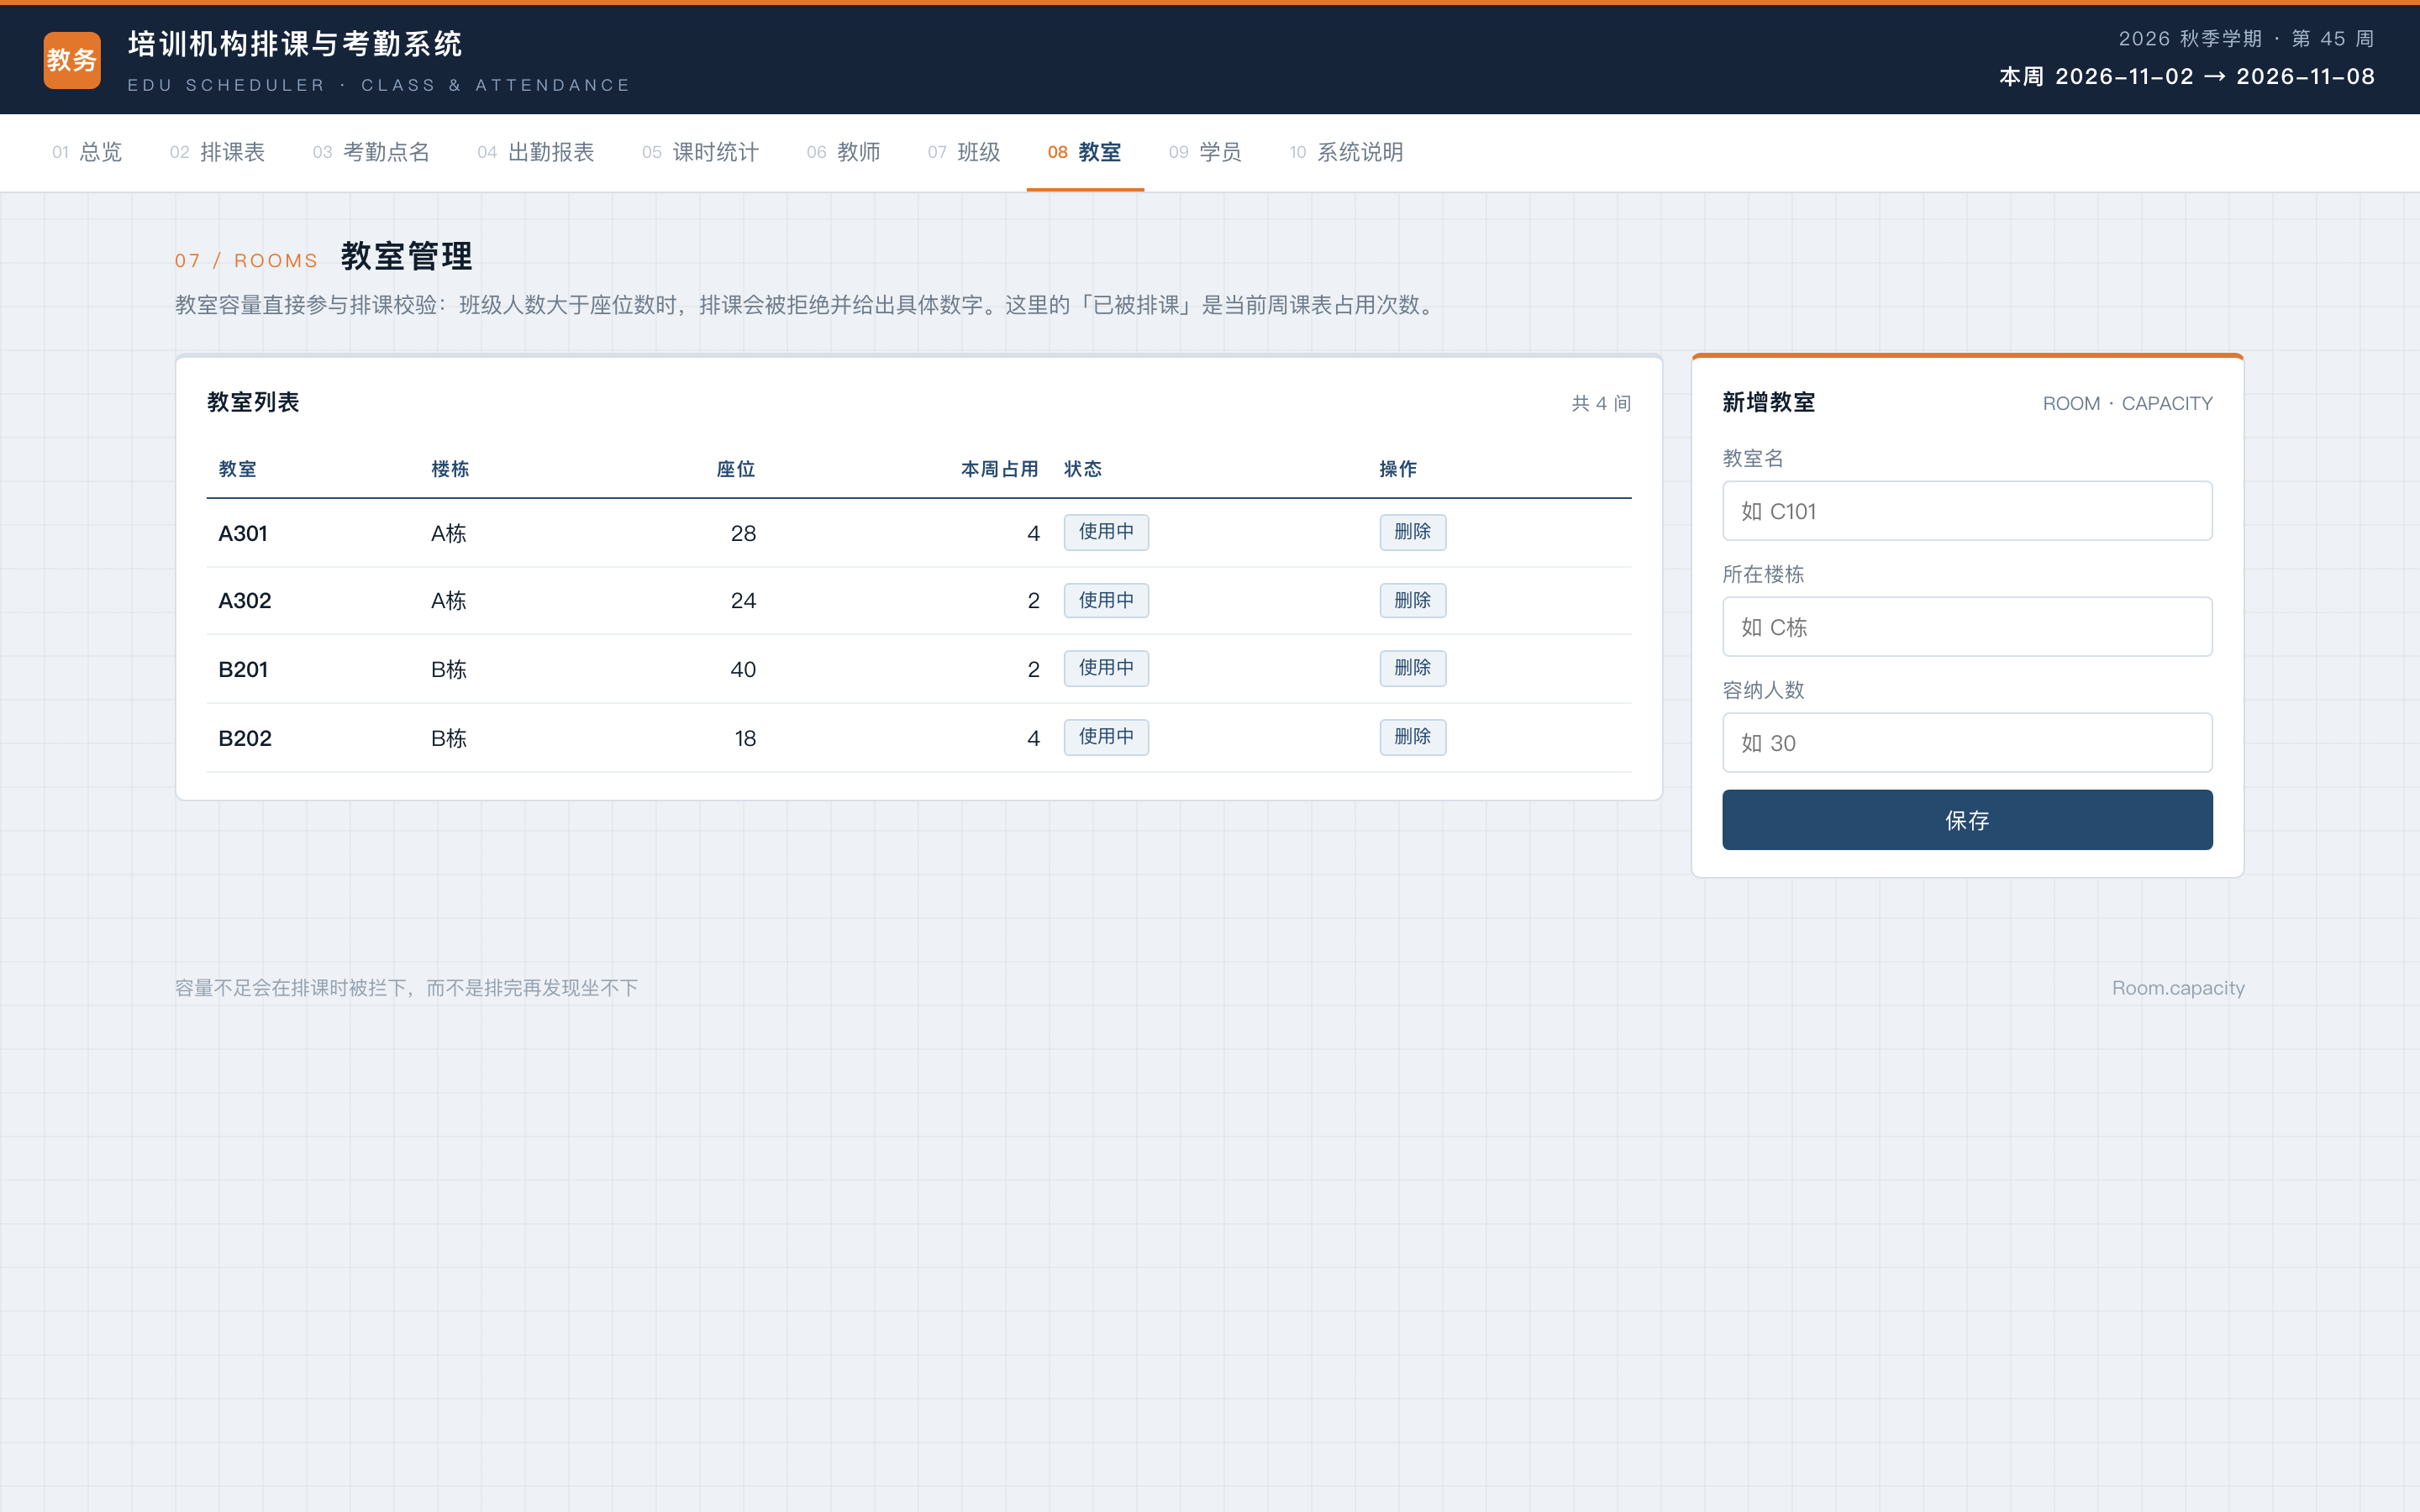
- 资源利用率:A301 与 B202 周使用 24 次满负荷、A302 与 B201 仅 12 次,暴露「一个班固定一间教室」策略下的容量错配
- 10 个页面:总览 / 排课表 / 考勤点名 / 出勤报表 / 课时统计 / 教师 / 班级 / 教室 / 学员 / 系统说明,ECharts 本地内置离线可用
交付内容
- 完整源码(7 张实体表 + 3 个控制器 + 冲突检测服务 + 演示数据生成器)
- 已灌好演示数据的 H2 库与可执行 jar(免安装、免联网构建)
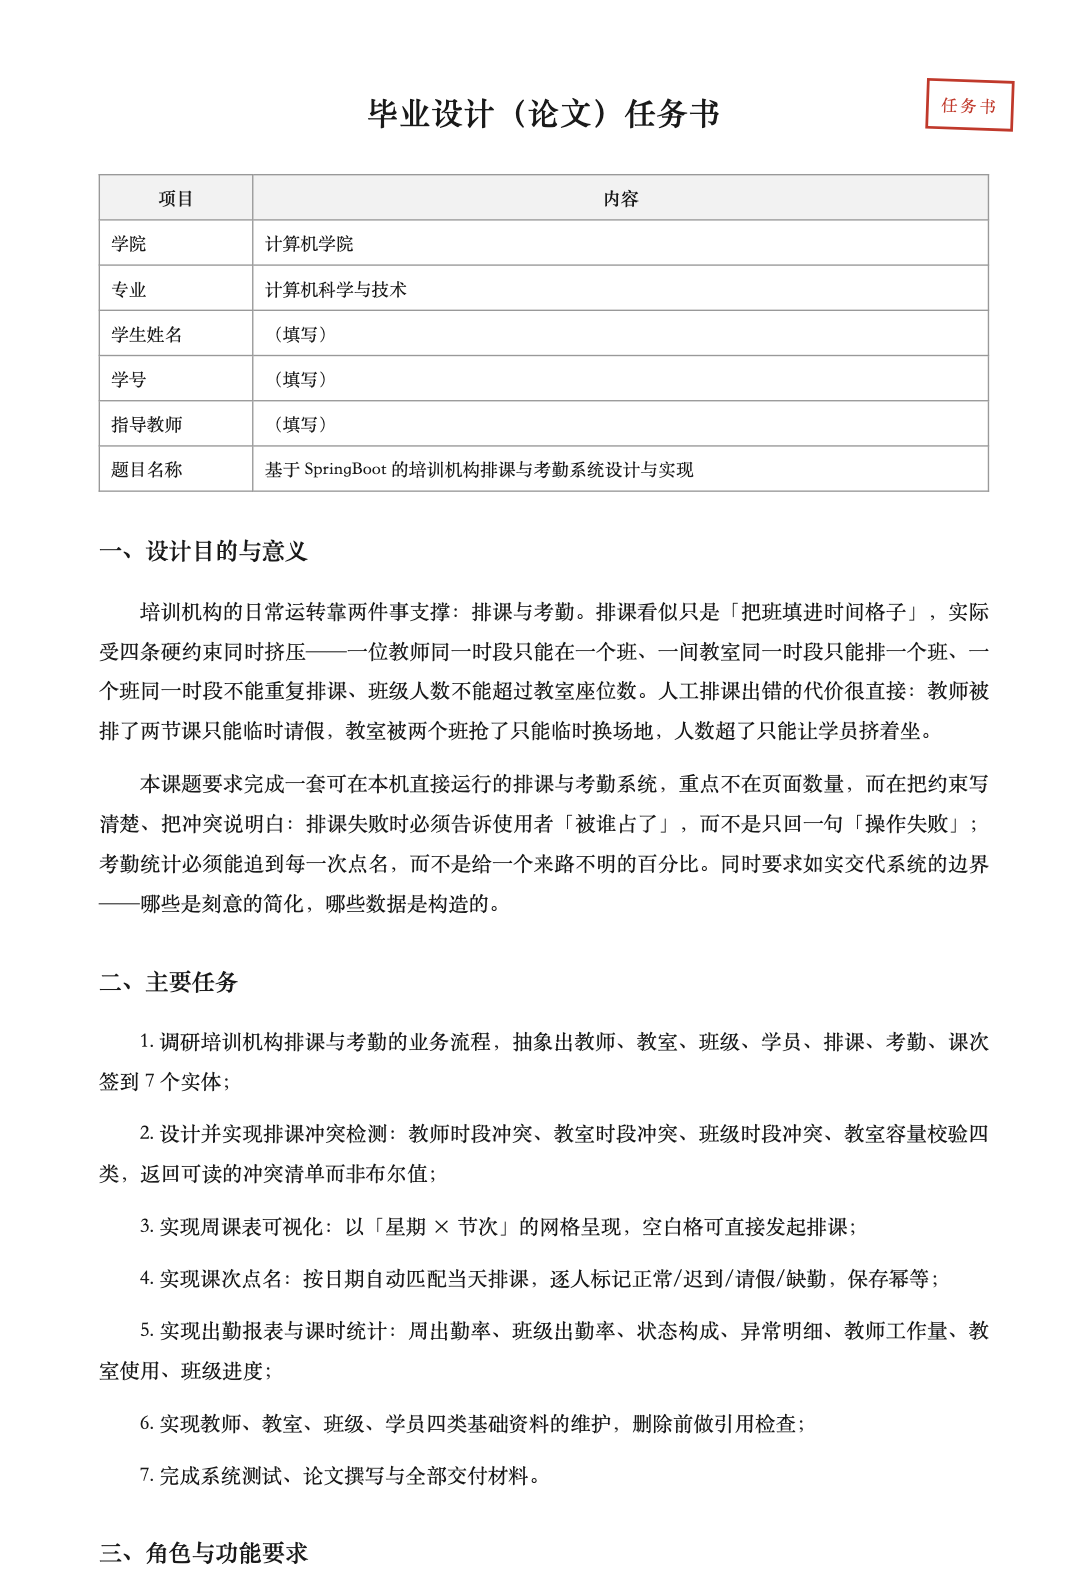
- 毕业设计任务书(Word)
- 毕业设计开题报告(Word)
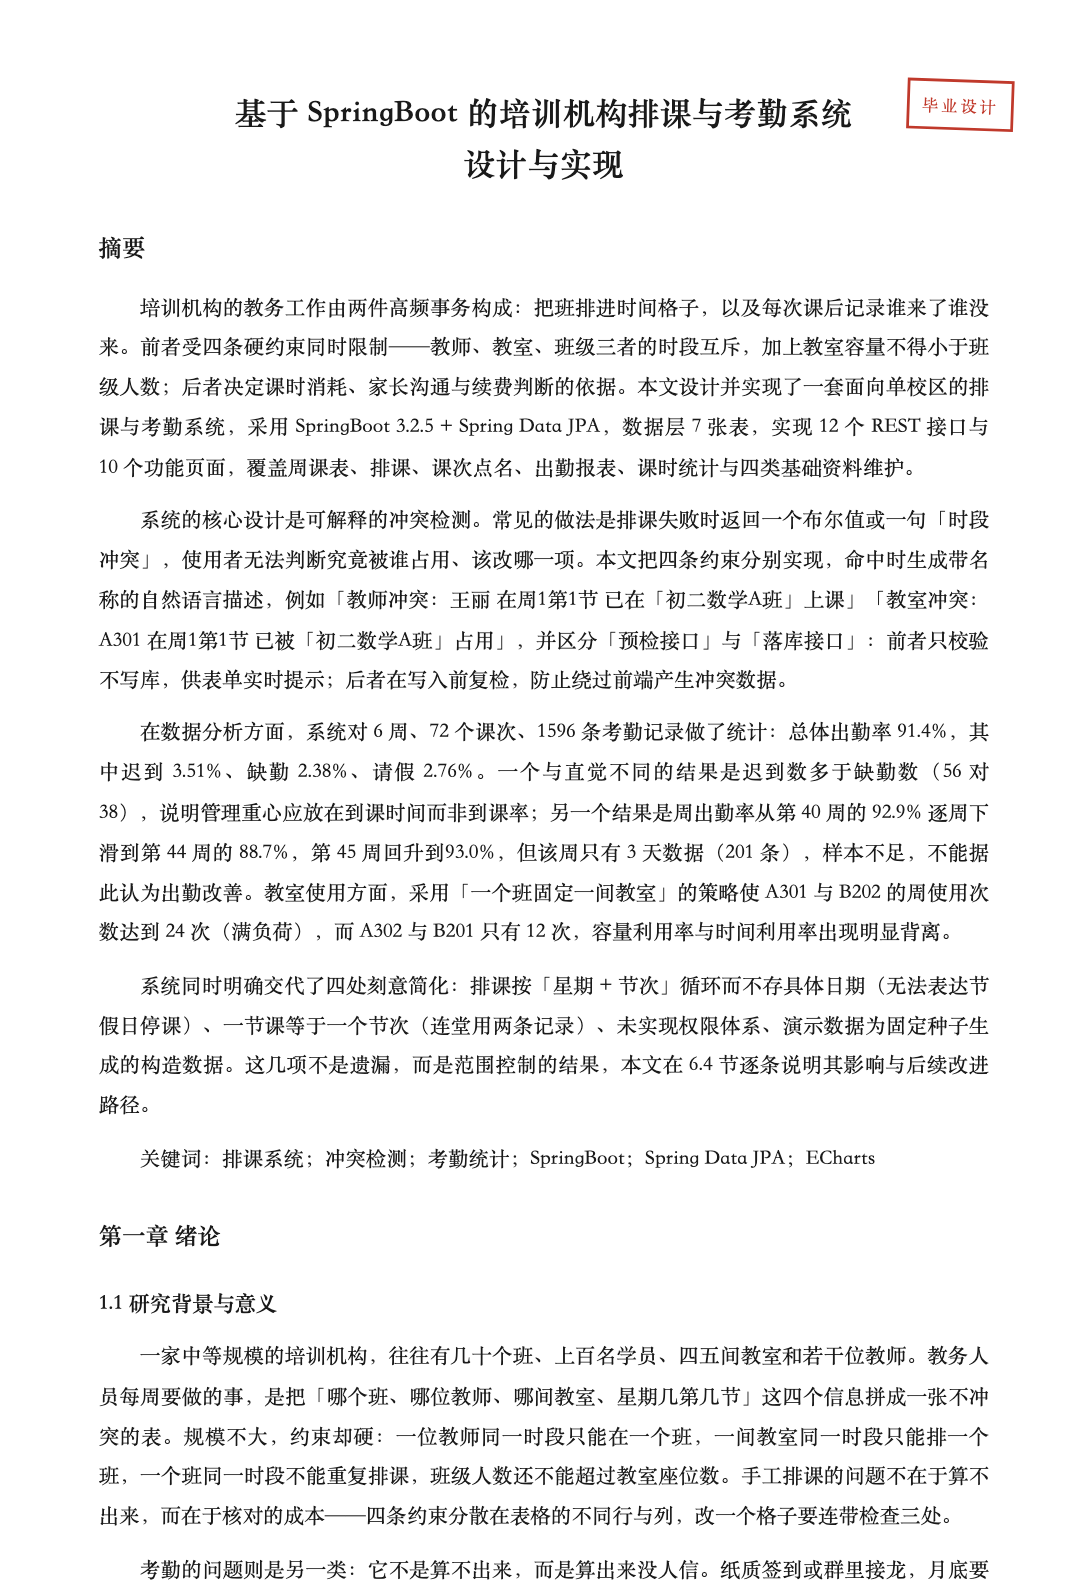
- 毕业论文(Word,七章制,含冲突检测设计、出勤数据分析与系统边界说明)
- 系统使用与二次开发说明(Word + md)
- 系统运行截图 10 张 + 功能演示视频
最终成品目录结构
下面是交付包里的真实目录,共 69 个文件。只展示文件名,不含文件内容; 点击文件夹可逐层展开,看到每个模块是怎么拆分的。
界面截图
点击任意一张可放大,支持左右切换(也可用键盘 ← → 键)
文档预览
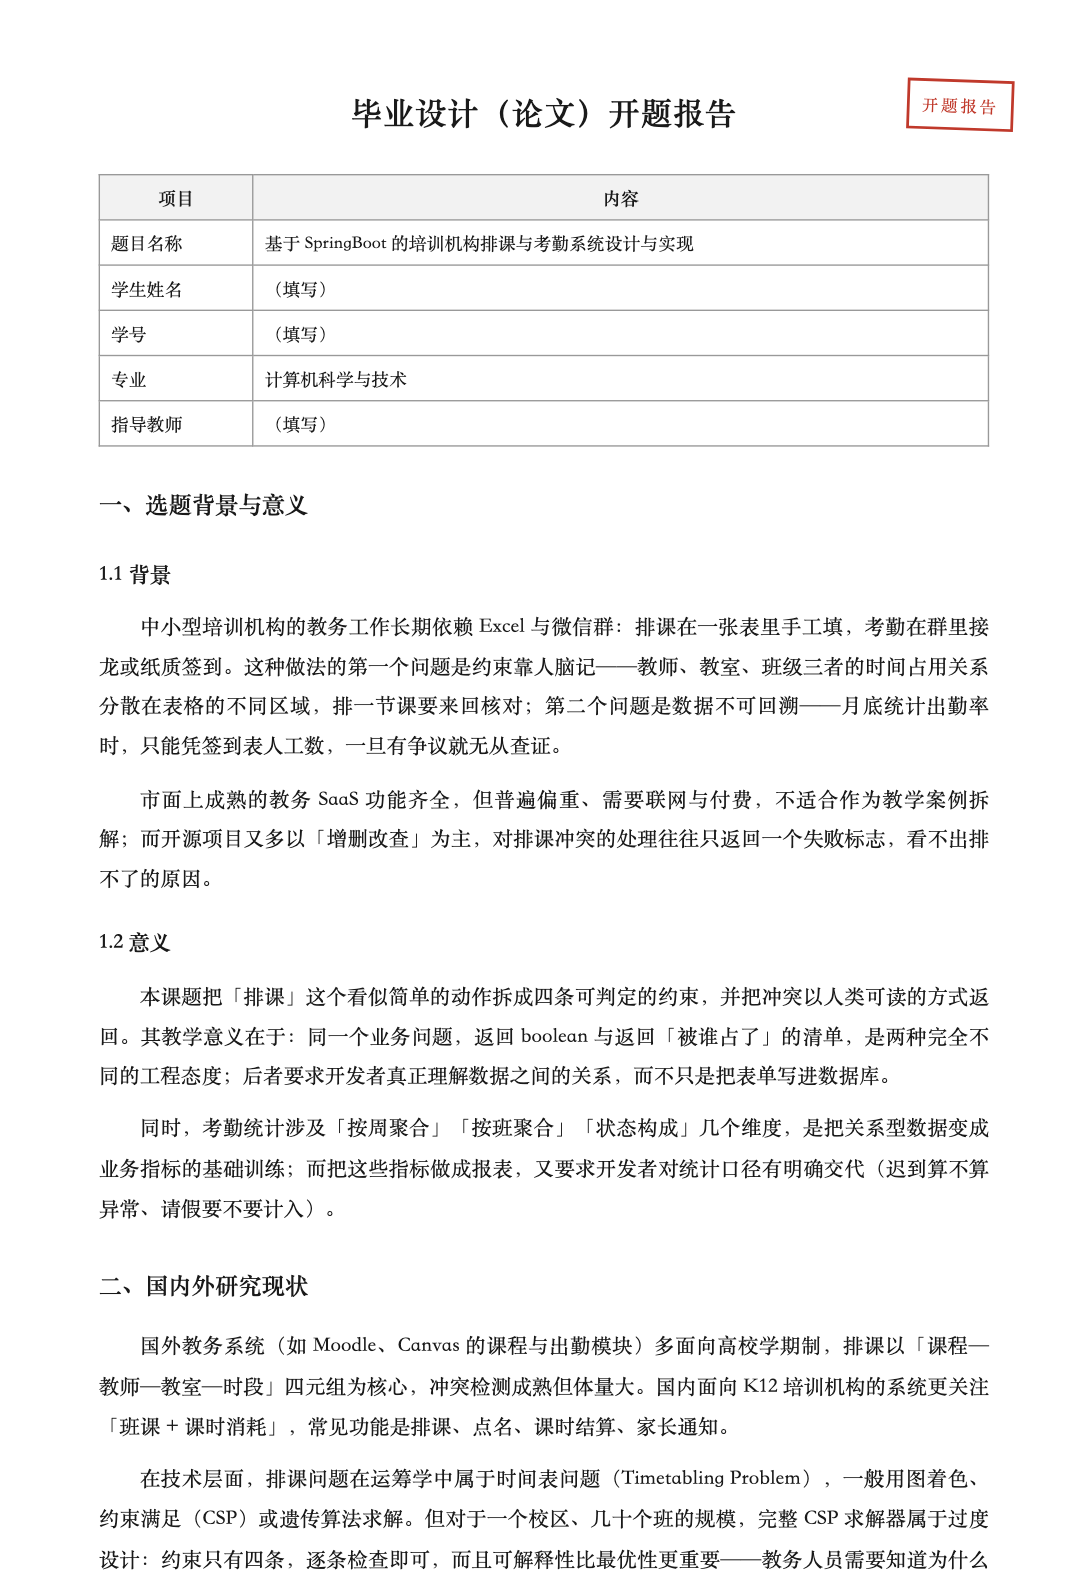
交付的任务书、开题报告与论文均为 Word 文档,下面是真实页面预览;点击可放大并左右切换:
常见问题
数据是真实的机构数据吗?
不是。培训机构的排课与学员信息属于机构私有资料,公开渠道没有可用数据集,因此教师、班级、学员、出勤记录全部由程序按固定随机种子生成(5 位教师 / 4 间教室 / 6 个班 / 133 名学员 / 12 条周排课 / 72 个课次 / 1596 条考勤)。固定种子是为了让论文里的每个数字都能复现——删掉 data 目录重启,得到的仍是同一组数据。页面与论文都标注了这一点。
那论文里的结论还有意义吗?
有意义,但要看清它说明的是什么:出勤率、迟到多于缺勤、课时进度差异,反映的是统计口径与数据生成规则;换成真实数据后,系统算的是同一套口径。这一点写在论文 6.1 与 6.5 节。
冲突检测到底怎么做的?
对一条待排记录,依次检查:同教师同(星期,节次)是否已有课、同教室同(星期,节次)是否被占、该班同(星期,节次)是否重复、班级人数是否超过教室容量。四条规则分别实现,返回 List<String> 而不是 boolean,因为四条可能同时命中,全部列出才有用。实现位置在 ScheduleService.conflicts()。
为什么不返回一个「成功/失败」就够了?
因为使用者需要知道「为什么排不了」。只回失败,教务只能反复试错;回「教师王丽 在周1第1节 已在初二数学A班上课」,他就能直接决定改教师还是改节次。这是本项目最主要的设计取向。
考勤重复提交会不会产生重复记录?
不会。保存时对「课次 + 日期 + 学员」做覆盖写,同一课次同一天重复提交只更新状态,并同步课次的实到/缺勤人数。
为什么「未登记」不默认成「正常」?
默认正常会让漏点的人被统计成到课,这是考勤系统最常见的失真来源。系统把未登记单独显示,报表只统计明确登记过的记录。
课时进度为什么这么低?
因为「计划课时 ÷ 每周节数」超过了学期长度:英语冲刺班 60 课时、每周 2 节,需要 30 周才上完,而一个学期通常 18~20 周。这不是 bug,恰恰是系统暴露出来的问题——排课还应做「节奏校验」,论文 6.4 节专门讨论了这一点。
教室明明空着,为什么提示教室冲突?
冲突只按「星期 + 节次」判断,与具体日期无关。同一间教室在同一星期的同一节次只能排一个班。系统采用按周循环的排课模型,代价是无法表达节假日停课与单次调课,这一点在「系统说明」页列为已知简化。
有哪几种角色?
演示版不区分角色,任何人都能访问全部 10 个页面。论文把「权限体系」列为后续工作:接入 Spring Security,教务可维护全部资料,教师只能看自己带的班并提交点名。
运行需要装什么?
只需要 JDK 17 及以上。不需要 MySQL、Tomcat、Node.js;H2 文件库随包、ECharts 本地内置,断网也能完整浏览。双击启动脚本即可,端口 8089。
常见报错怎么办?
端口占用换 8090;白屏多半是端口不对(看启动日志里 Tomcat started on port);改了页面不生效是因为静态资源已打进 jar,需要重新 package。说明文档第七节给了完整对照表。