基于知识图谱的医学疾病问答与辅助诊断系统设计与实现
项目简介
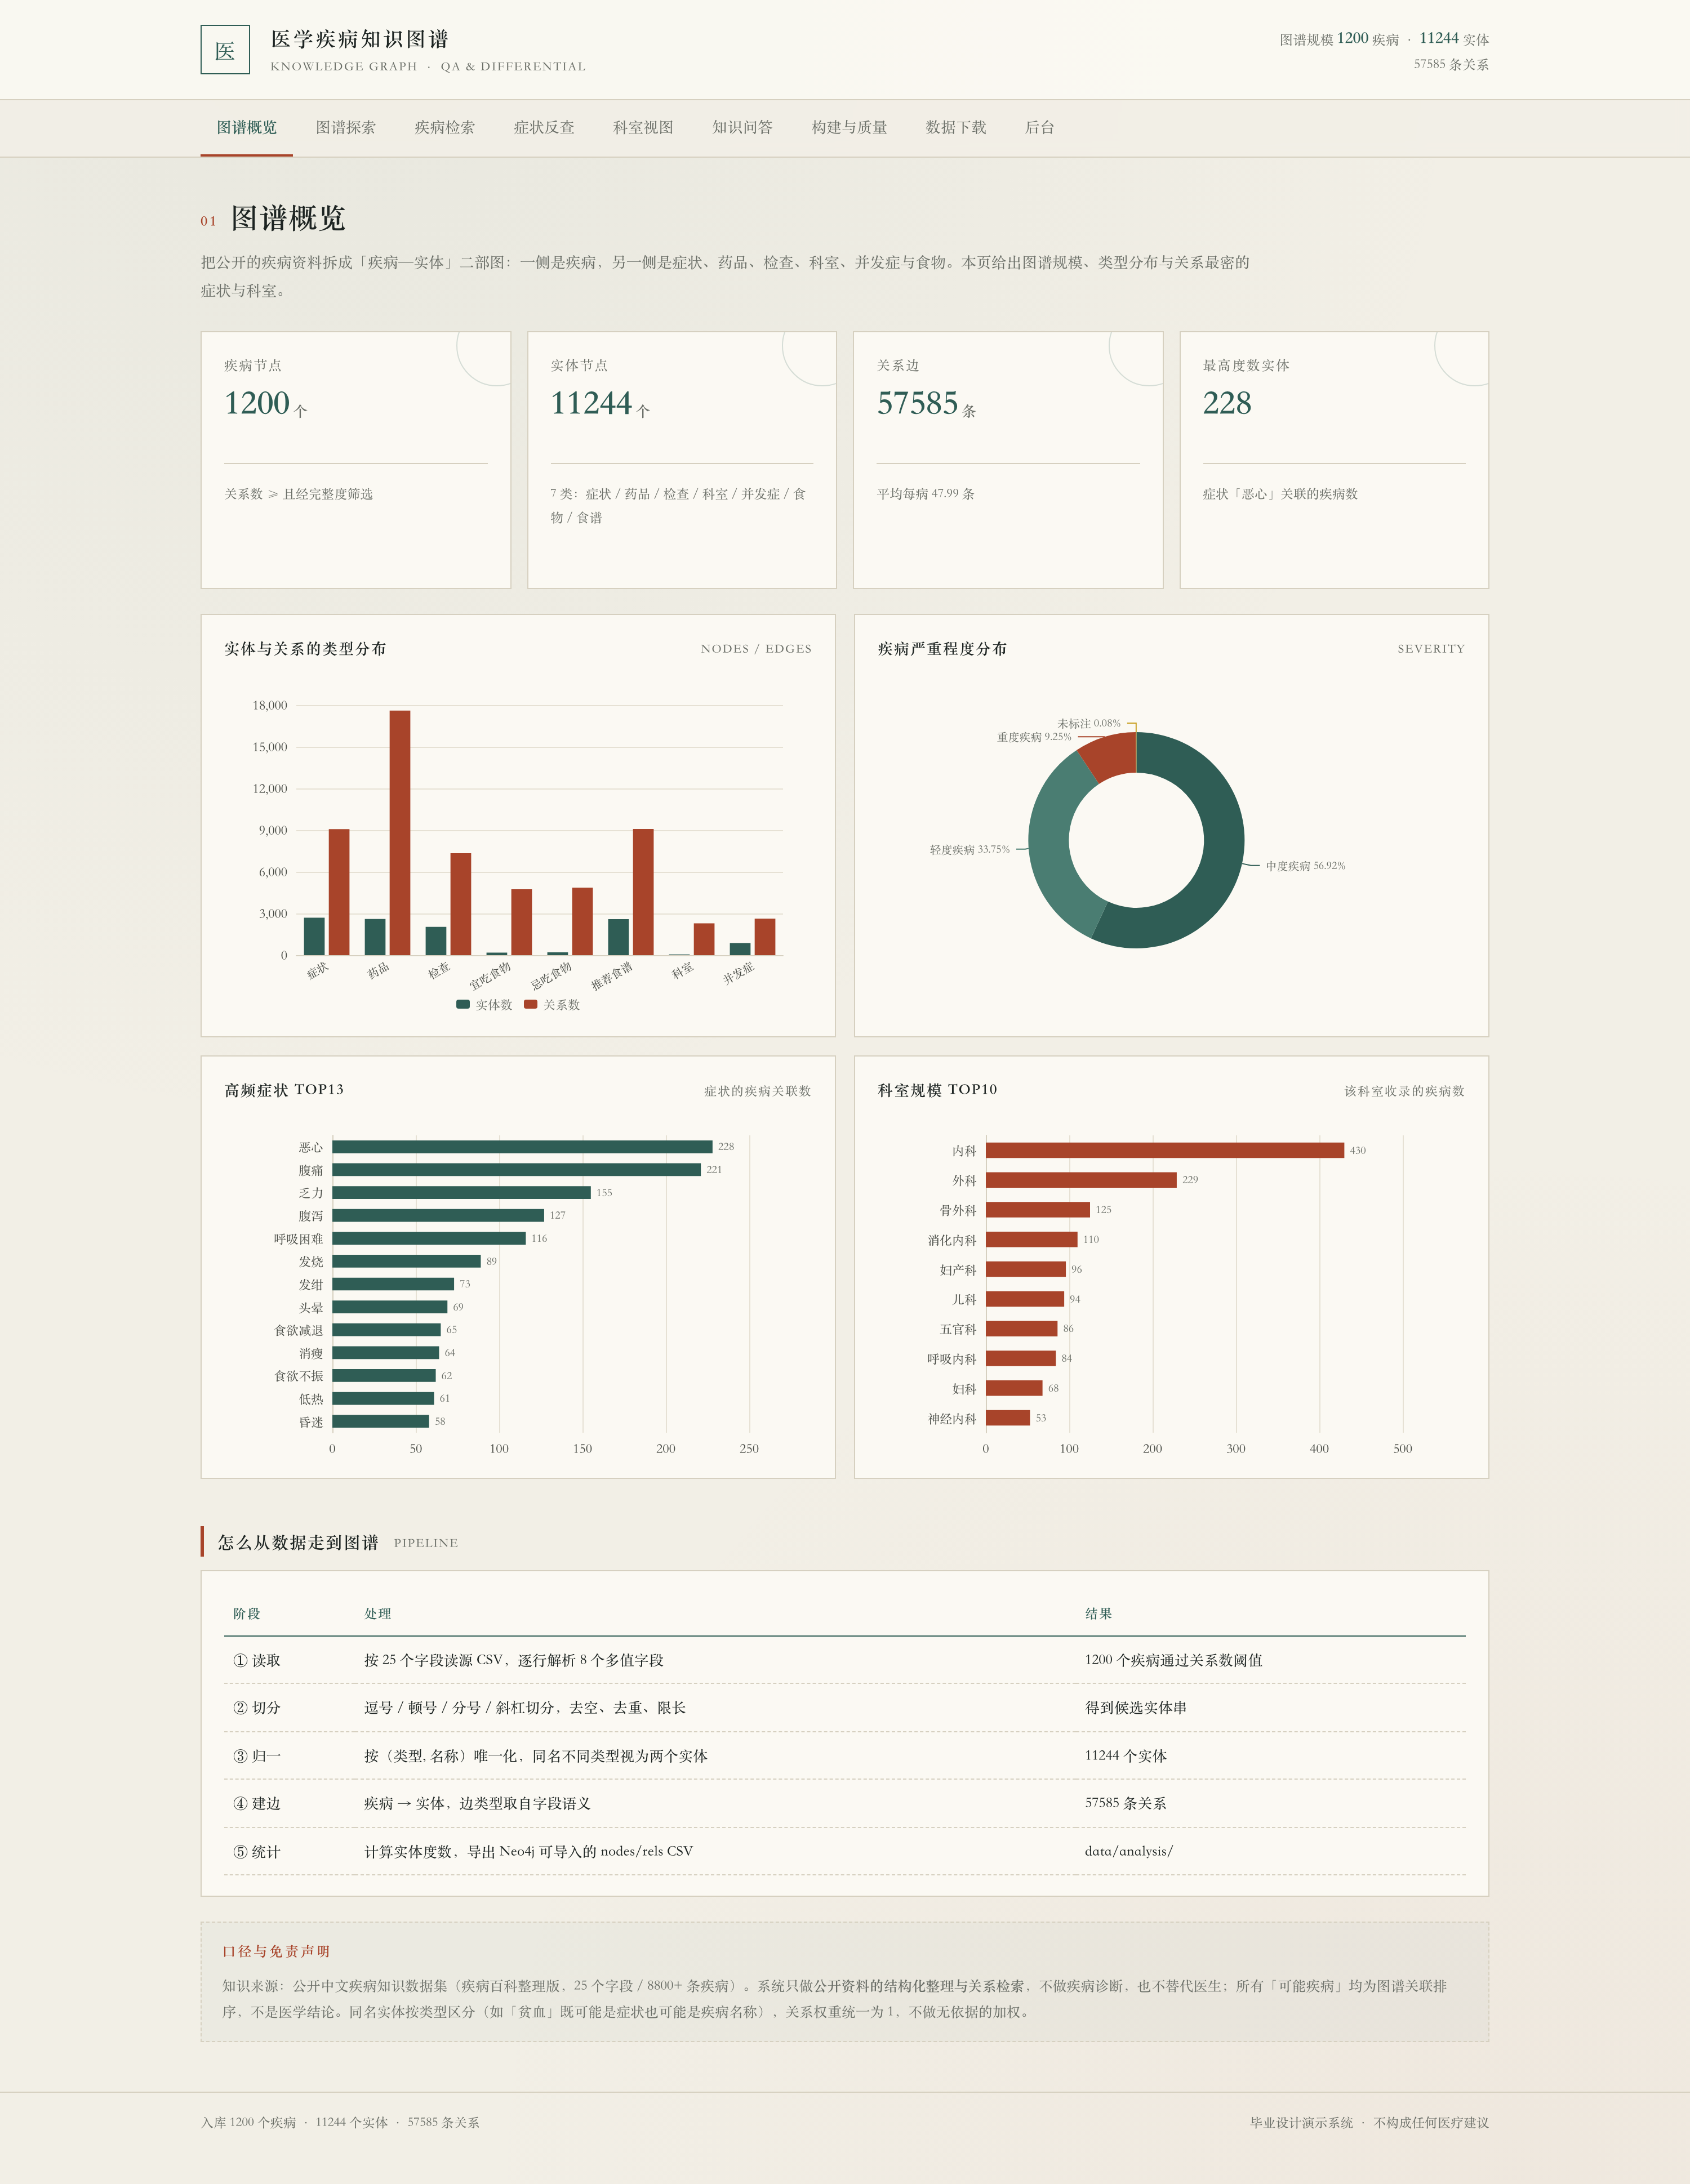
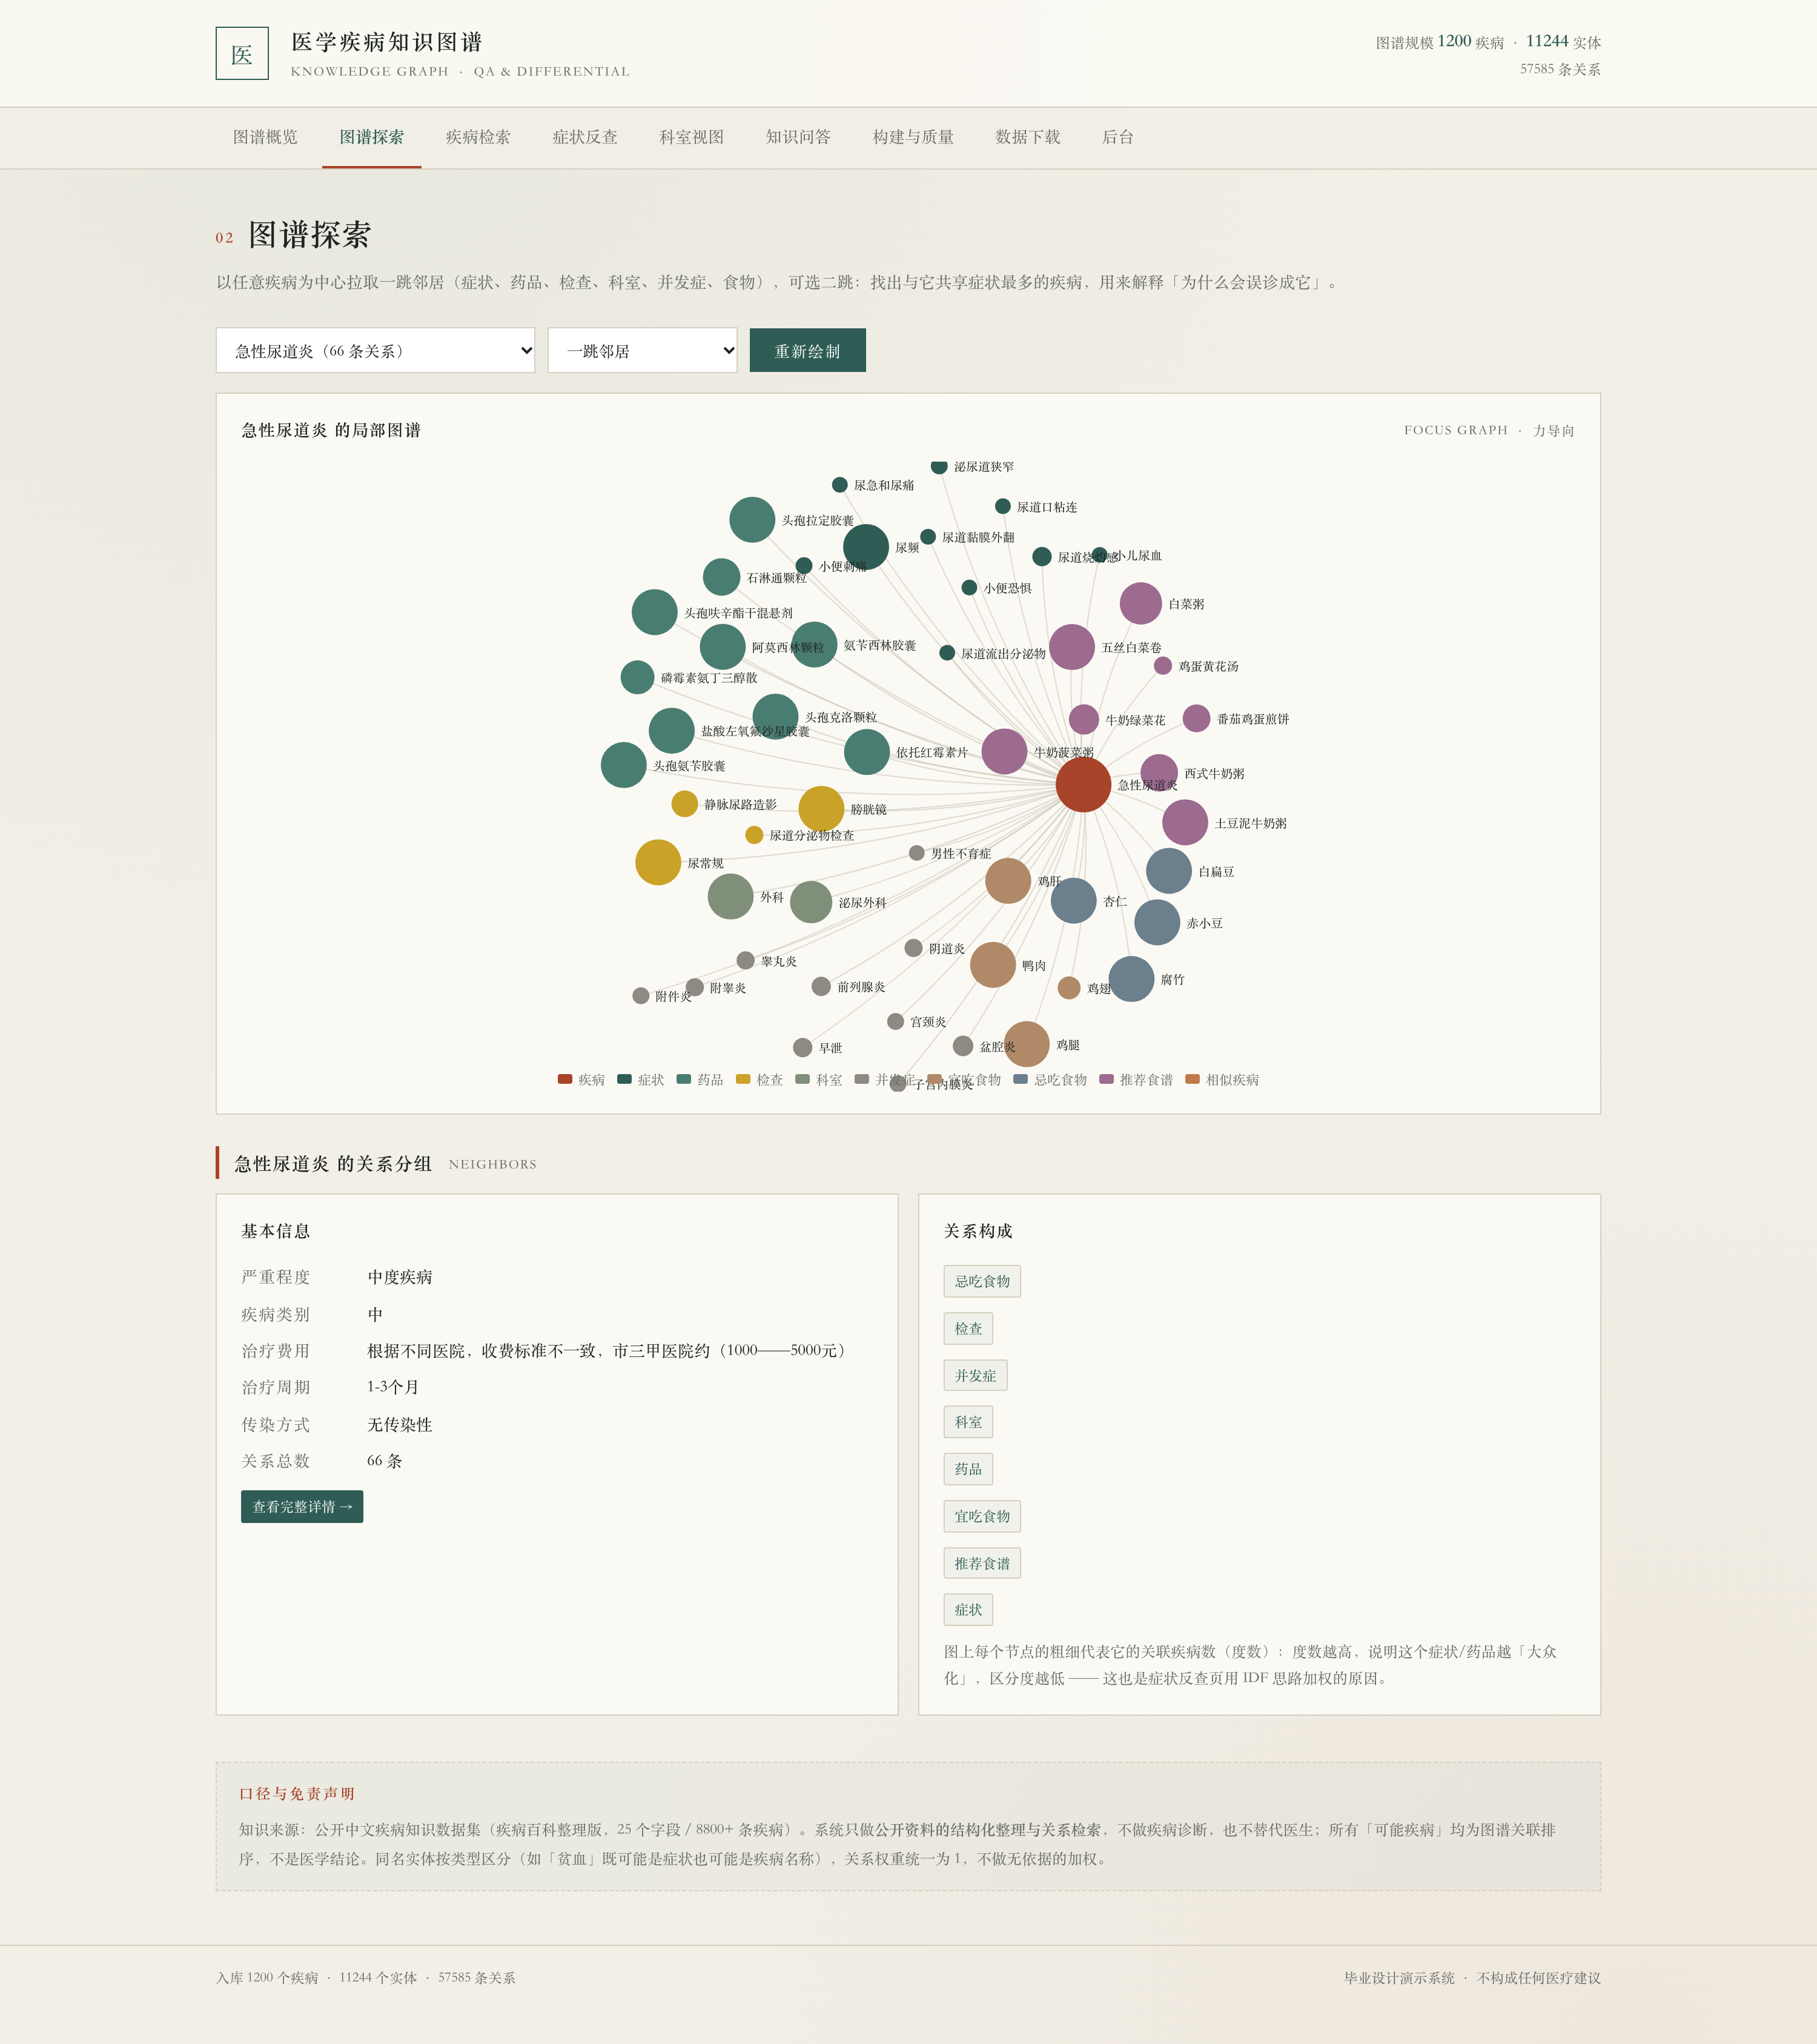
面向医学疾病知识的图谱问答系统:从公开疾病数据集(25 字段 / 8805 条 / 41.7MB)抽取 1200 个疾病、11244 个实体、57585 条关系,实现力导向图谱探索、多跳查询、症状反查(IDF 加权)与 6 类意图的规则问答,并导出 Neo4j 可导入文件。第 22 套「青瓷医案风」界面,全站不做诊断、关系不加权、同义词只提示不合并。
演示视频
视频也可在 B 站视频页 观看
运行环境
| 编程语言 | Python 3.8 及以上 |
|---|---|
| 后端框架 | Django 4.2 |
| 图谱构建 | 自定义 build_graph 管理命令(切分 / 归一 / 建边 / 度数 / Neo4j 导出) |
| 数据处理 | Python 标准库 csv + collections |
| 数据库 | MySQL 8.0(交付默认 SQLite,免安装) |
| 可视化 | ECharts 5(力导向图 / 柱状图 / 饼图,本地内置) |
| 数据规模 | 1200 疾病 / 11244 实体 / 57585 关系(源数据 8805 条) |
| 操作系统 | Windows / macOS / Linux |
| 启动方式 | 双击一键脚本,或 python manage.py runserver 8087 |
功能模块
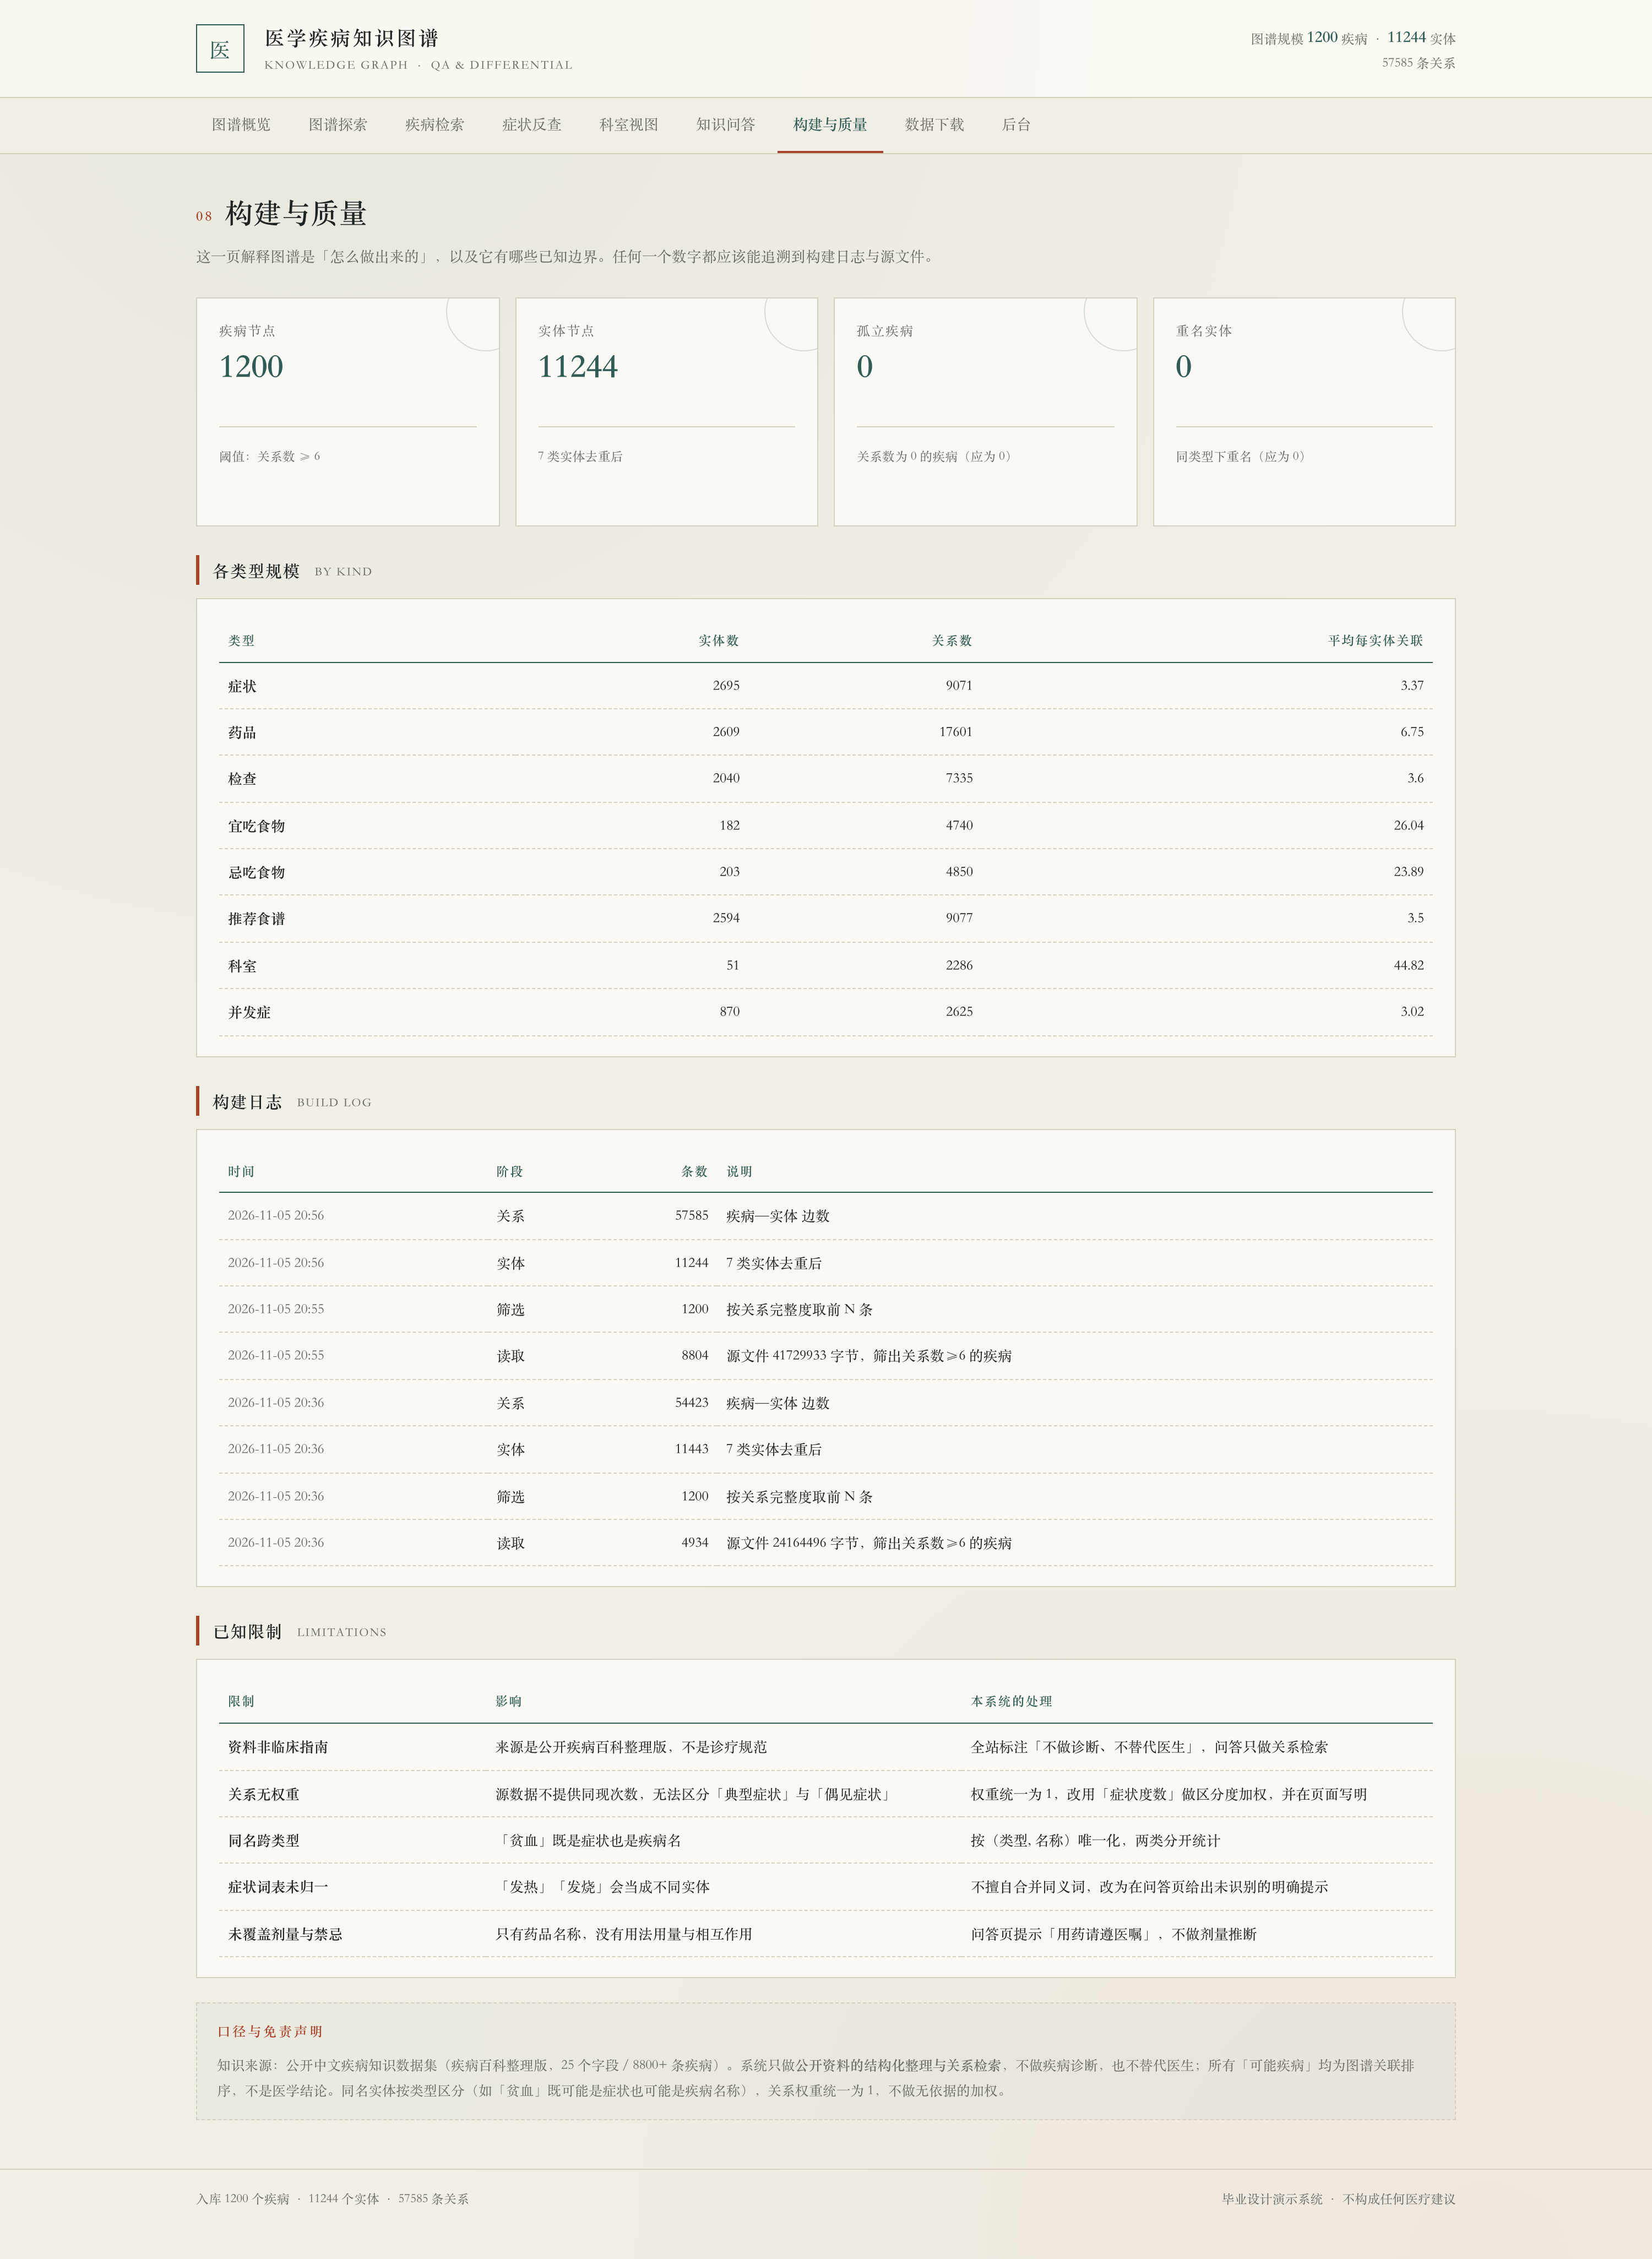
- 真实数据:公开中文疾病数据集 41.7 MB / 25 字段 / 8805 条,随包提供;抽出 1200 疾病 / 11244 实体 / 57585 关系(平均每病 48 条),孤立疾病与同类型重名均为 0
- 实体归一口径:以(类型, 名称)为唯一键,「贫血」既是症状也是病名时分存两个节点,避免症状反查把病名当症状统计
- 关系不加权:源数据不提供同现次数,按位置拍脑袋加权无法解释;权重统一为 1,改用症状度数做区分度加权(IDF 思路)
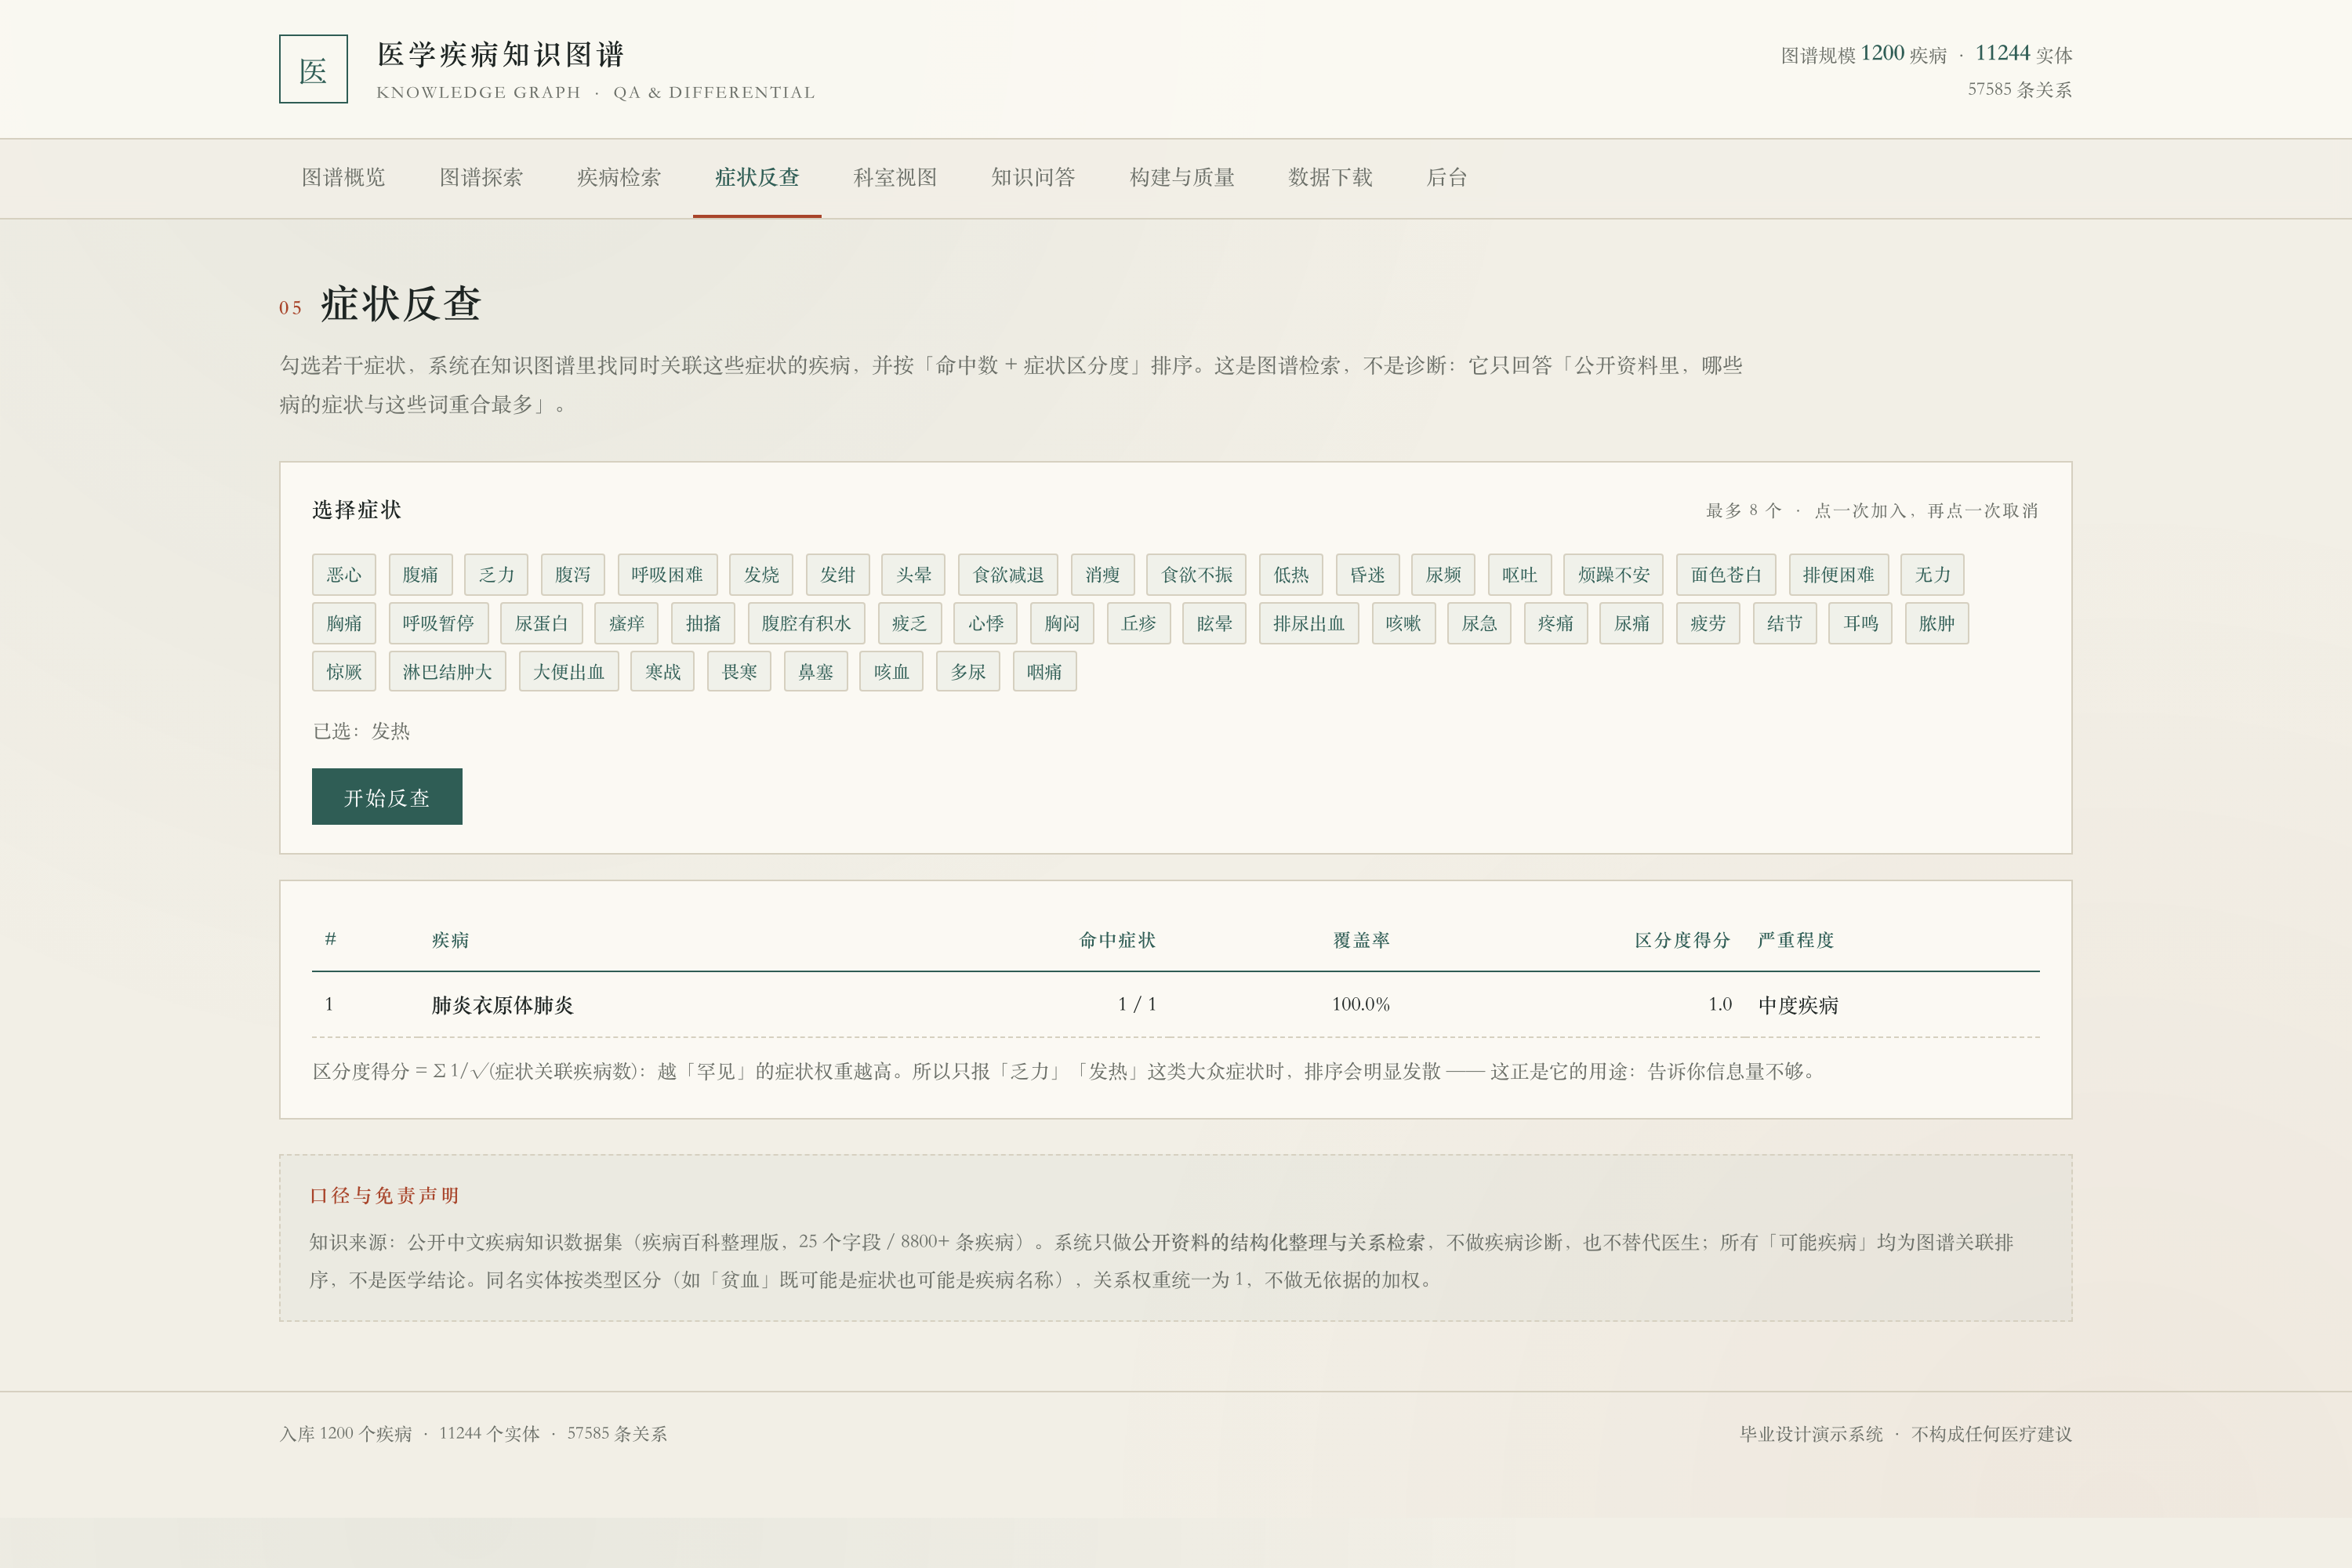
- 同义词如实不合并:实测「发热」只关联 1 个疾病、「发烧」关联 89 个,静默合并会改变口径,页面改为提示「改搜发烧」,论文 6.3 节专门讨论
- 图谱探索可交互:以疾病为中心拉取一跳邻居(症状/药品/检查/科室/并发症/食物),二跳按共享症状找出最易混淆的相似疾病
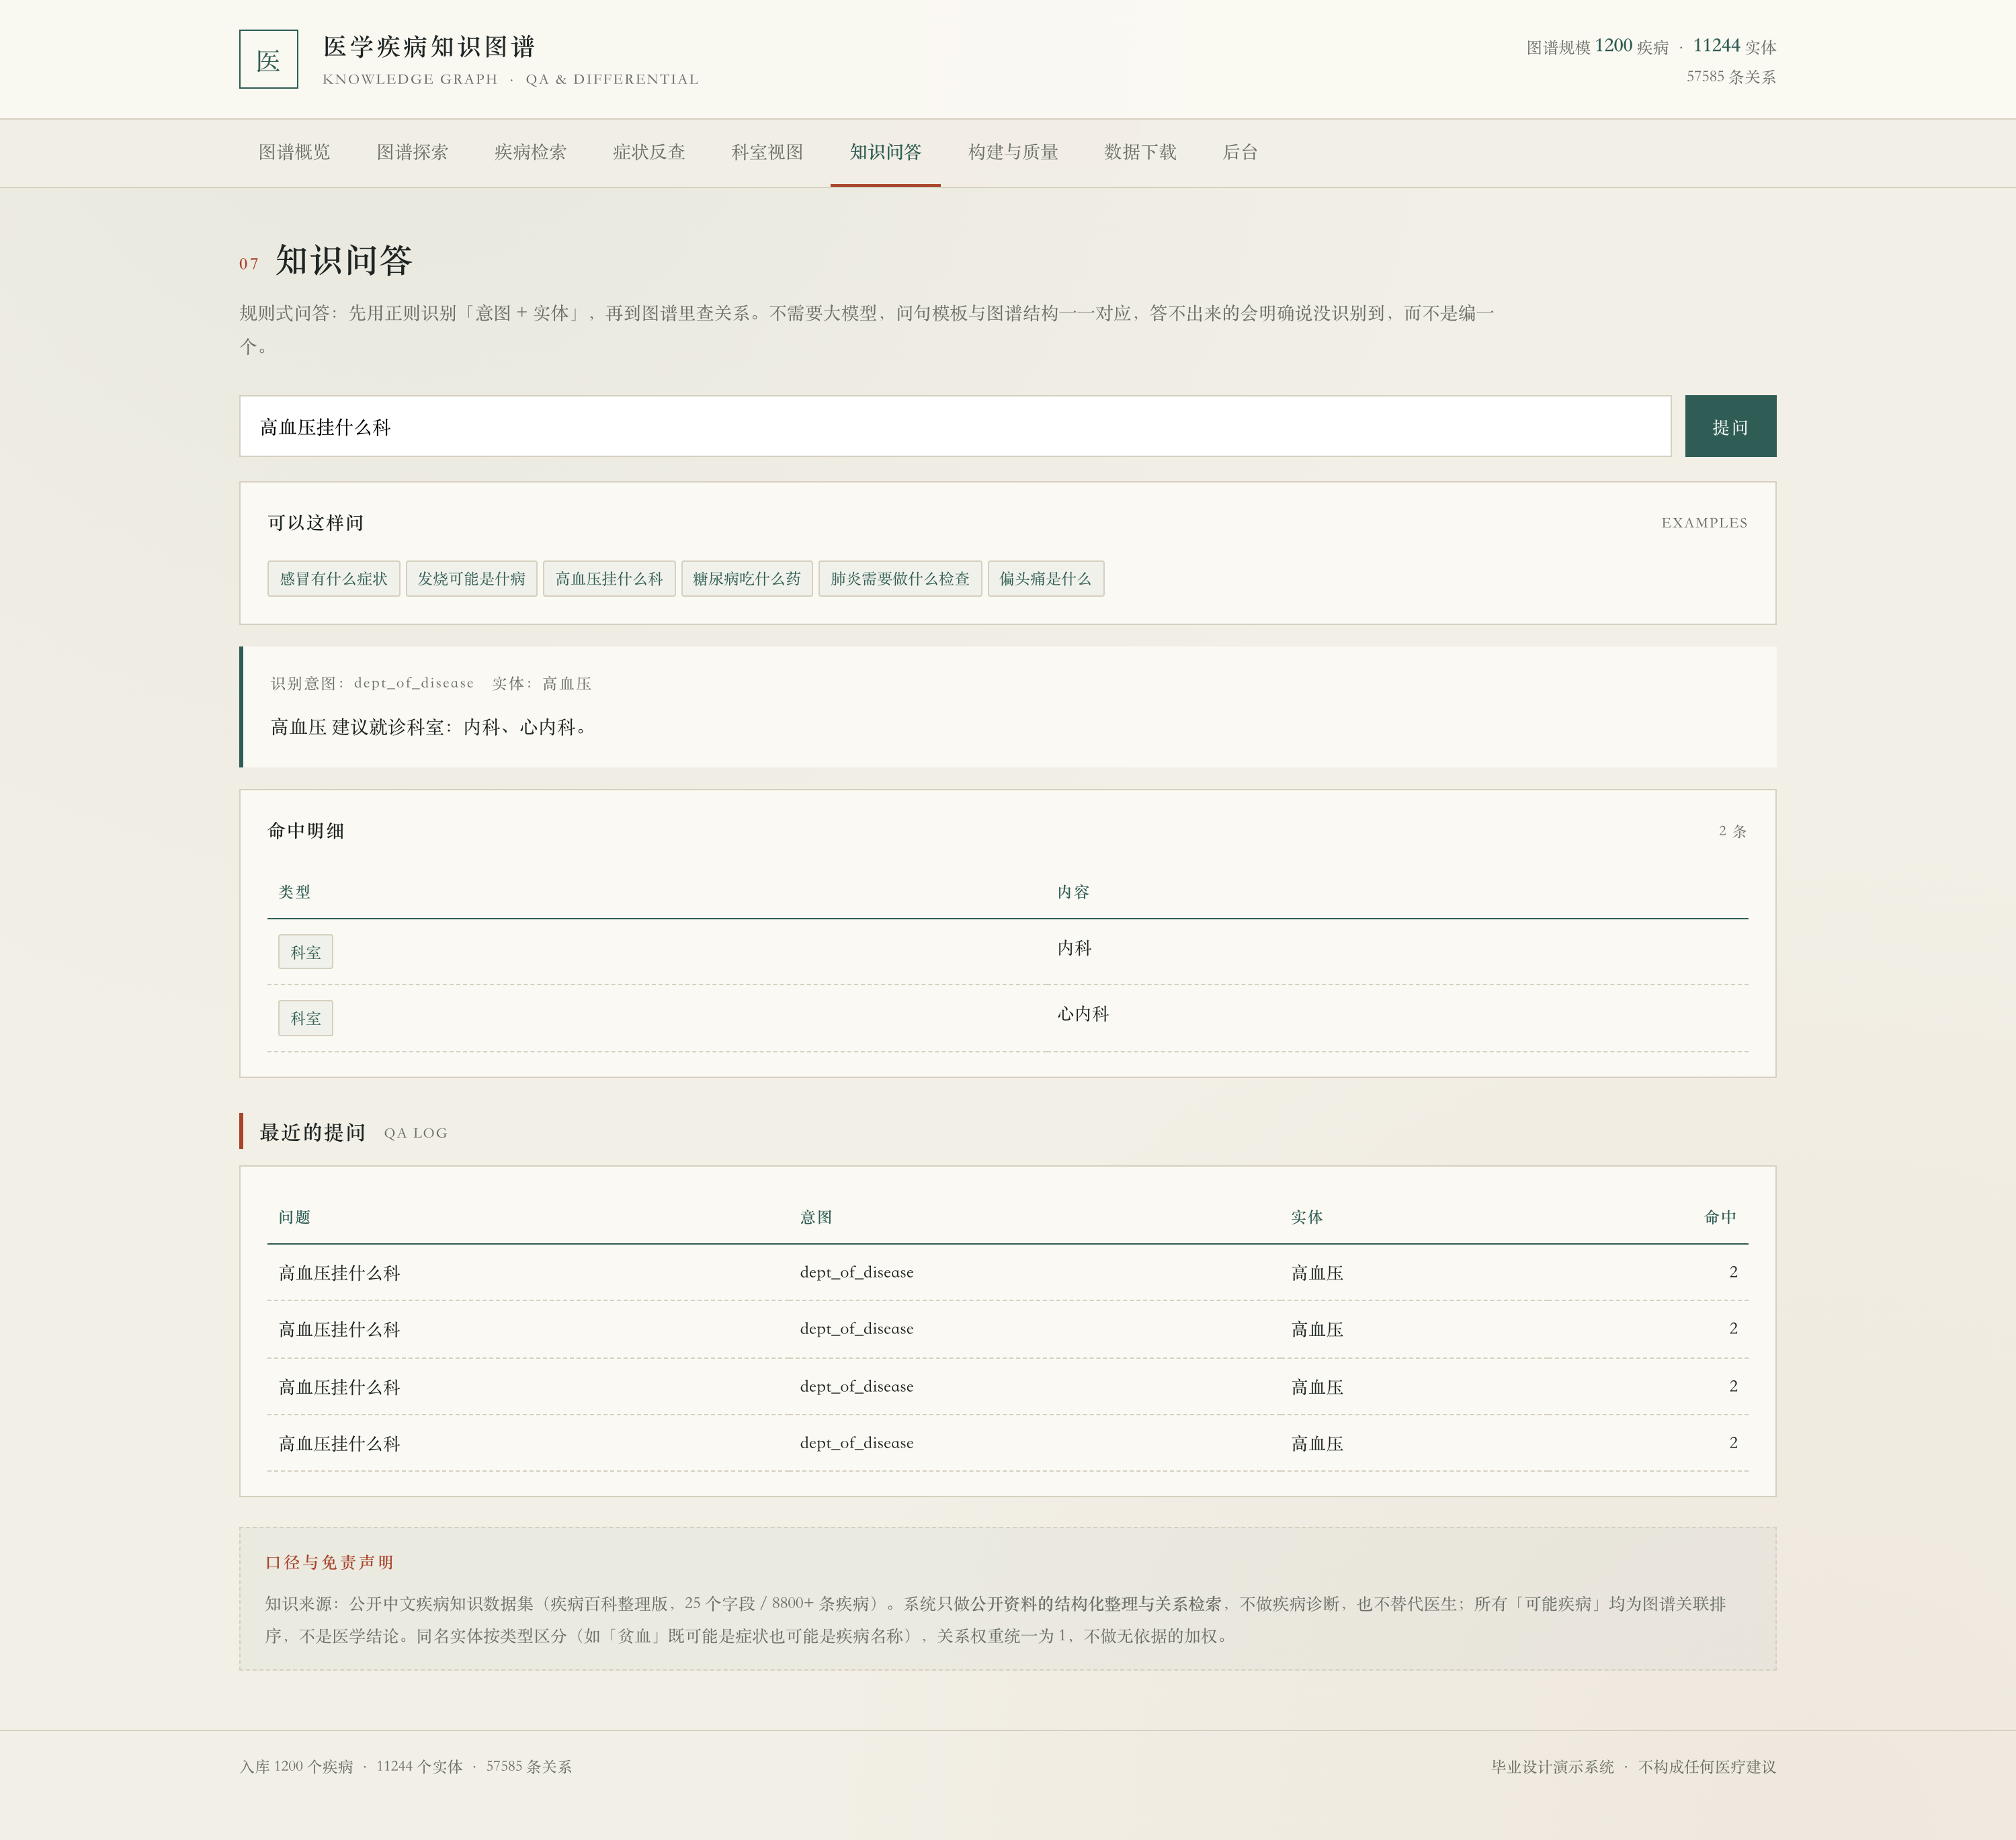
- 规则问答 6 类意图:病→症状、症状→病、病→药、病→科室、病→检查、是什么;6 条典型问句全部命中正确意图与实体,答不出时明确说没识别到
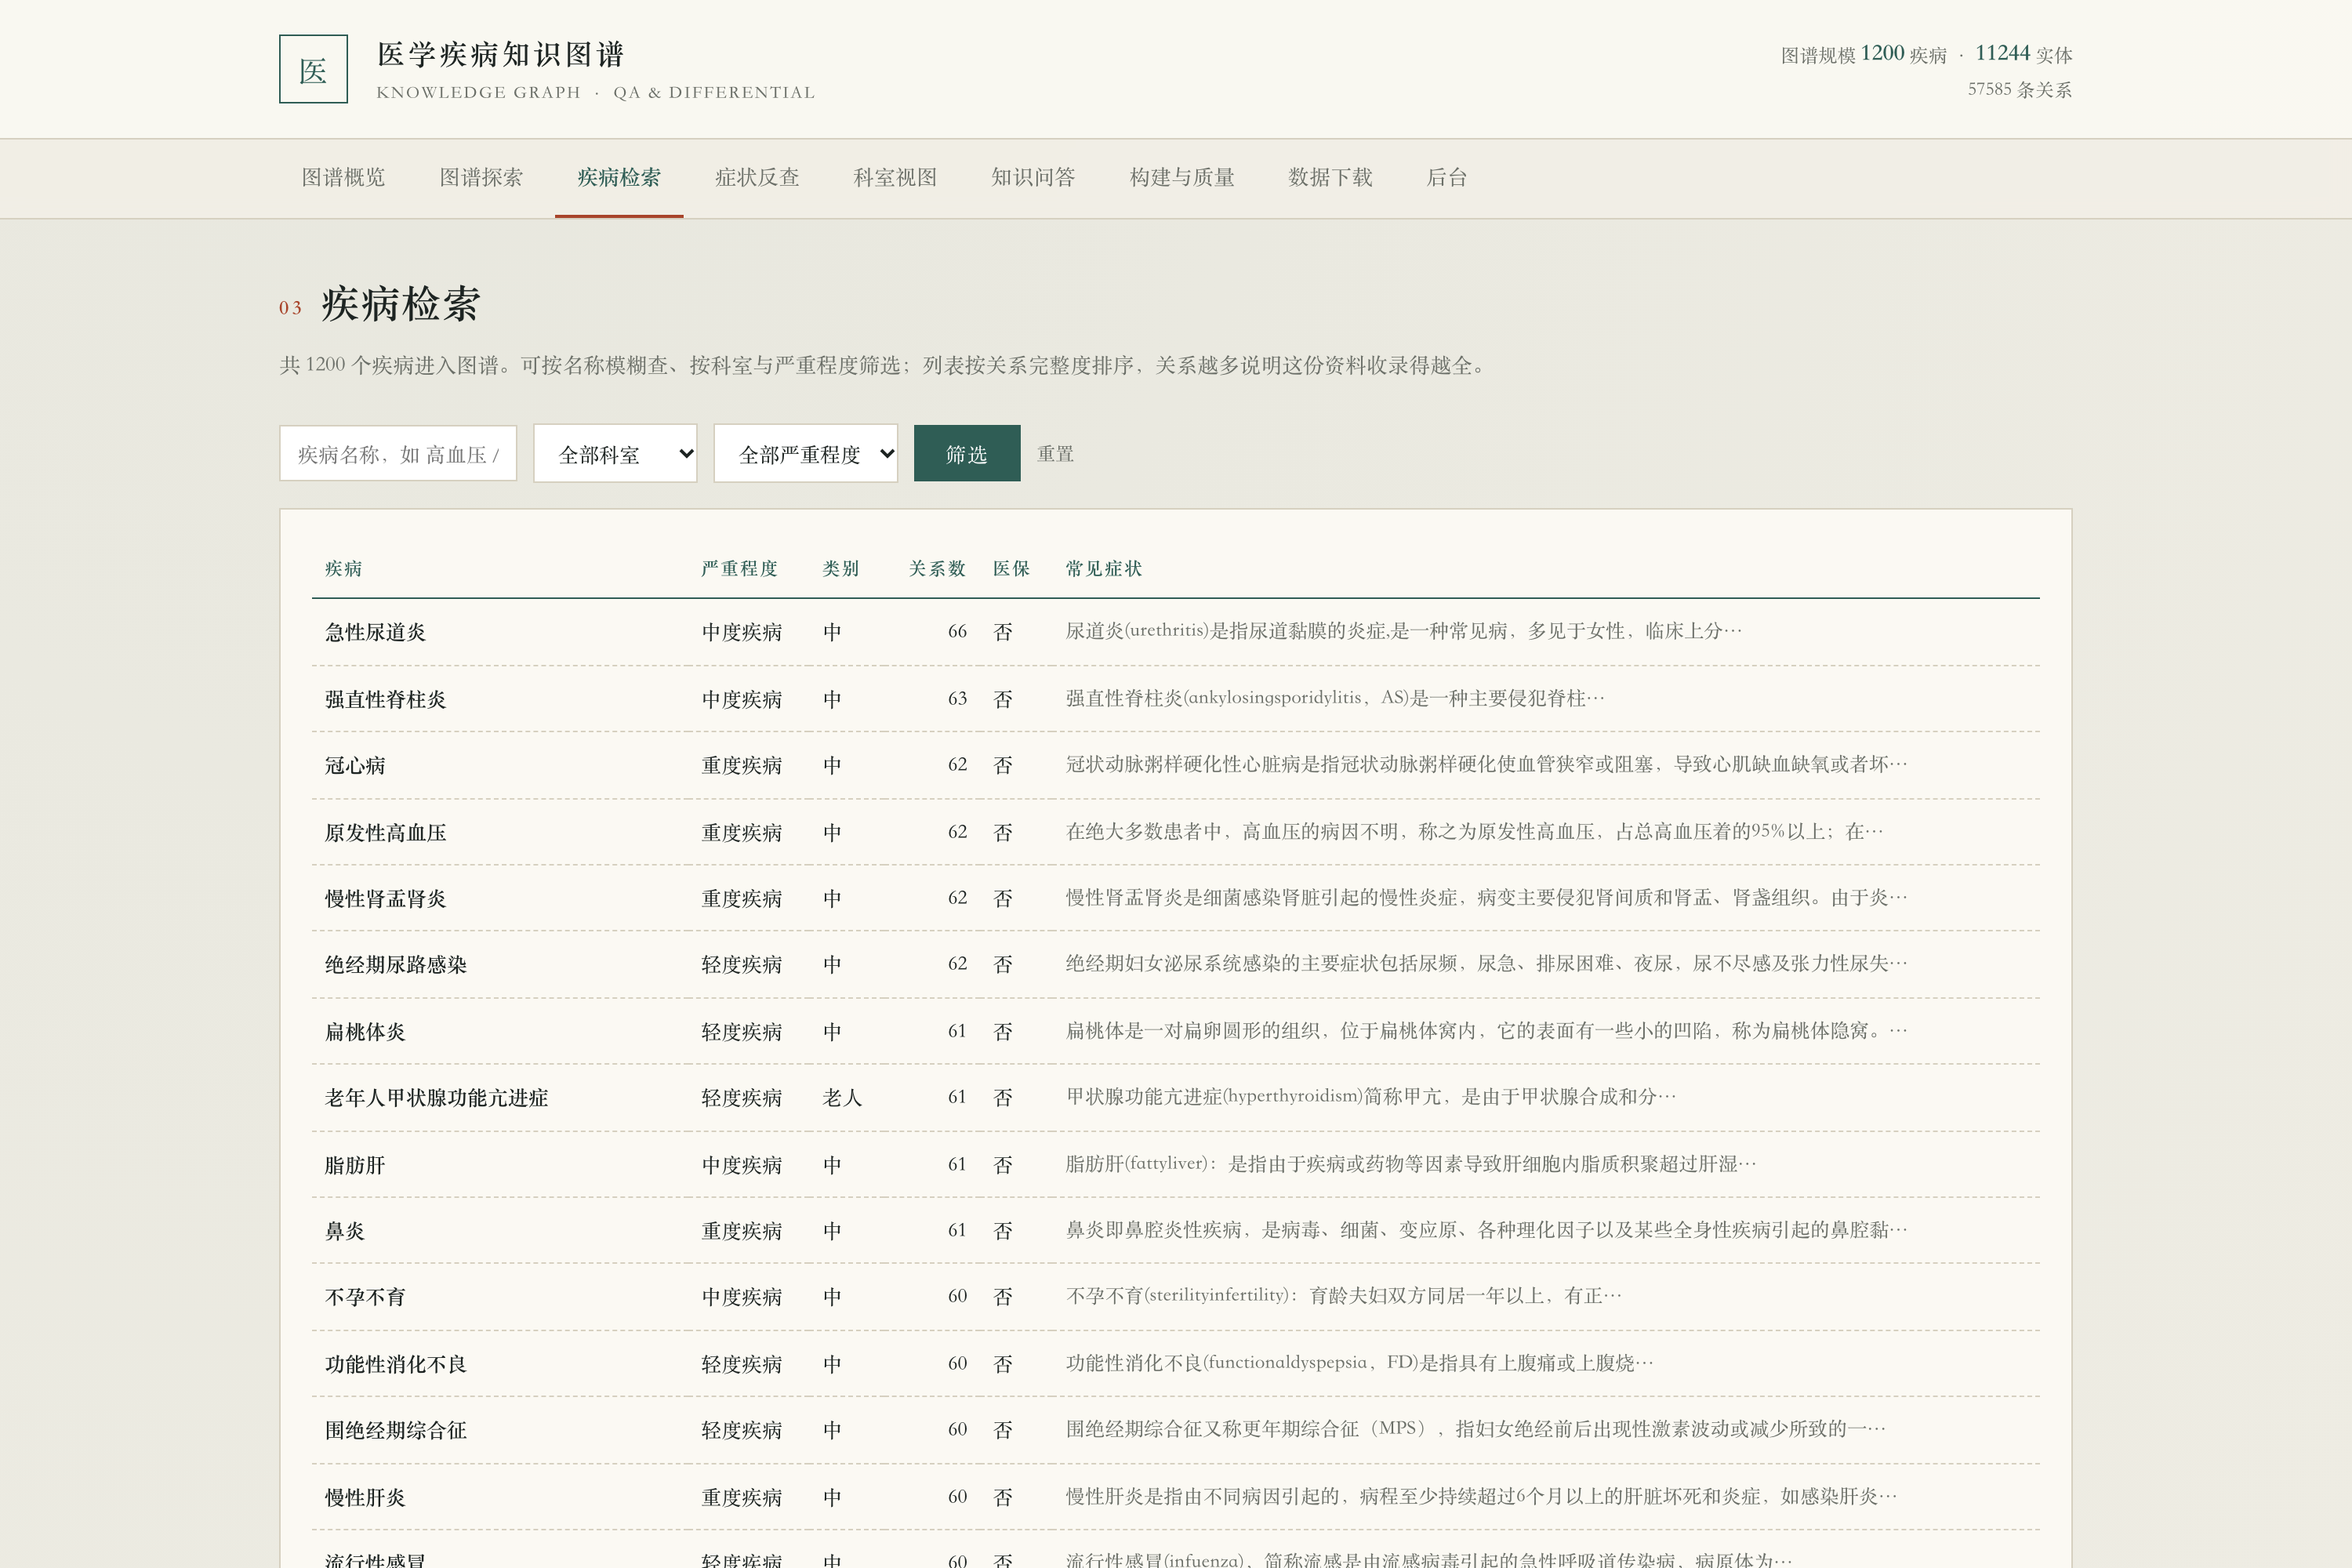
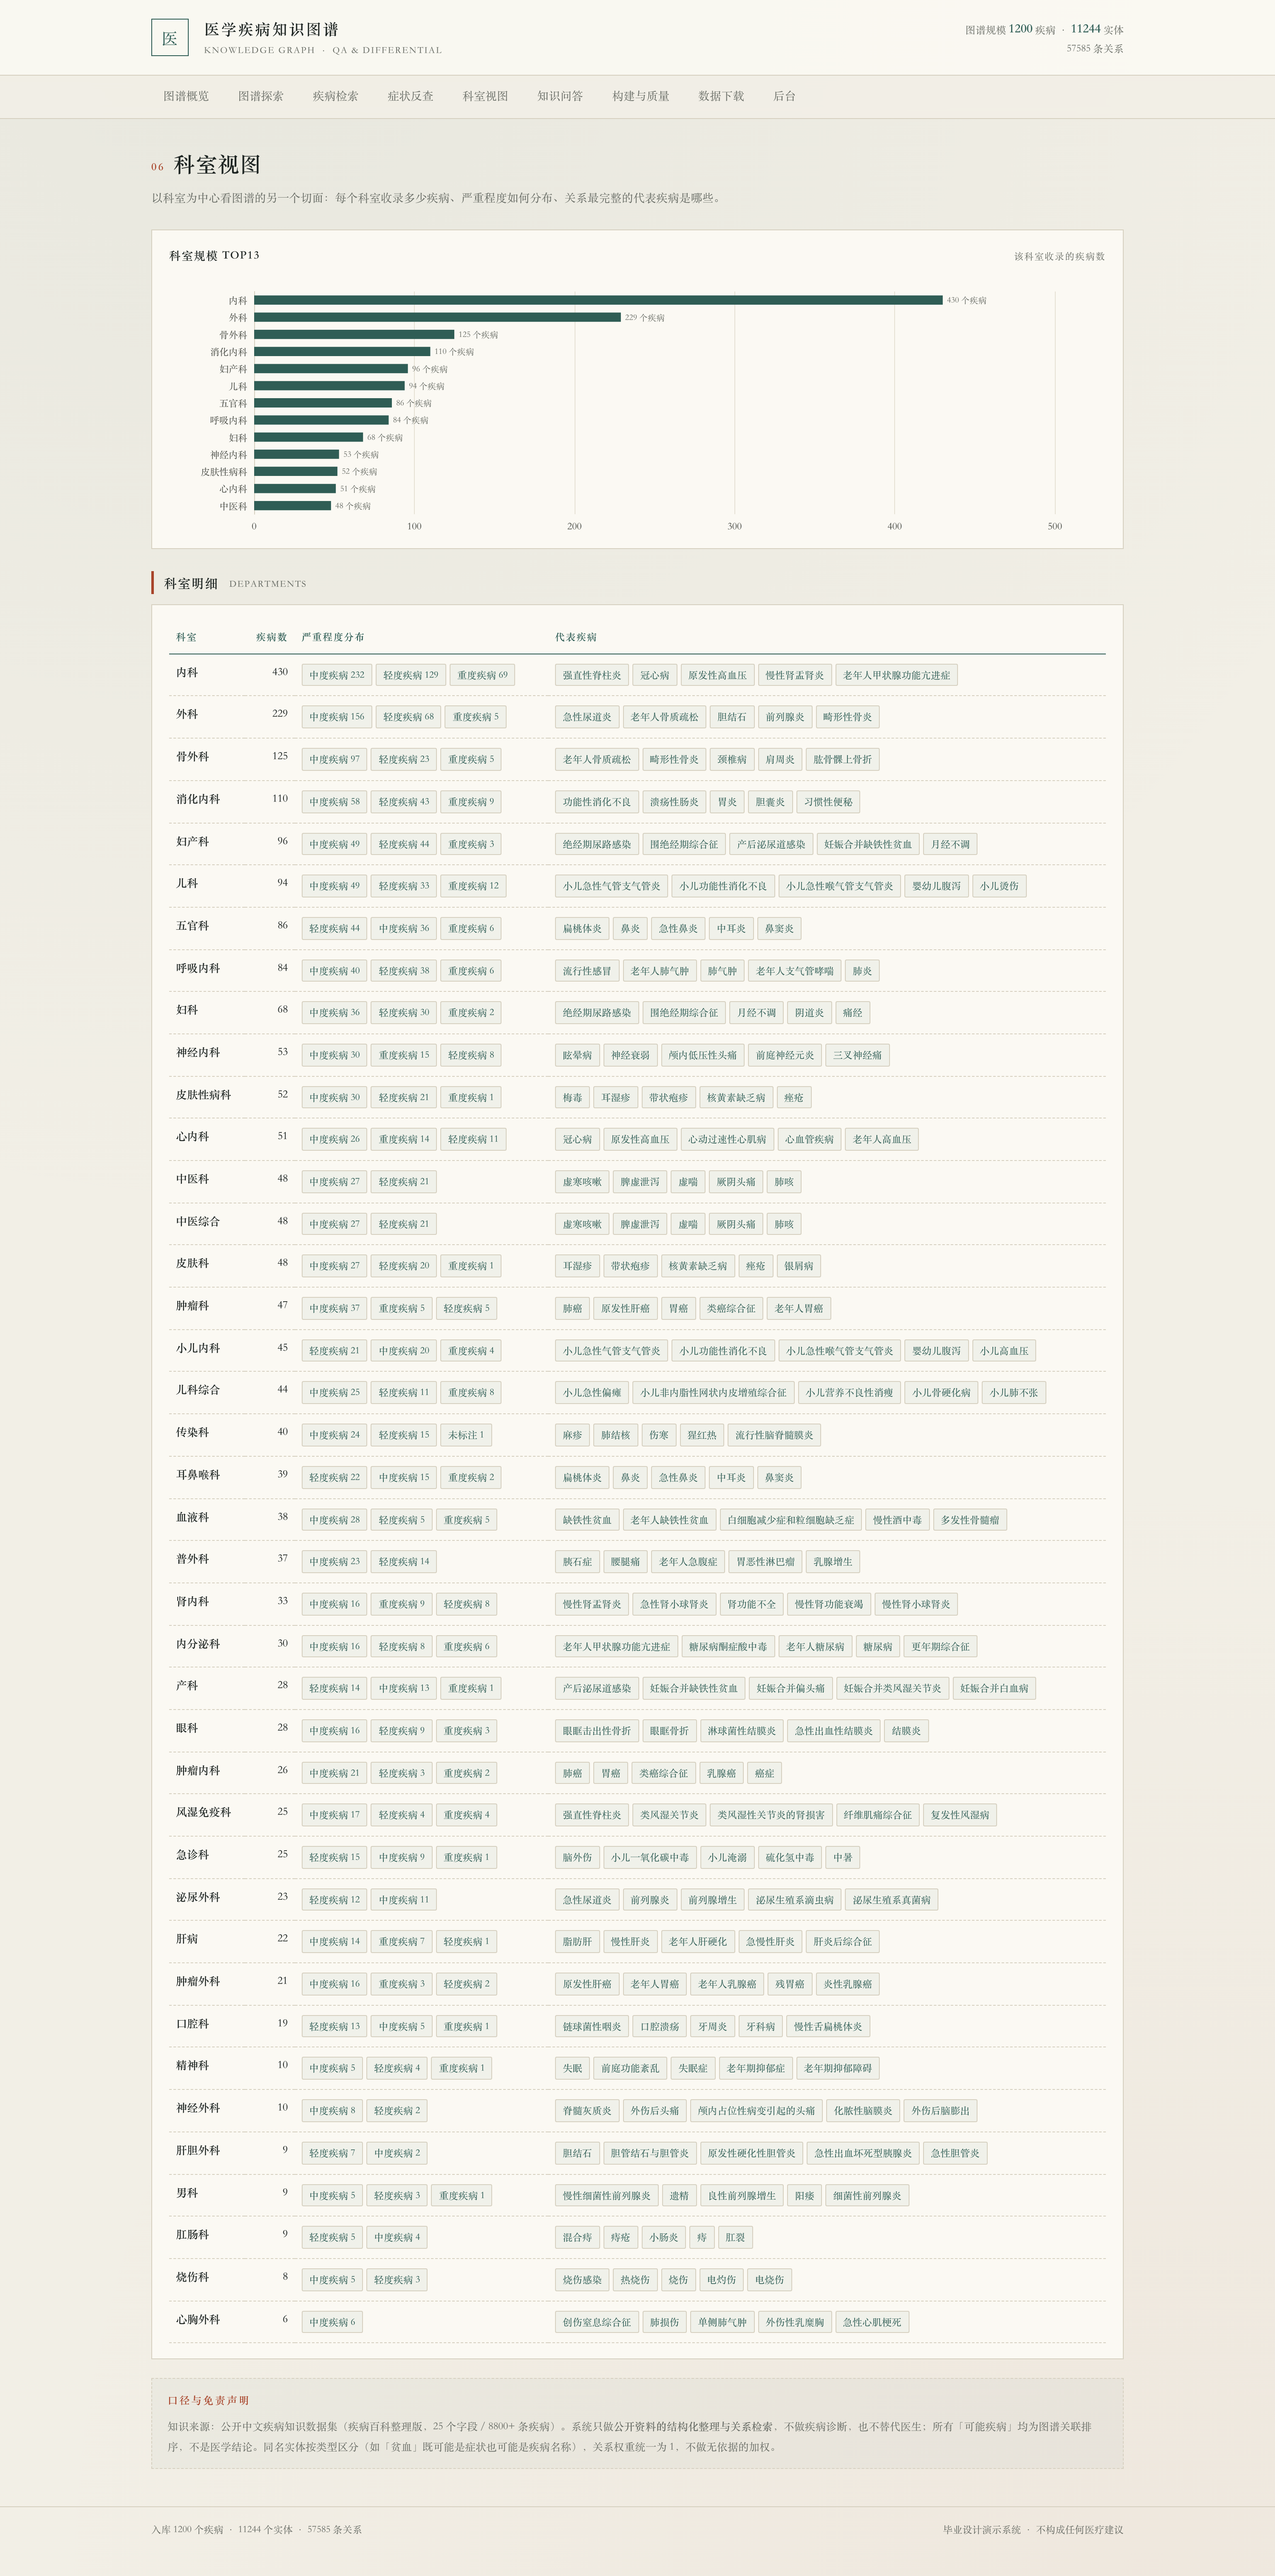
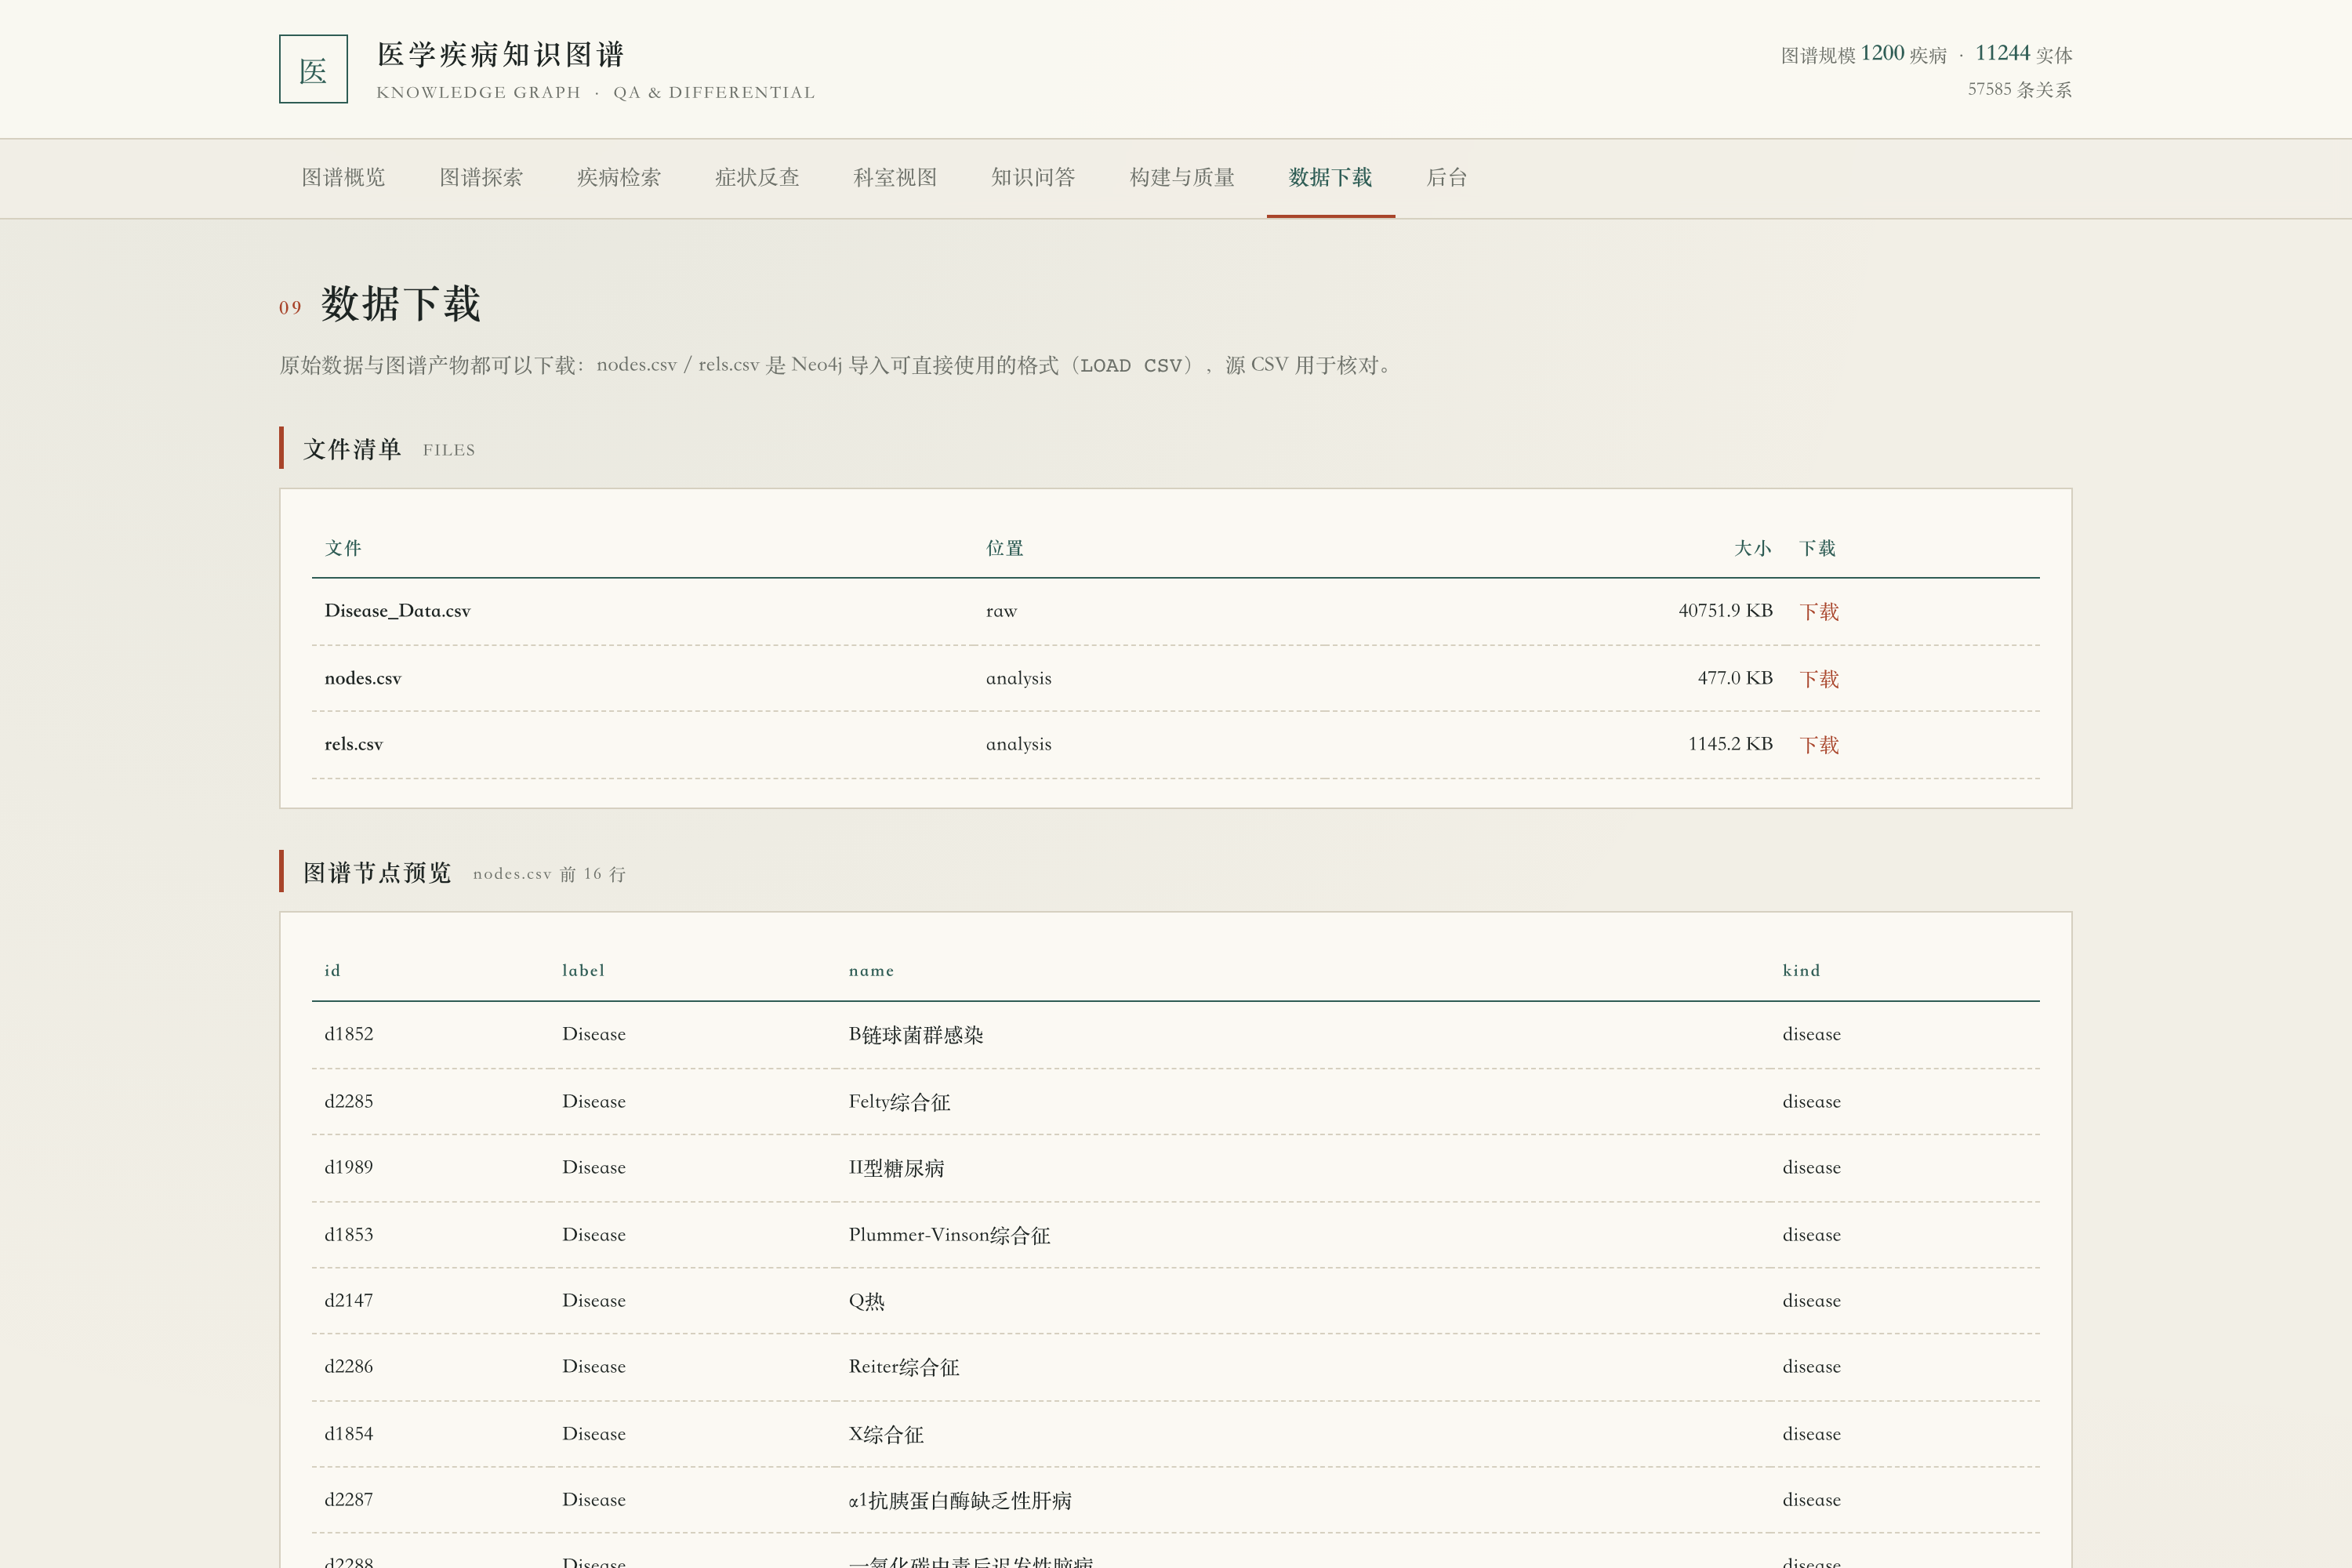
- 9 个功能页面:概览 / 图谱探索 / 疾病检索 / 详情 / 症状反查 / 科室视图 / 知识问答 / 构建与质量 / 数据下载,ECharts 本地内置离线可用
- 可迁移:nodes.csv 与 rels.csv 可直接 LOAD CSV 导入 Neo4j;构建命令幂等,改阈值即可扩到全量 8805 条
交付内容
- 完整源码(Django 工程 + 图谱构建命令 + 演示数据库)
- 原始数据集 41.7MB 与图谱导出文件(nodes.csv / rels.csv / findings.json)
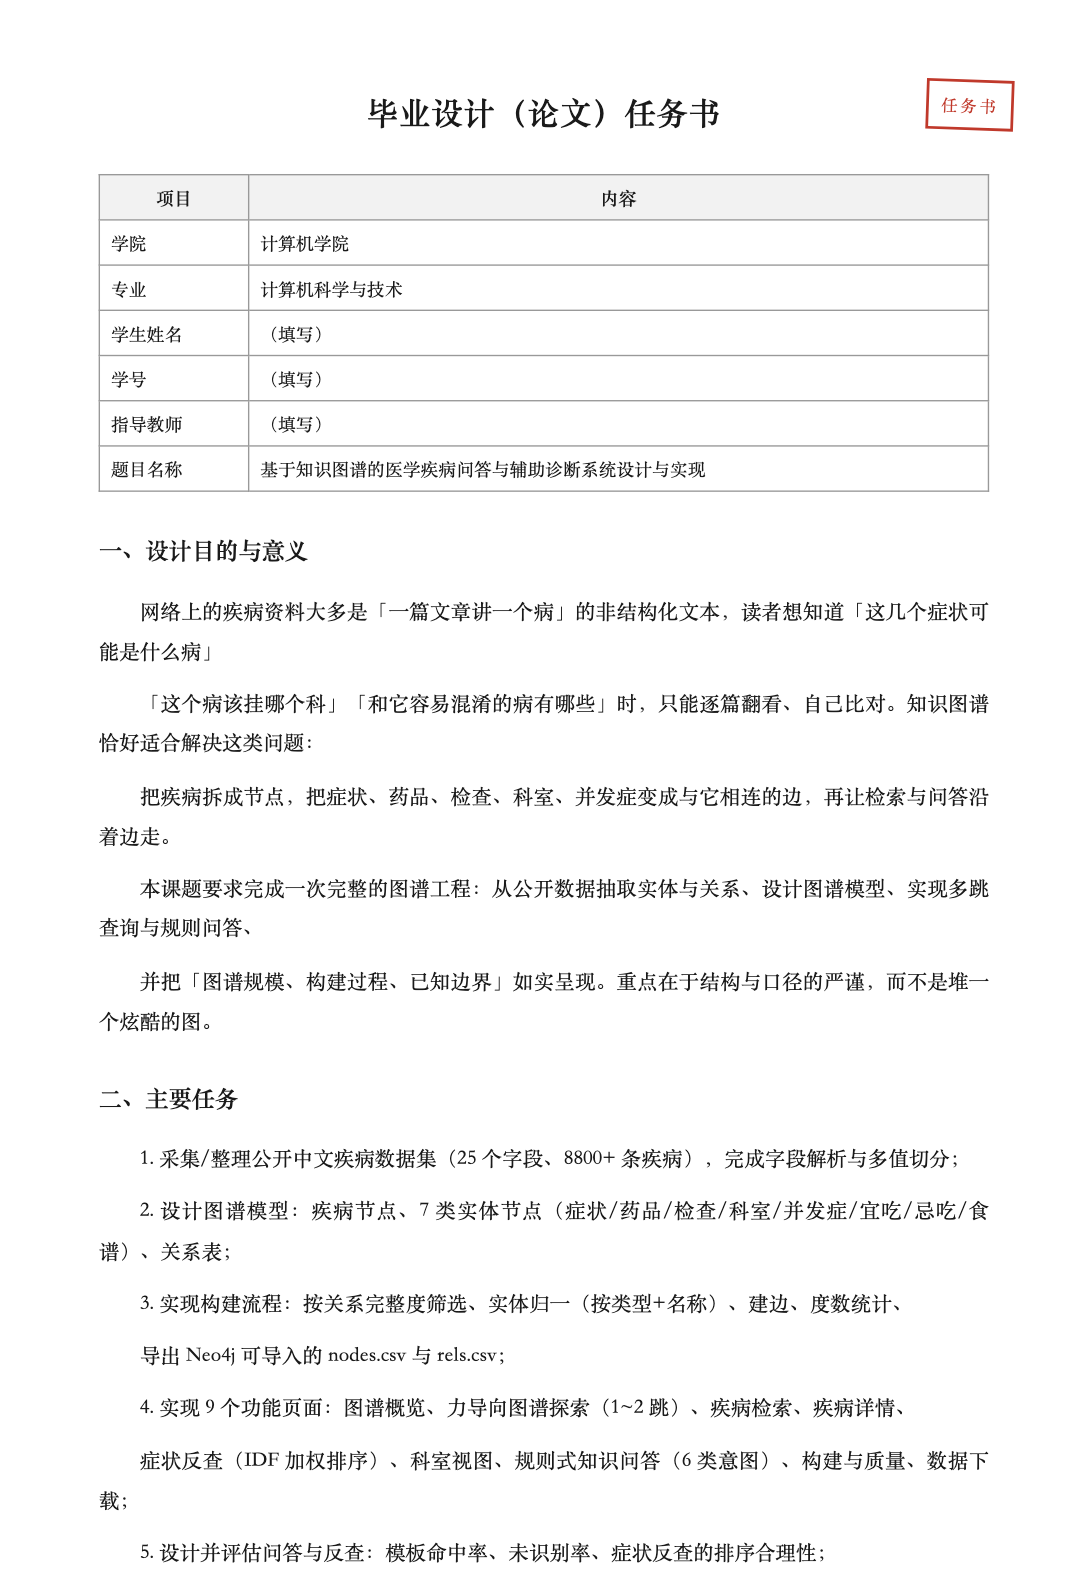
- 毕业设计任务书(Word)
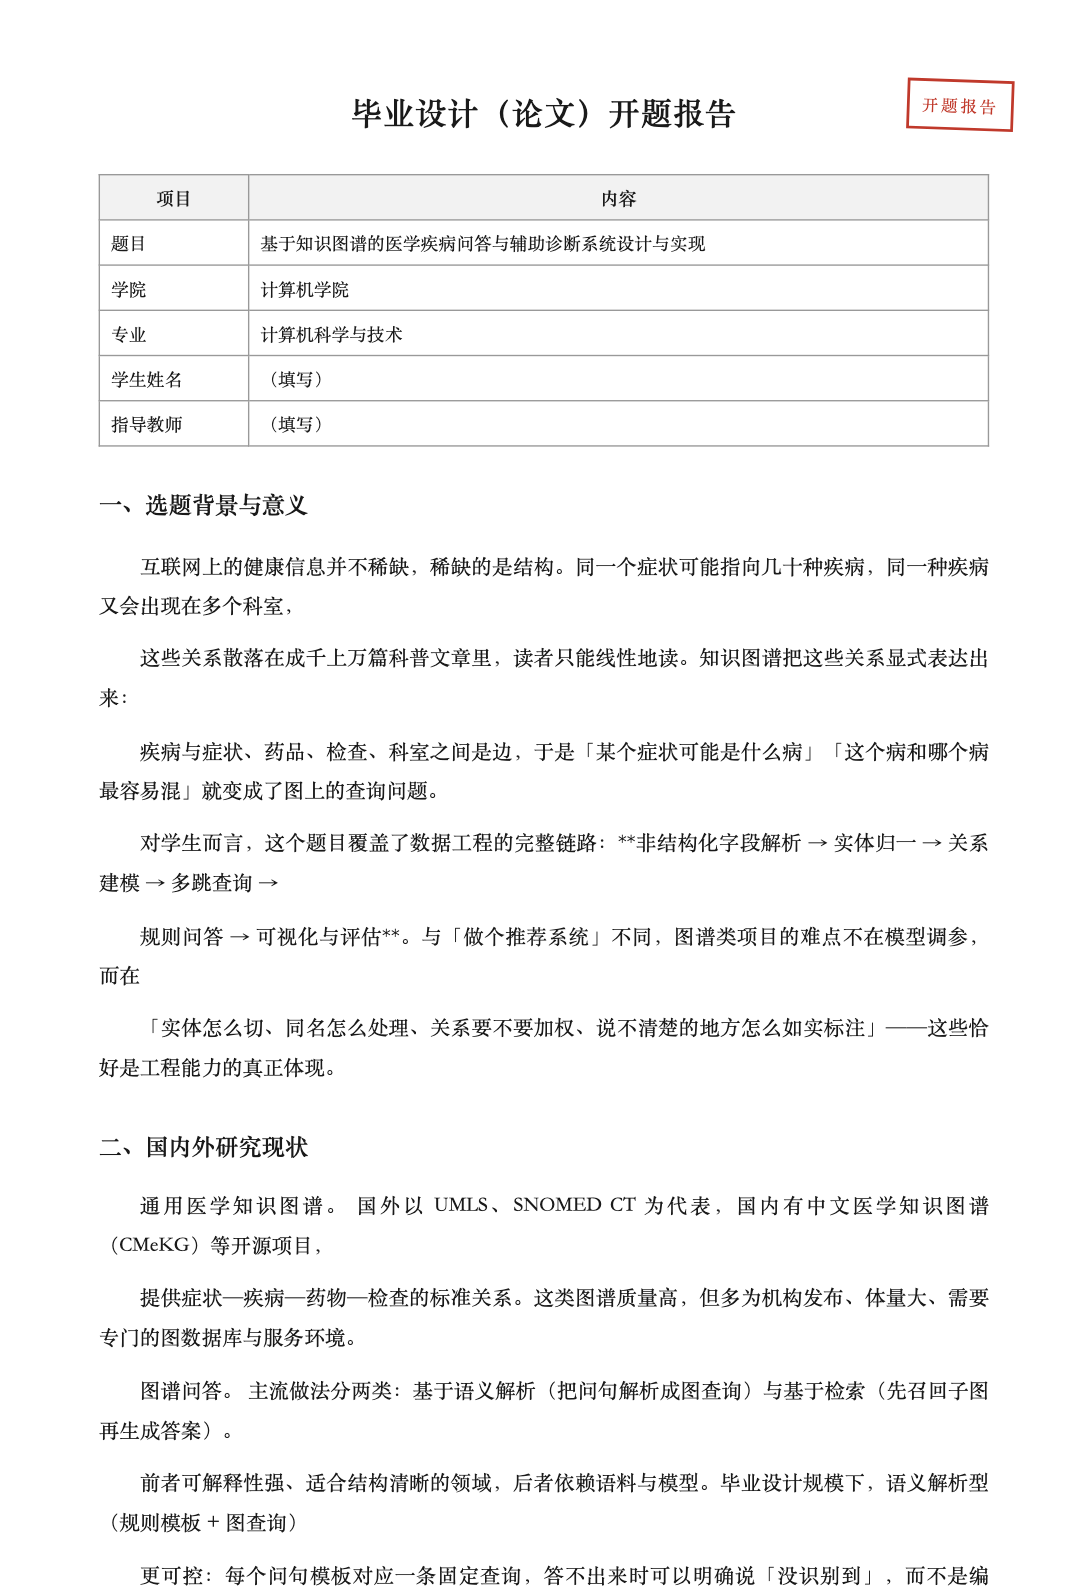
- 毕业设计开题报告(Word)
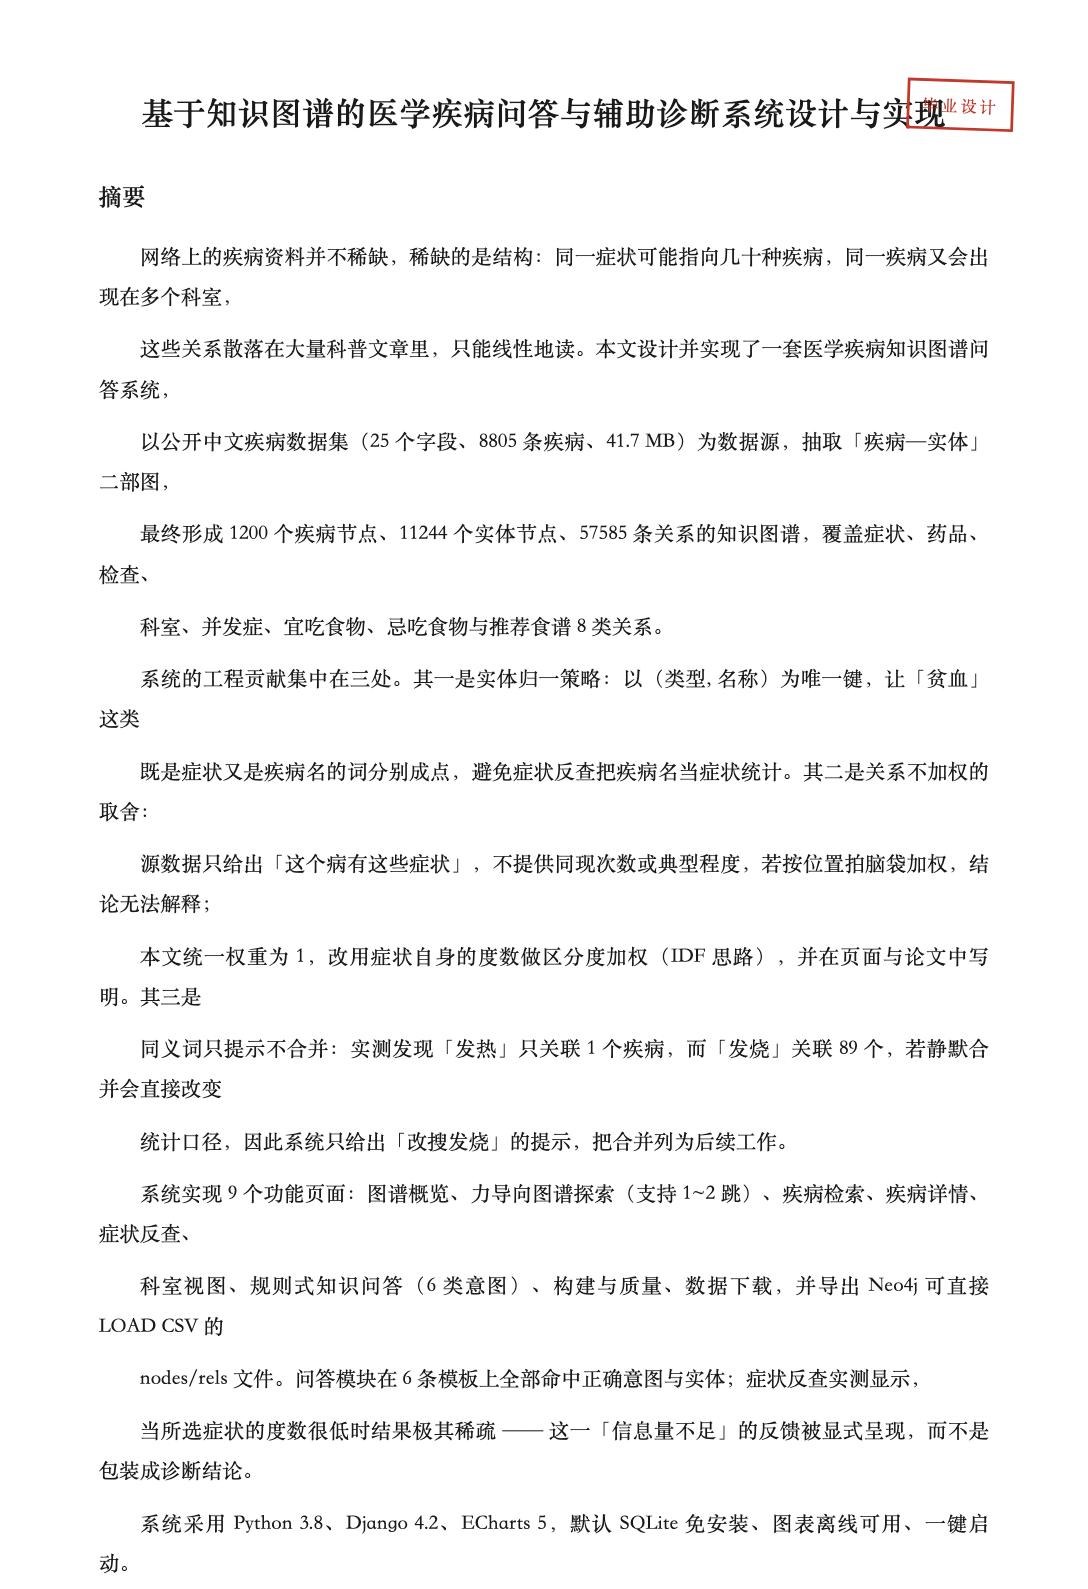
- 毕业论文(Word,七章制,含同名归一、不加权、同义词不合并三处取舍与评估)
- 系统使用与二次开发说明(Word + md)
- 系统运行截图 10 张 + 功能演示视频
最终成品目录结构
下面是交付包里的真实目录,共 60 个文件。只展示文件名,不含文件内容; 点击文件夹可逐层展开,看到每个模块是怎么拆分的。
界面截图
点击任意一张可放大,支持左右切换(也可用键盘 ← → 键)
文档预览
交付的任务书、开题报告与论文均为 Word 文档,下面是真实页面预览;点击可放大并左右切换:
常见问题
数据是真的吗?
是。源文件 41.7 MB、25 个字段、8805 条疾病,随包放在 源码/data/raw/Disease_Data.csv。图谱节点与关系全部从这份文件抽取,没有一条是合成的。
为什么只有 1200 个疾病?
8805 条里先按「关系数 ≥ 6」筛,再按关系完整度取前 1200 条入图。全量入图会让力导向图无法阅读、页面明显卡顿。想要更多就调 medkg/settings.py 的 KG["MAX_DISEASES"] 再重跑 build_graph,建议不超过 2000。
关系为什么不分轻重?
源数据只说「这个病有这些症状」,不给同现次数或典型程度。按位置拍脑袋加权(排前面的更重要)结论无法解释,也无法向读者交代。所以权重统一为 1,改用症状自身的度数做区分度加权 —— 越少见的症状权重越高。
「贫血」怎么既是症状又是病?
数据里确实两种都有。系统以(类型, 名称)为唯一键,存成两个节点,统计时分开算。若只按名字合并,症状反查会把疾病名当作症状统计,结果会失真。
为什么搜「发热」几乎没结果?
因为数据里「发热」只关联 1 个疾病,而「发烧」关联 89 个,同义词没有合并。系统不会静默合并(那会改变统计口径),而是在页面提示「改搜发烧」。这个现象写进了论文 6.3 节,是本文最重要的发现之一。
这个系统能诊断吗?
不能,也不应该这样用。它只做公开资料的结构化整理与关系检索:症状反查返回的是「哪些病的症状与所选词重合最多」,不是医学结论。页面底部有固定免责声明,论文里也写明了。
问答能听懂多复杂的问法?
6 类固定问法:病→症状、症状→病、病→药、病→科室、病→检查、是什么。用正则模板匹配,换一种说法可能就匹配不到 —— 但匹配不到时会明确说「没识别出实体」,而不是编一个答案。
数据能导入 Neo4j 吗?
能。build_graph 会同时导出 data/analysis/nodes.csv 与 rels.csv,字段就是 Neo4j LOAD CSV 需要的格式,页面「数据下载」里给了两段可直接用的 Cypher。
有哪几种系统角色?
访客无需登录即可看全部 9 个页面并下载数据;管理员通过 Django admin 维护疾病、实体与关系,并查看构建与问答日志(演示账号 admin / admin123456)。
常见报错怎么办?
端口占用换 8088;缺依赖 pip install -r requirements.txt;图谱空白先查 static/vendor/echarts.min.js;改完 MAX_DISEASES 必须重跑 build_graph。说明文档第八节给了完整对照表。