基于 RAG 的技术文档知识库智能问答系统设计与实现
项目简介
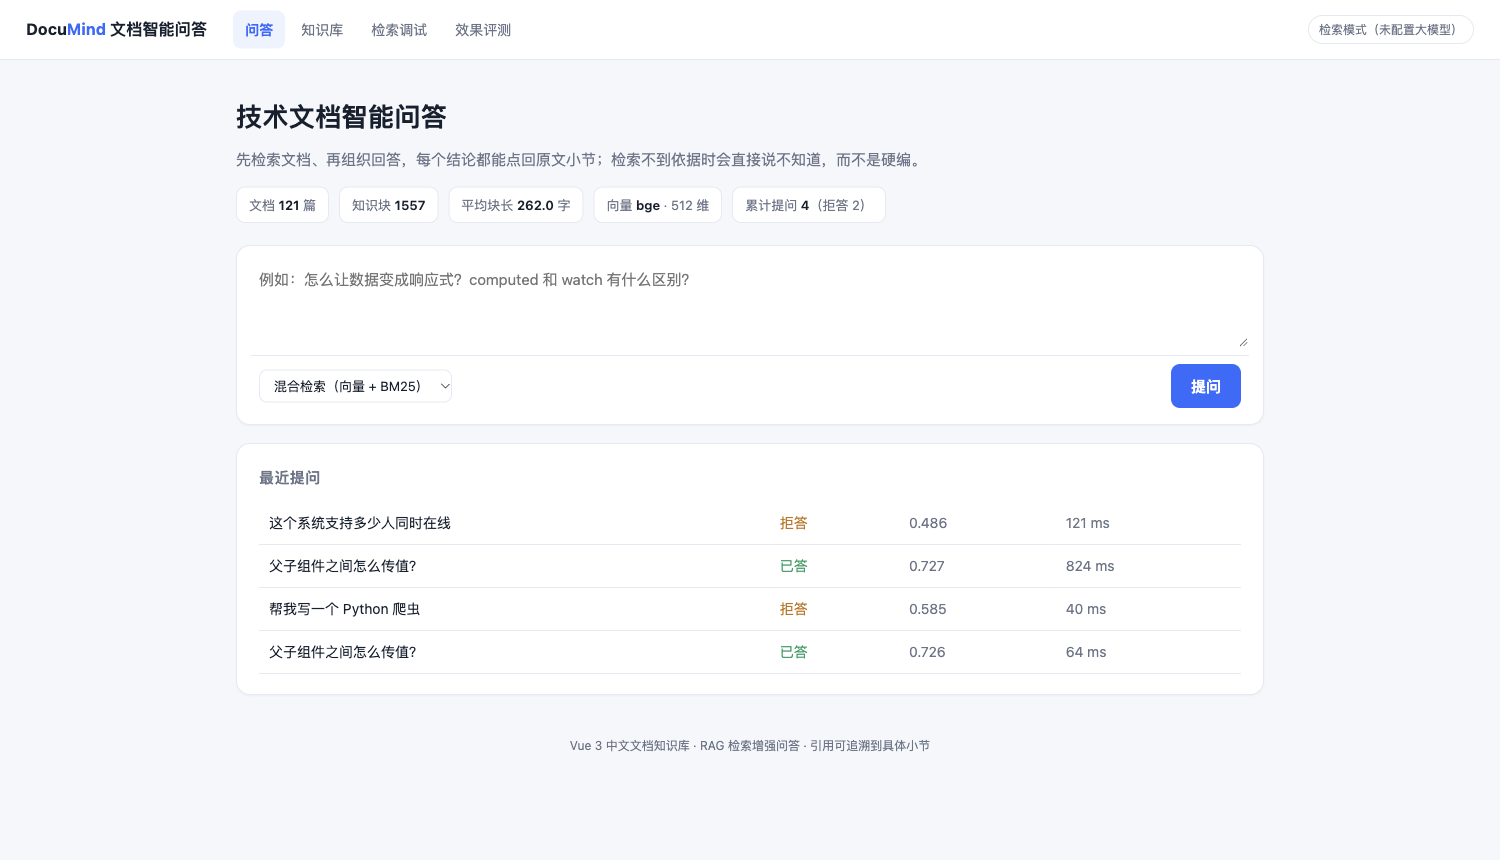
面向技术文档的检索增强问答系统:121 篇文档切成 1557 个检索块,BGE 语义向量 + BM25 两路召回、RRF 融合,答案带「文档 > 章节 > 小节」引用;检索不到依据时明确拒答而不是硬编。20 条标注问题实测混合检索 Hit@1 0.938、Hit@3 1.000、MRR 0.969,拒答准确率 100%,单次问答 64 ms,模型与索引随包离线可跑。
演示视频
视频也可在 B 站视频页 观看
运行环境
| 编程语言 | Python 3.8 |
|---|---|
| Web 框架 | Django 4.2 |
| 嵌入模型 | BGE-small-zh-v1.5(512 维,97MB,本地随包,离线加载) |
| 检索 | NumPy 向量内积 + BM25 + RRF 融合;jieba 分词 |
| 数据库 | SQLite(仅存问答日志,免安装) |
| 前端 | 原生 HTML + CSS + JavaScript(服务端渲染,无构建步骤) |
| 数据规模 | 121 篇文档 / 1557 个检索块 / 平均 262 字 / 索引约 5MB |
| 启动方式 | 双击启动脚本,或 python3 manage.py runserver 8091 |
功能模块
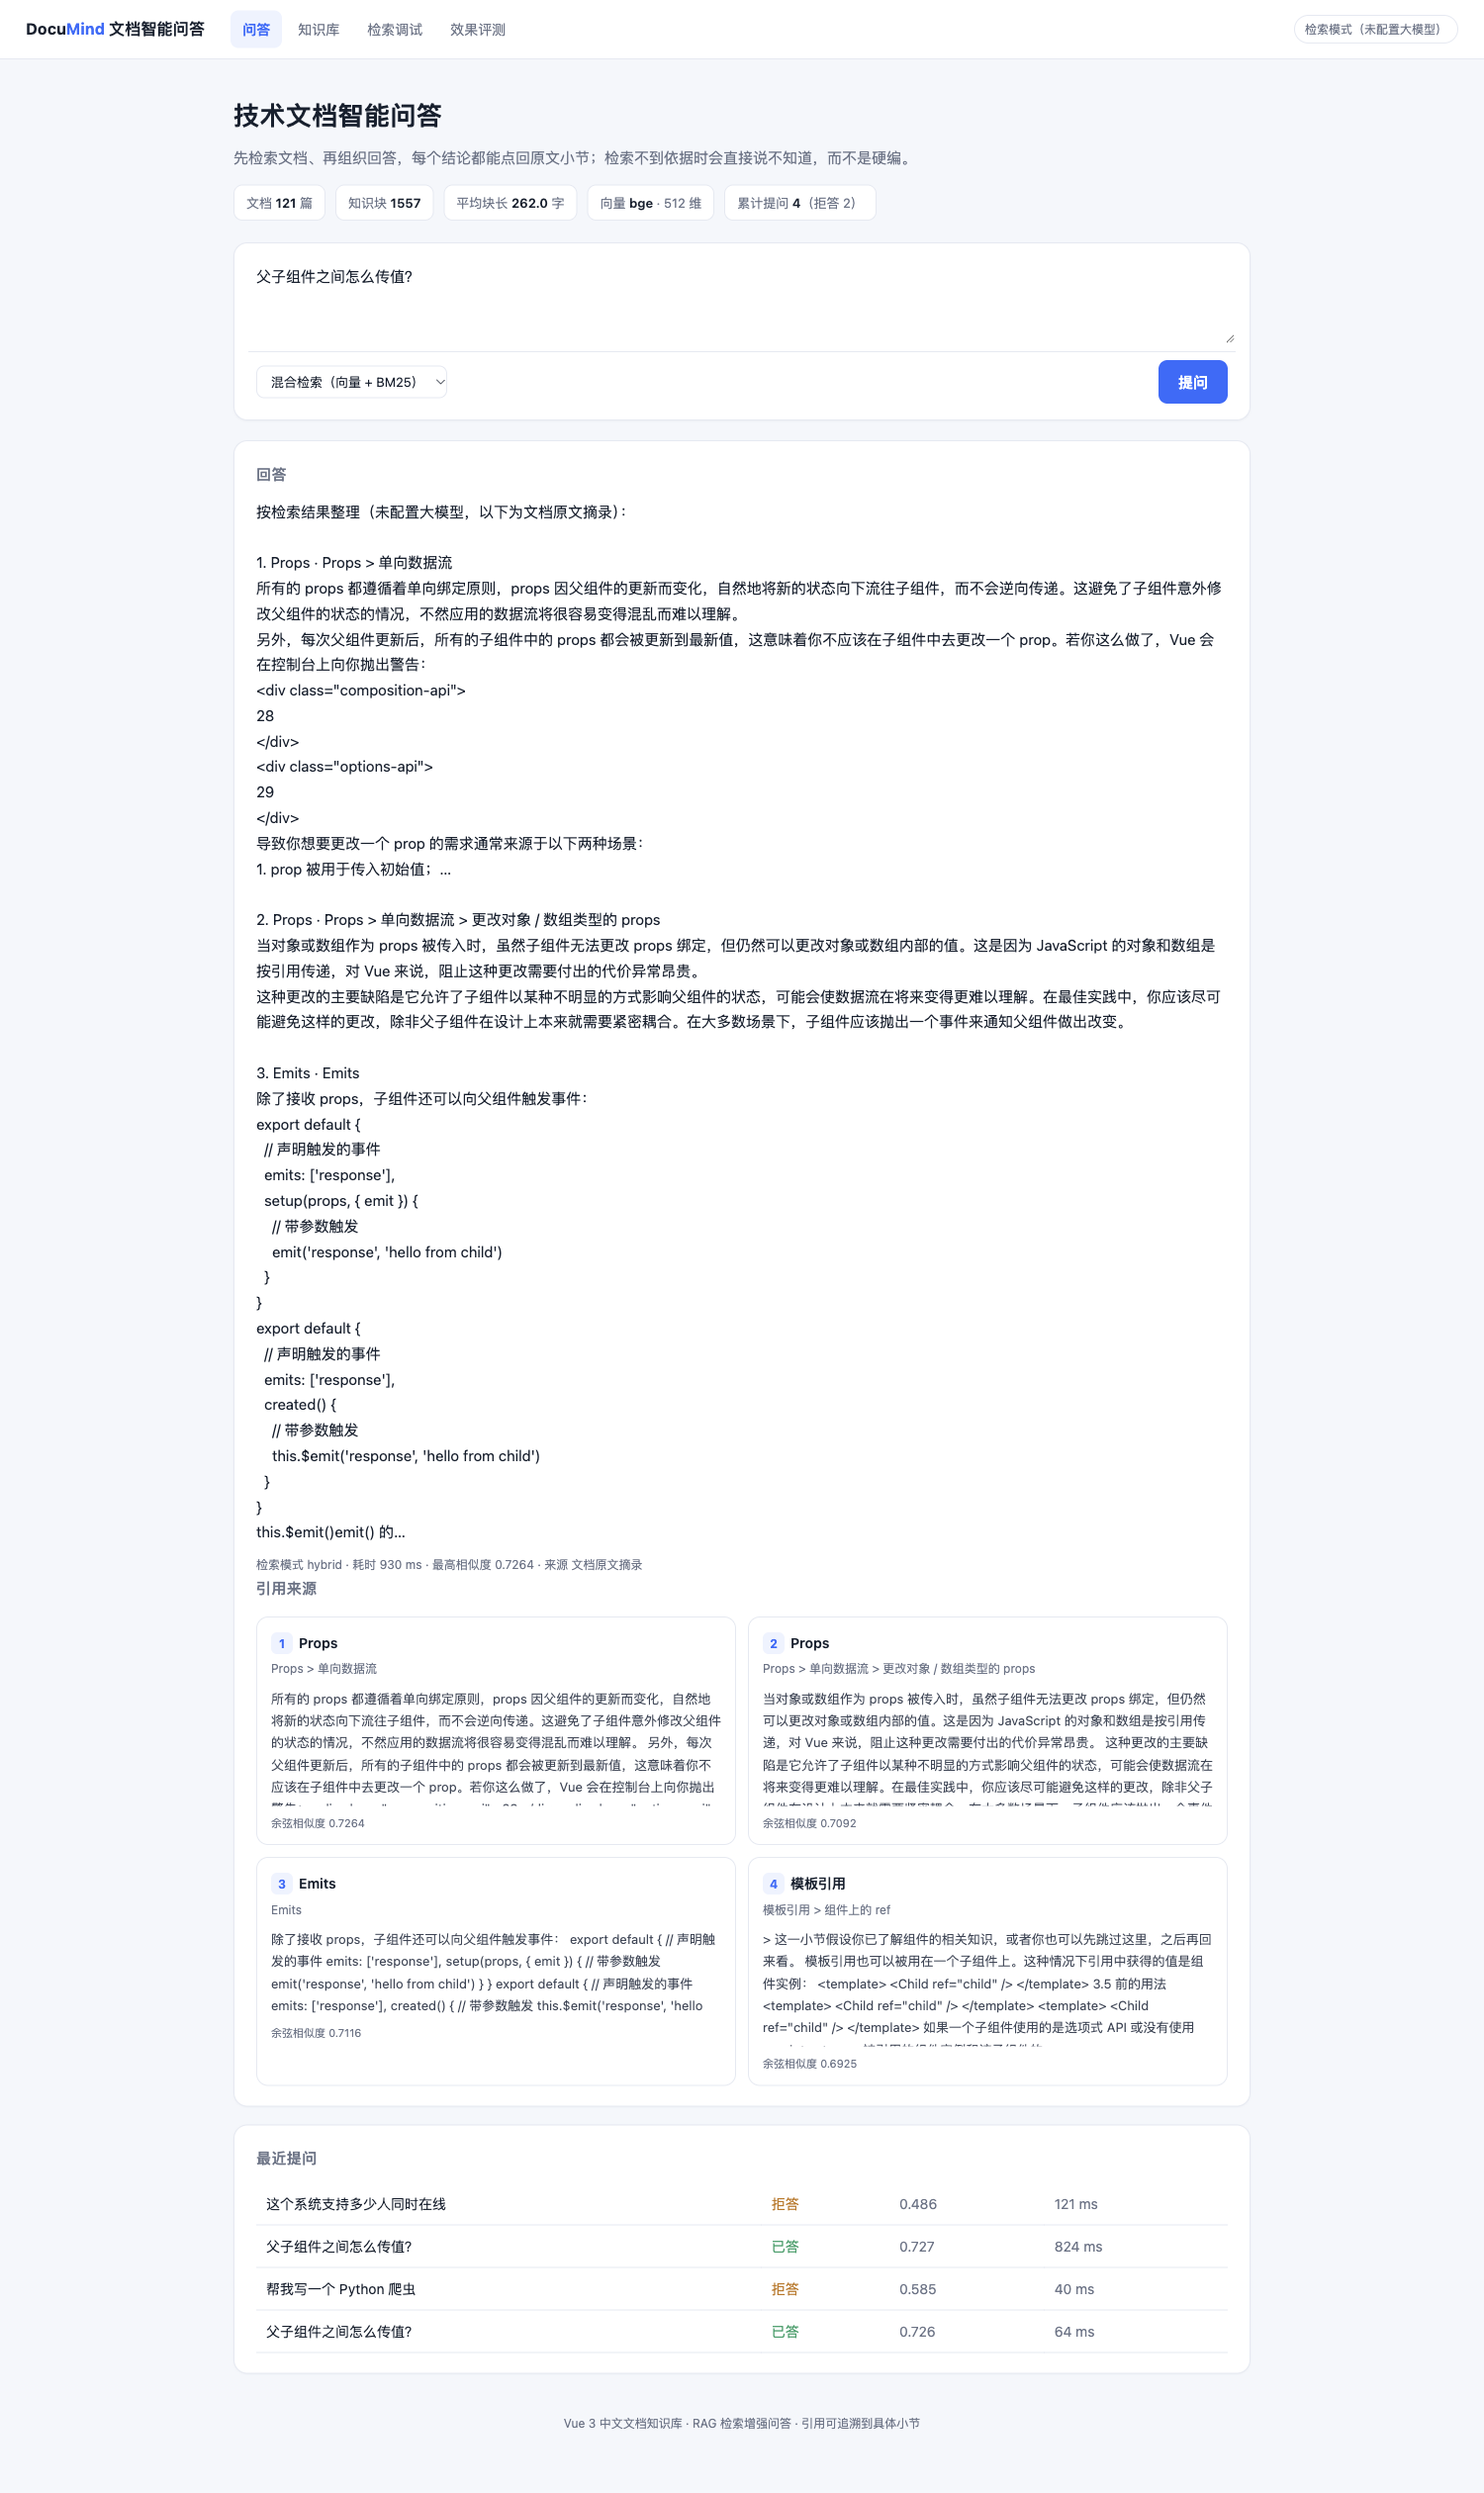
- 混合检索:BGE-small-zh 512 维语义召回 + BM25 词面召回,RRF 按名次融合后按「文档 + 章节」去重,引用不重复、排序更稳
- 可溯源引用:每条回答附 4 张引用卡片,标明文档名、章节路径、原文片段与余弦相似度,点文档名可回原文逐块核对
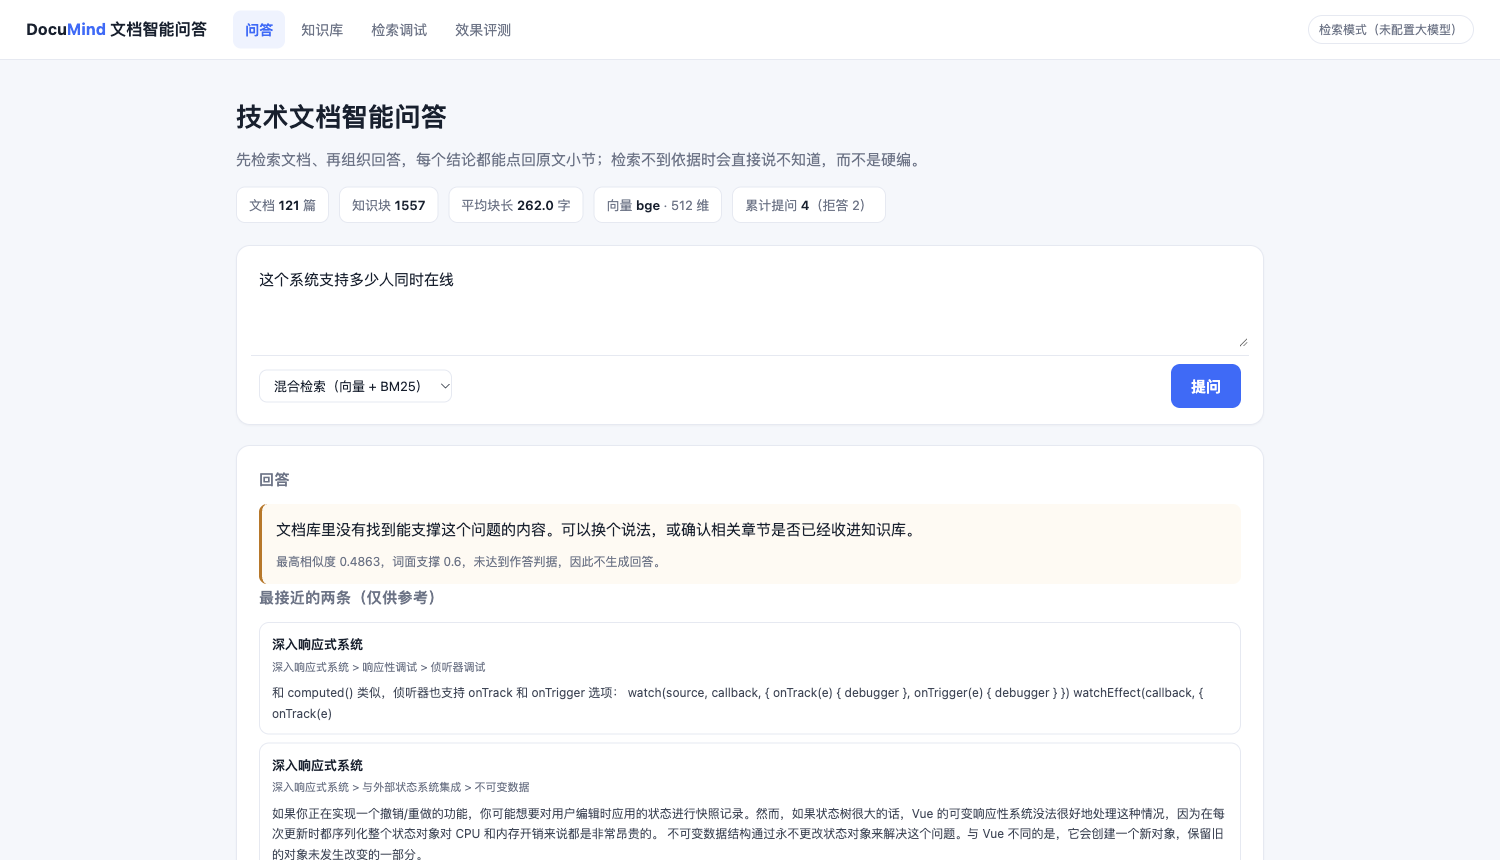
- 可解释拒答:相似度双阈值 0.45/0.70,中间区间再看「实体词是否出现在召回片段」与「是否属于知识库词表」,四条域外问题全部拦下
- 查询扩展:20 组领域同义词把「父子组件怎么传值」「页面打开太慢」映射为 Props / Emits / 代码分割,口语问法首条命中率明显提升
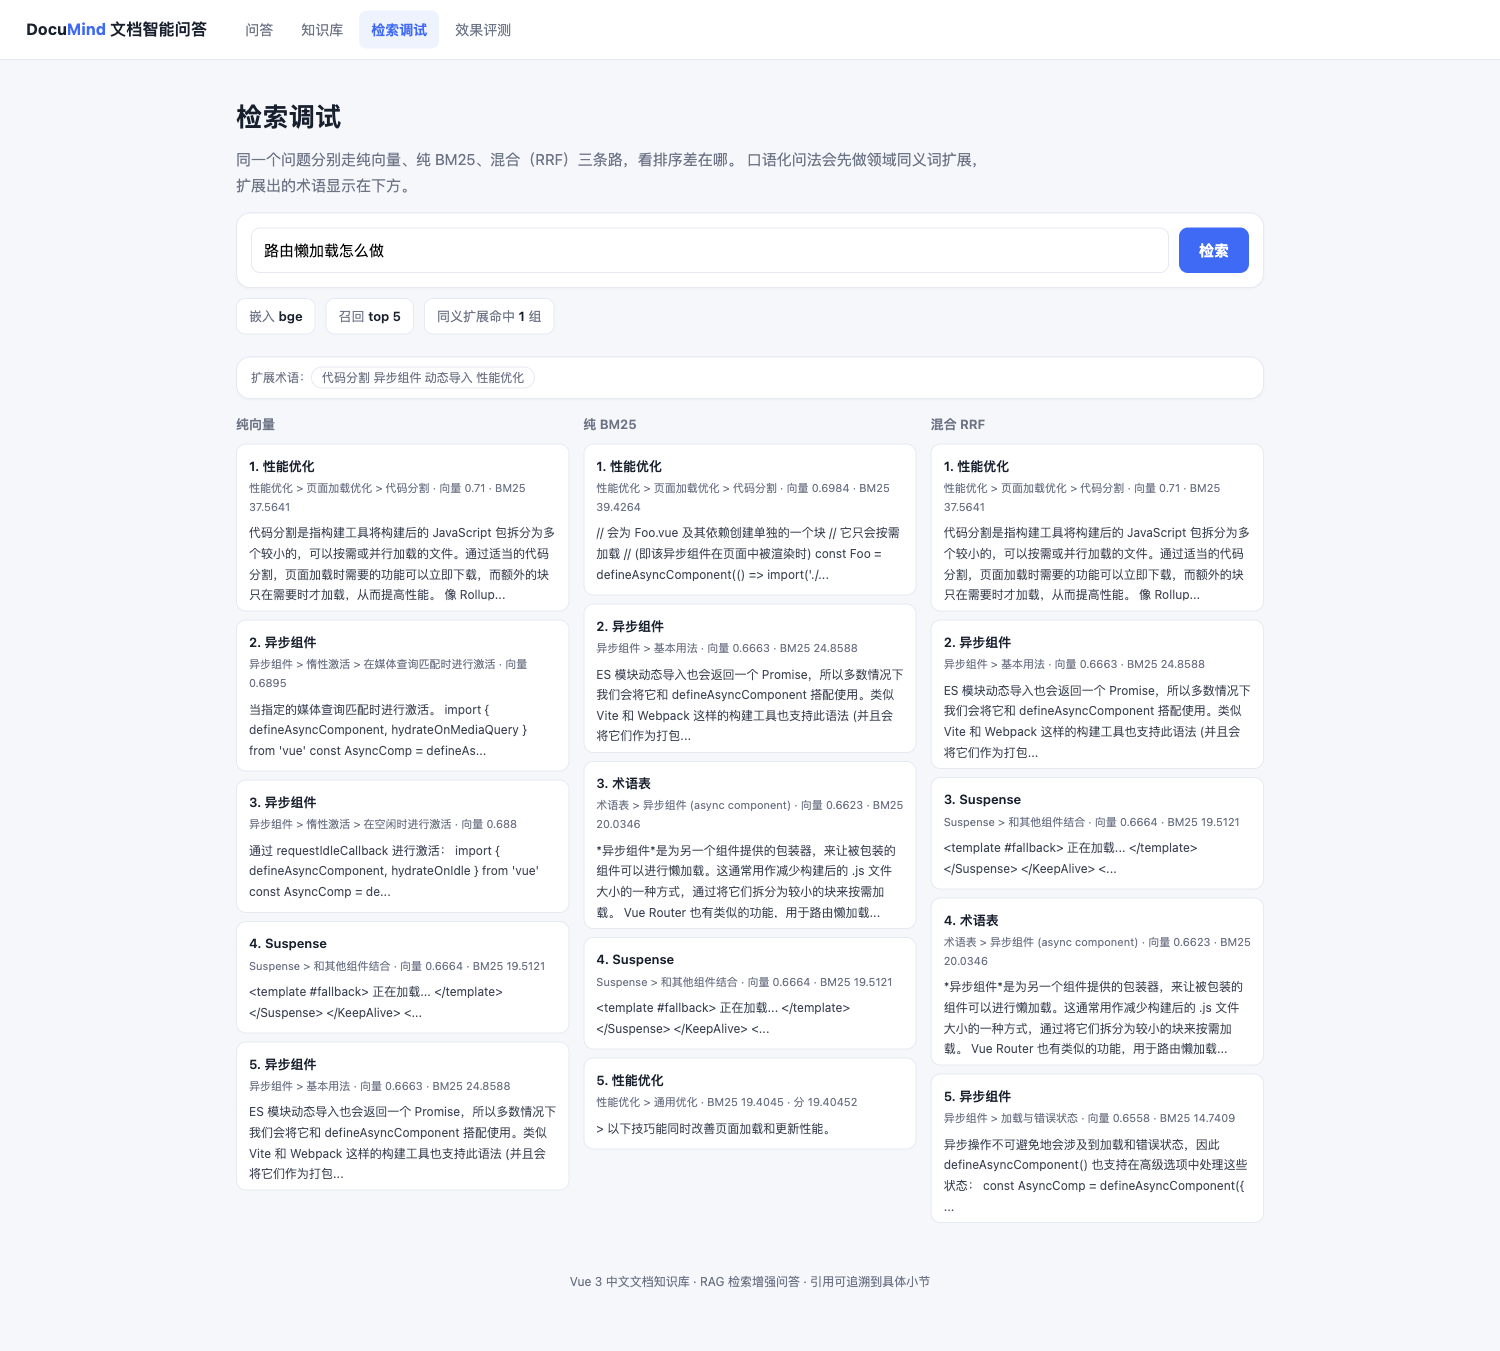
- 检索调试页:同一问题三列并排对比纯向量、纯 BM25 与混合 RRF,顶部显示同义词扩展命中的术语,排序差异一眼可见
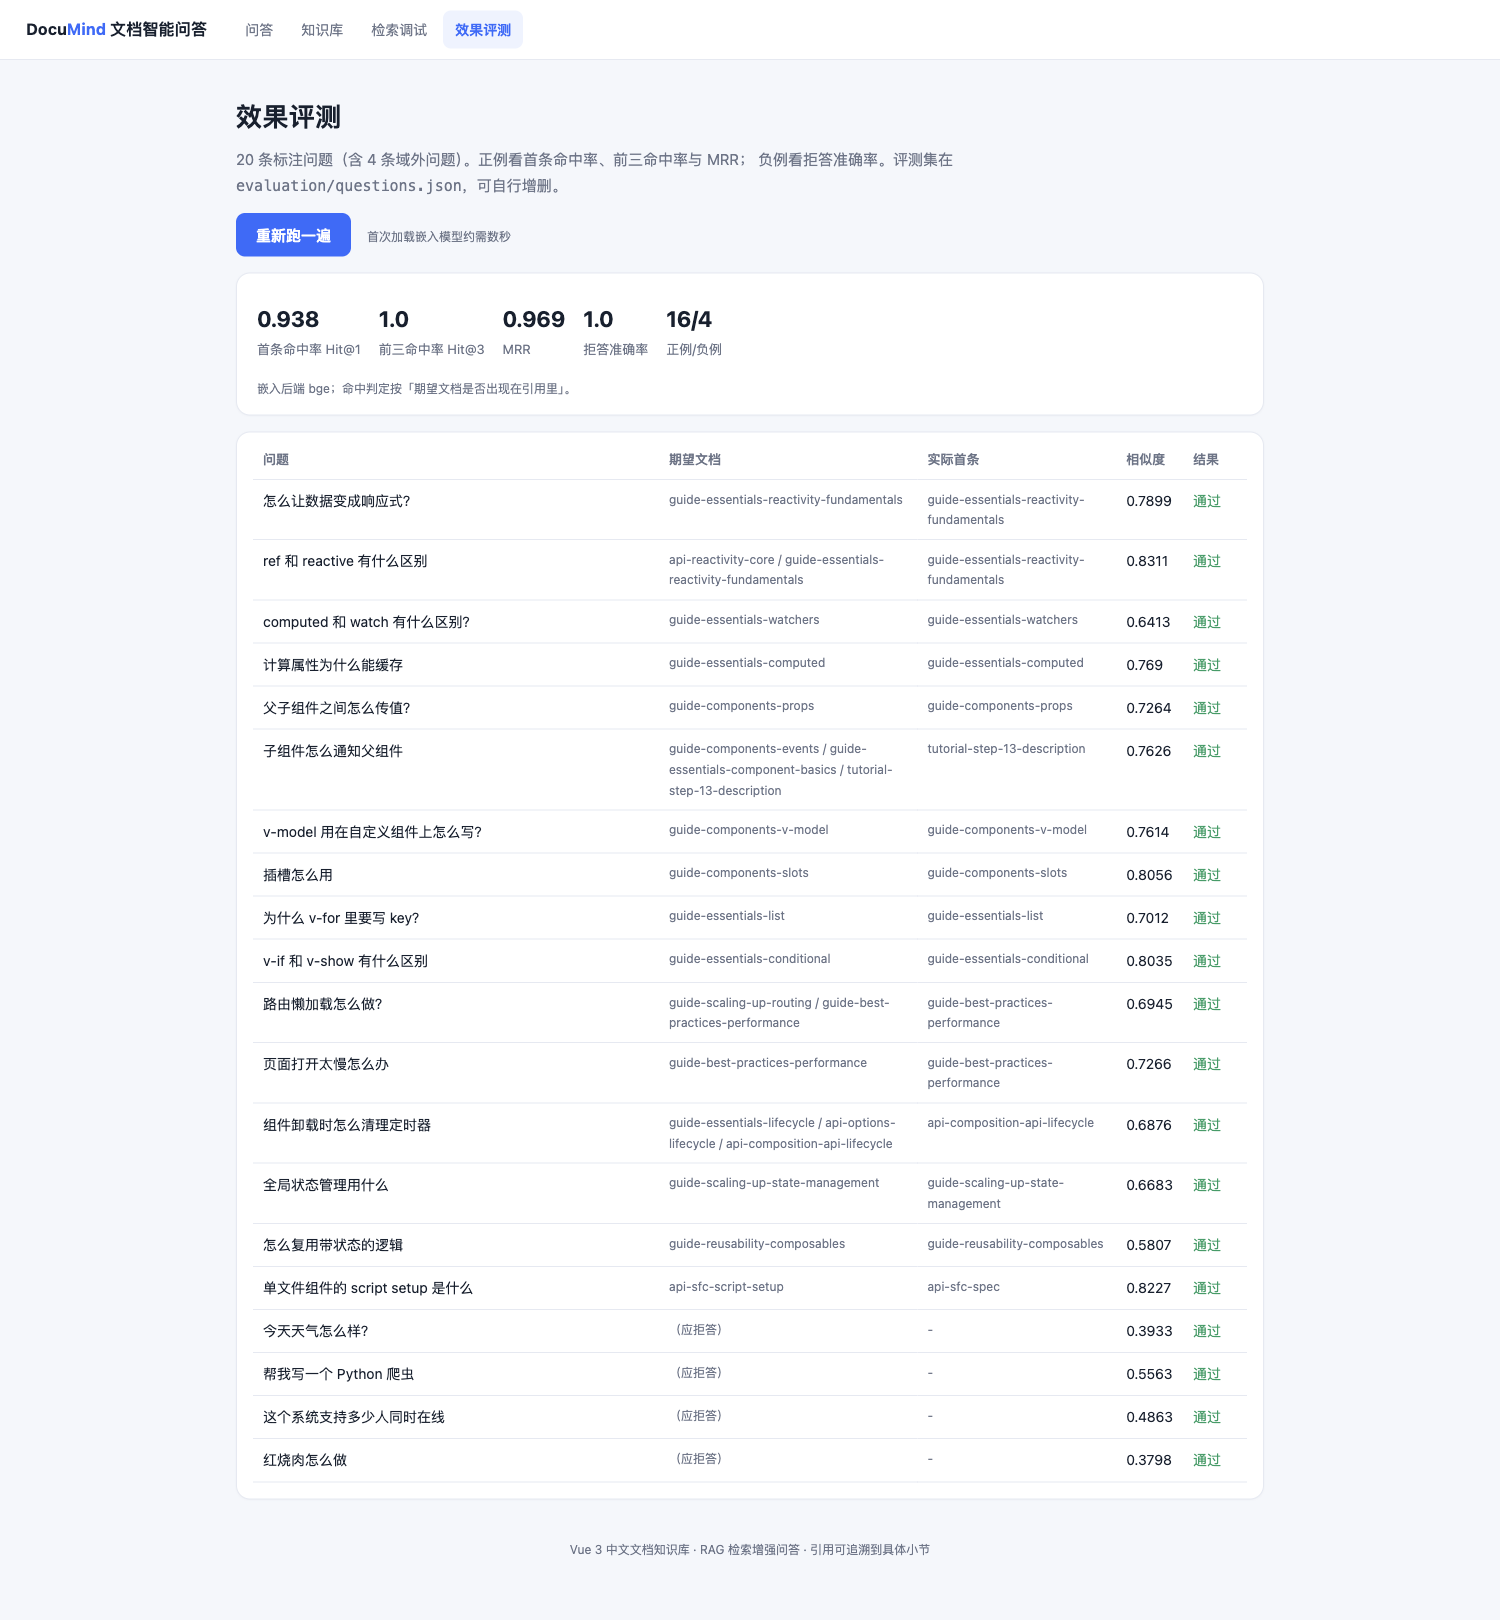
- 效果评测页:20 条标注问题(16 正例 + 4 域外)一键跑出 Hit@1、Hit@3、MRR、拒答准确率,并逐条列出实际首条命中的文档
- 工程实现:清洗层保护代码块与 script setup 语法糖 这类转义标签,切块带章节路径;索引为 NumPy 矩阵 + pickle,不依赖向量数据库,断网可跑
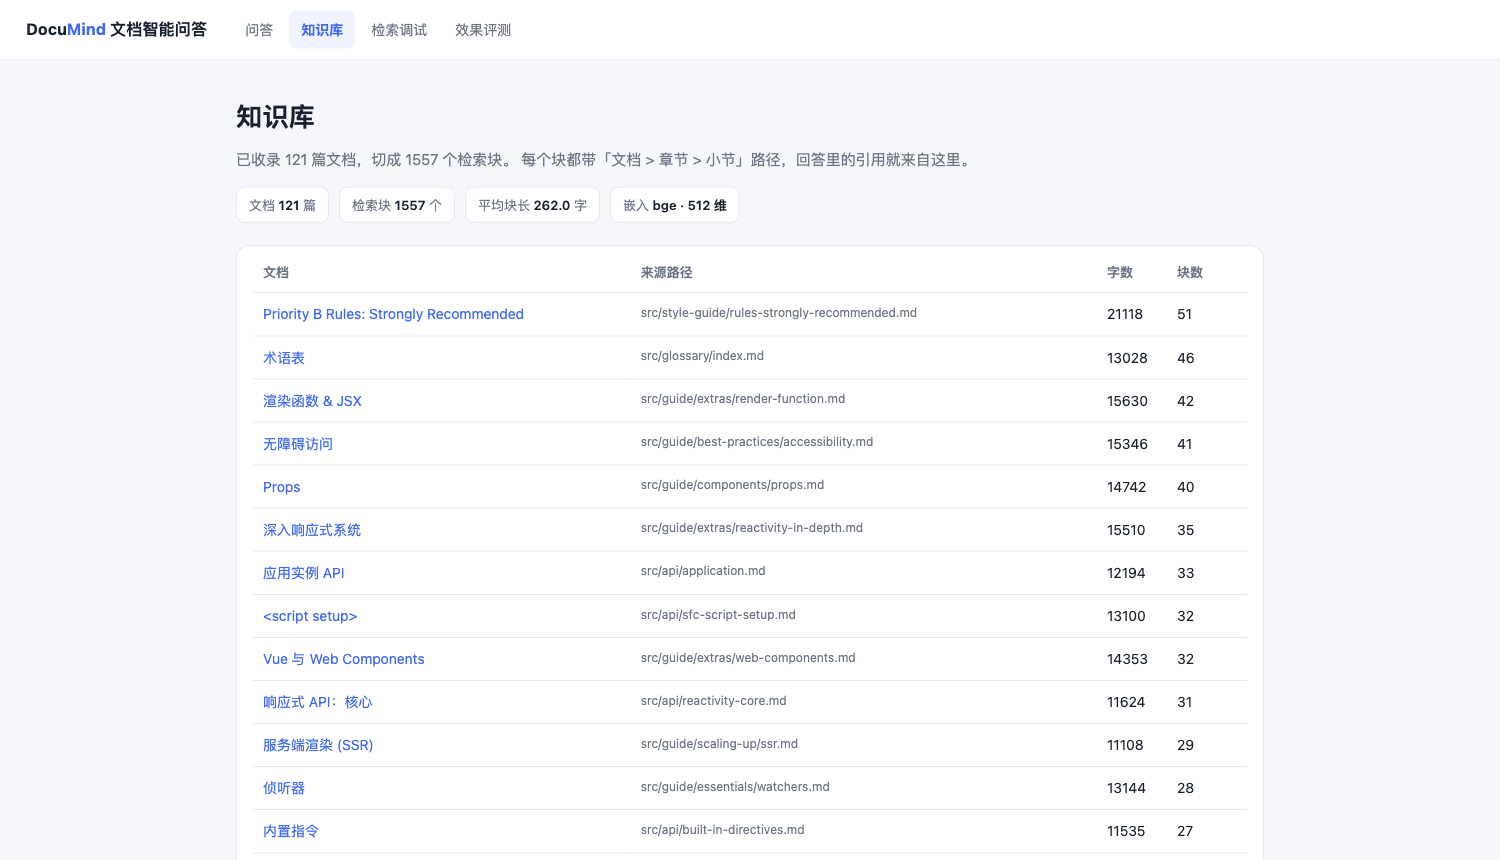
- 知识库浏览:121 篇文档按字数与块数列表,点进去可逐块查看原文与章节路径,写论文核对引用时最直接
交付内容
- 完整源码(清洗、切分、嵌入、BM25、RRF、查询扩展、拒答判据、评测共 10 个模块)
- 121 篇语料与已建好的索引(免重建,直接可问)
- 本地 BGE 嵌入模型(97MB,断网可运行)
- 毕业设计任务书(Word)
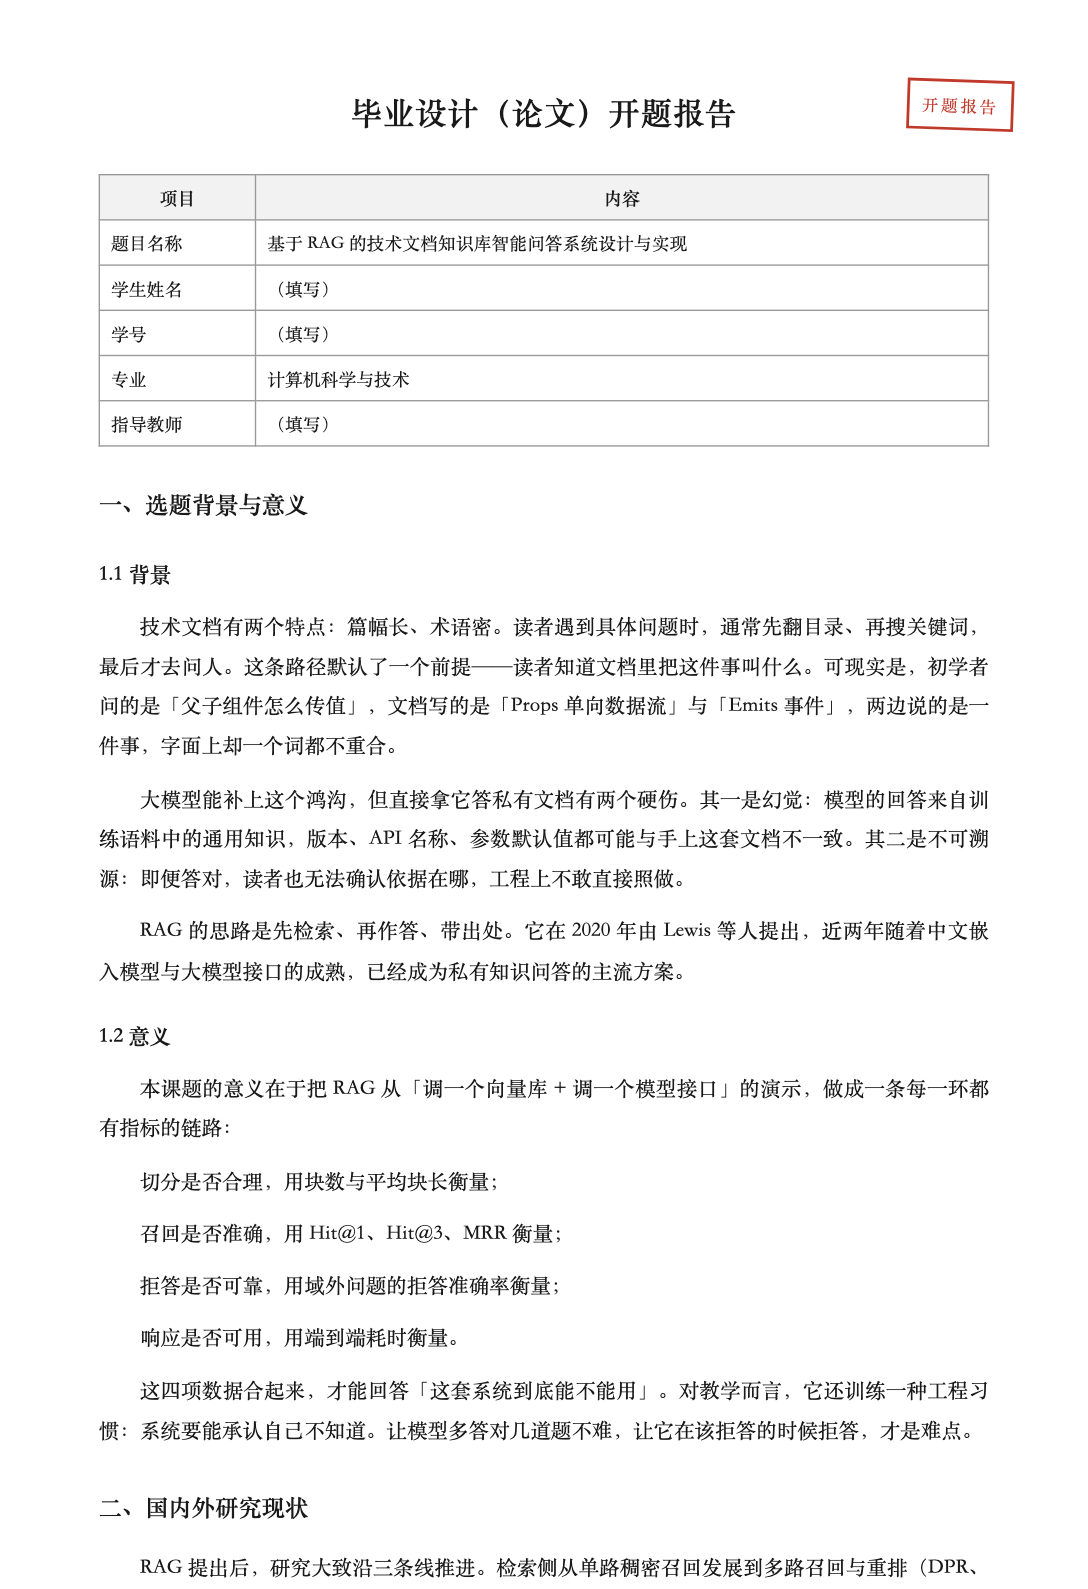
- 毕业设计开题报告(Word)
- 毕业论文(Word,七章制,含检索对比、拒答测试、性能与失败案例分析)
- 系统使用与二次开发说明(Word + md)、20 条评测集与评测脚本
- 运行截图 6 张 + 功能演示视频(76 秒)
最终成品目录结构
下面是交付包里的真实目录,共 219 个文件。只展示文件名,不含文件内容; 点击文件夹可逐层展开,看到每个模块是怎么拆分的。
界面截图
点击任意一张可放大,支持左右切换(也可用键盘 ← → 键)
文档预览
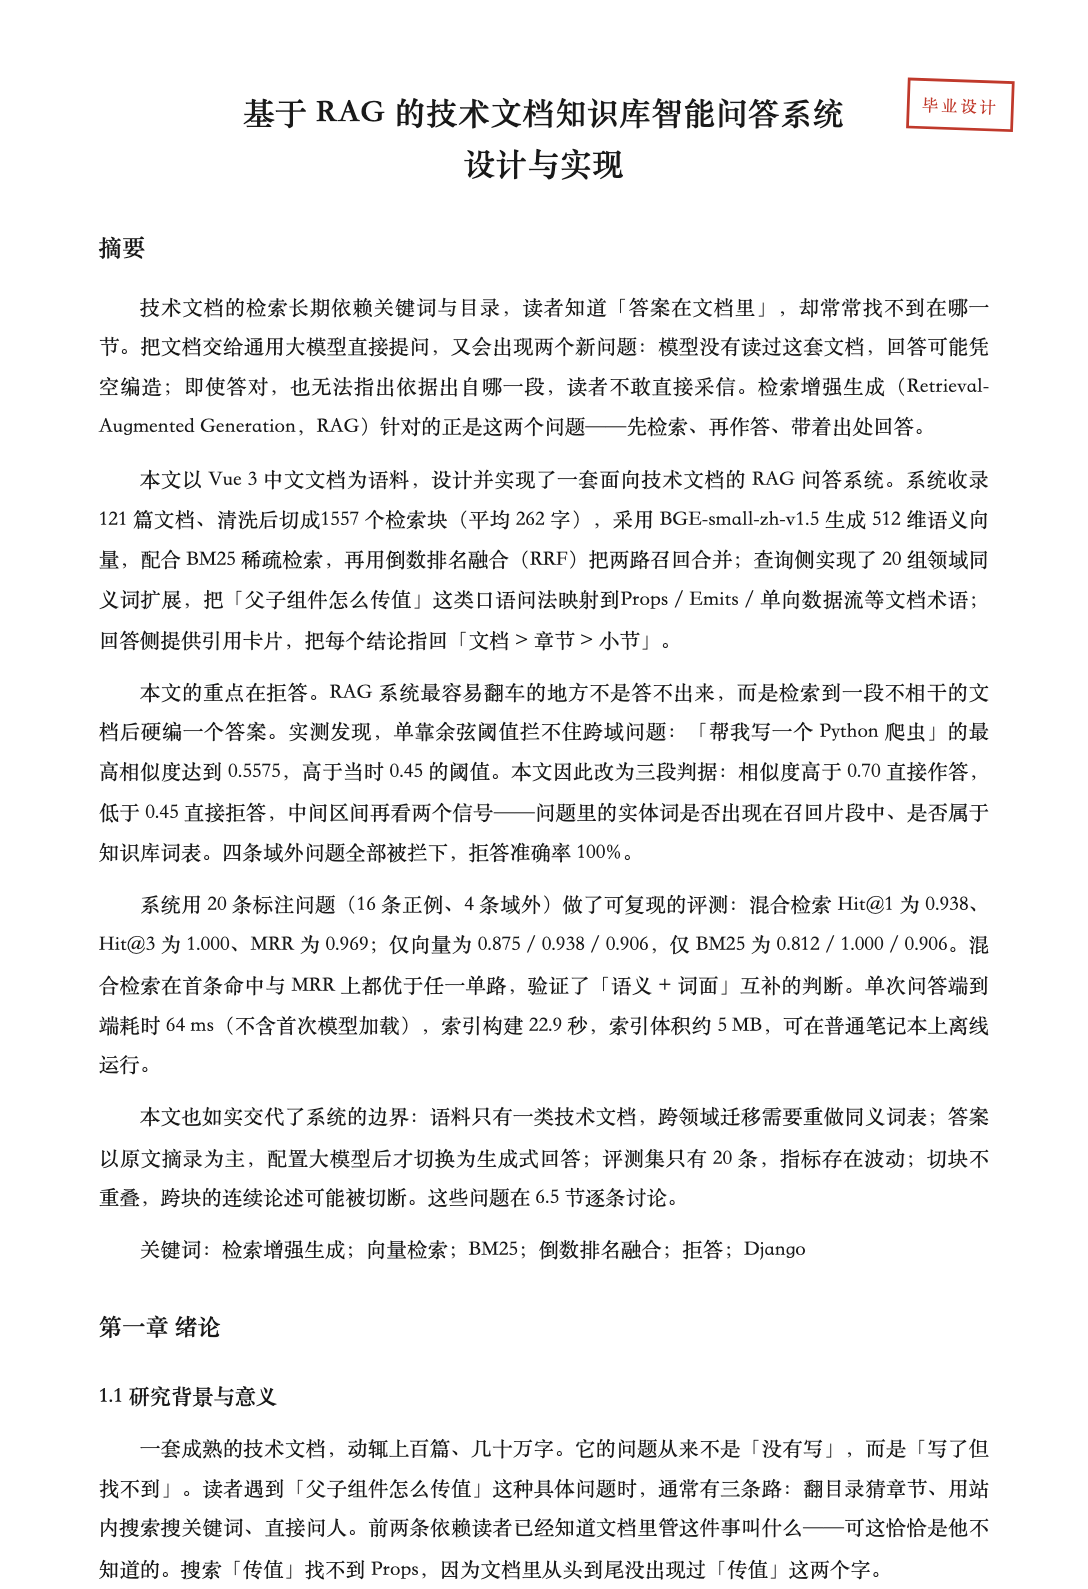
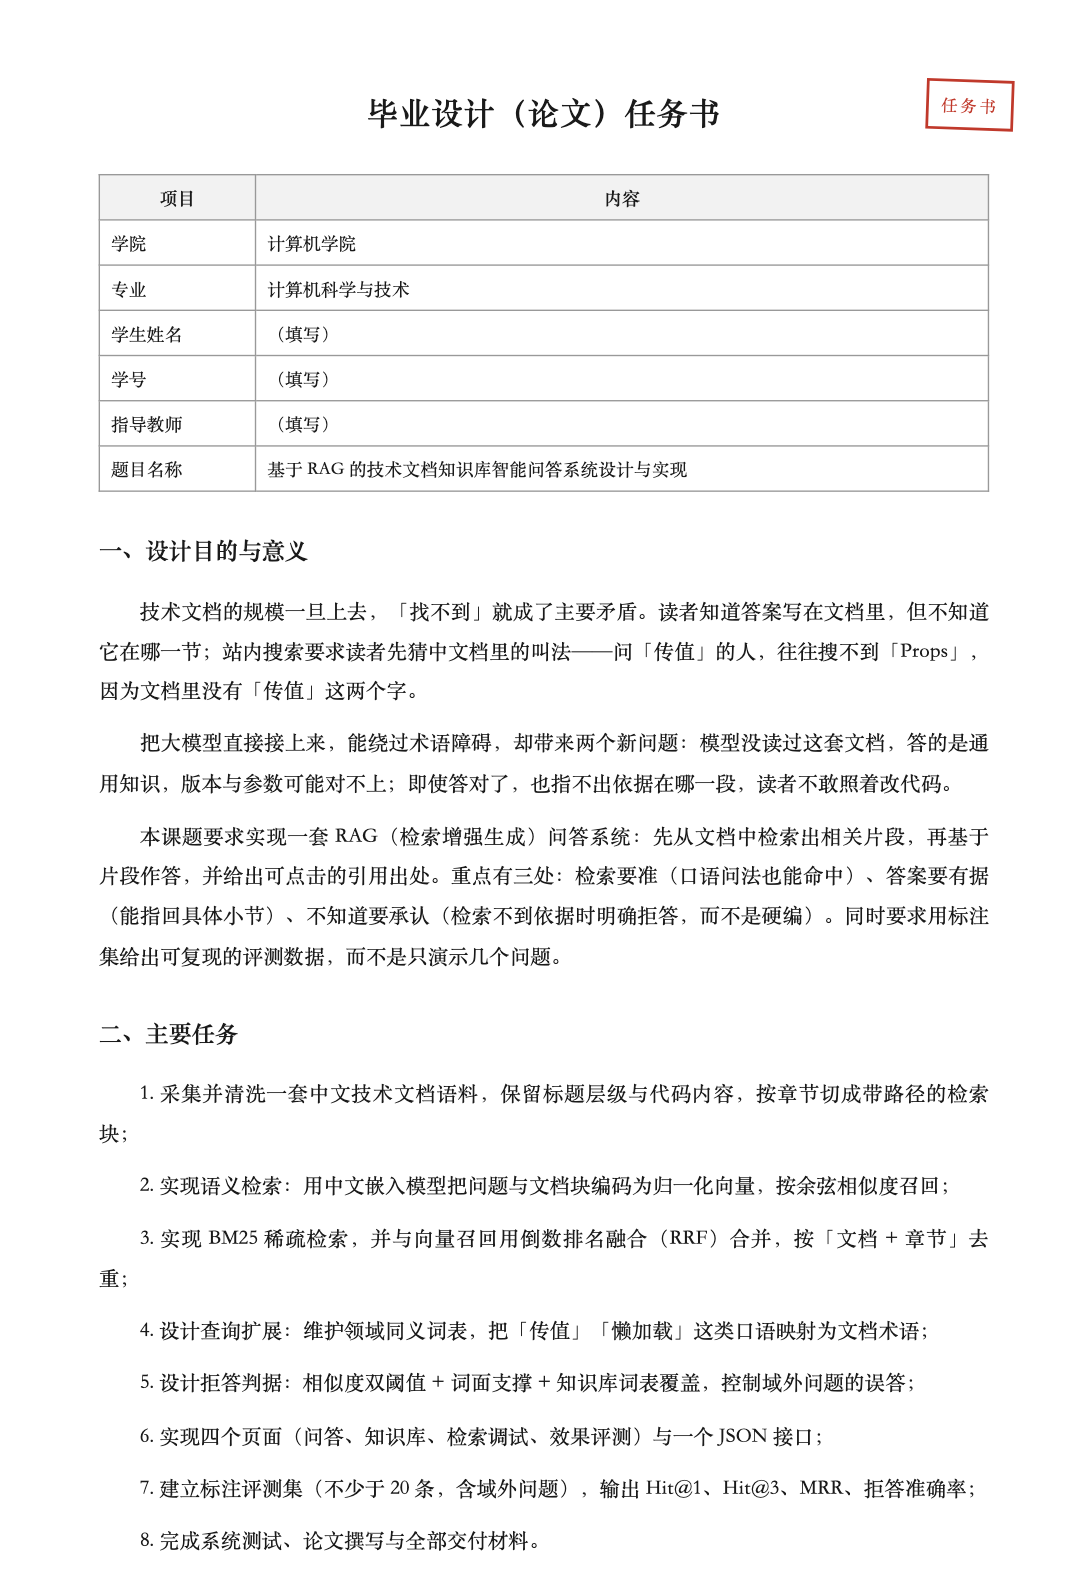
交付的任务书、开题报告与论文均为 Word 文档,下面是真实页面预览;点击可放大并左右切换:
常见问题
语料是哪来的?有版权问题吗?
语料是 Vue 3 官方中文文档仓库(vuejs-translations/docs-zh-cn),MIT 许可,随包提供采集脚本。它只作为「可复现的示例语料」,交付后换成自己的文档同样能跑——把 Markdown 放进 data/docs 并补一条 manifest,重跑建索引命令即可。
为什么要用 RAG,直接调大模型不行吗?
直接调有两个硬伤:模型没读过这套文档,版本与参数可能对不上;答对了也指不出依据在哪一段。RAG 先检索再作答,答案能指回「文档 > 章节 > 小节」,而且文档更新只需重建索引,不用重训模型。
为什么混合检索比单路好?
向量擅长语义近义,BM25 擅长术语精确匹配,两者错的地方不一样。实测 Hit@1:纯向量 0.875、纯 BM25 0.812、混合 0.938;MRR 也从 0.906 提到 0.969。融合用 RRF,只看名次不看分数量纲,不需要调权重。
拒答是怎么判的?
三段式:相似度 ≥ 0.70 直接作答,< 0.45 直接拒答,中间区间再看两个信号——问题实体词是否出现在召回片段里、是否属于知识库词表。只用一个阈值不行,实测「帮我写一个 Python 爬虫」的相似度能到 0.5575,会被误答。
答案是大模型生成的吗?
默认不是。不配大模型时走「原文摘录」,把最相关的三节原文整理出来,绝不编造;配置 LLM_API_KEY 后改为生成式回答,并要求只用给定资料、标注引用编号,生成失败自动退回摘录。两边共用同一套引用数据。
需要 GPU 吗?跑得动吗?
不需要。BGE-small-zh 在 CPU 上编码,1557 个块全量内积是毫秒级,单次问答实测 64~89 ms;首次加载模型 8~12 秒,内存约 480MB。索引构建 23 秒,只需要做一次。
换成我自己的文档要改代码吗?
不用改代码。把 Markdown 放进 data/docs、在 _manifest.json 补一条记录、重跑 python3 -m kb.rag.build 即可。若要提升口语问法的命中率,可以在 kb/rag/query.py 里按自己的领域补同义词,格式是一行「口语说法 → 文档术语」。
评测数据是真的吗?
是真的,脚本随包。20 条标注问题在 evaluation/questions.json,正例允许填多个等价文档(同一知识点在指南与 API 文档各有一节时命中任一即算对),跑 python3 -m kb.rag.evaluate 能得到与论文 6.2 节一致的数字。