基于文本相似度的学生作业查重系统设计与实现
项目简介
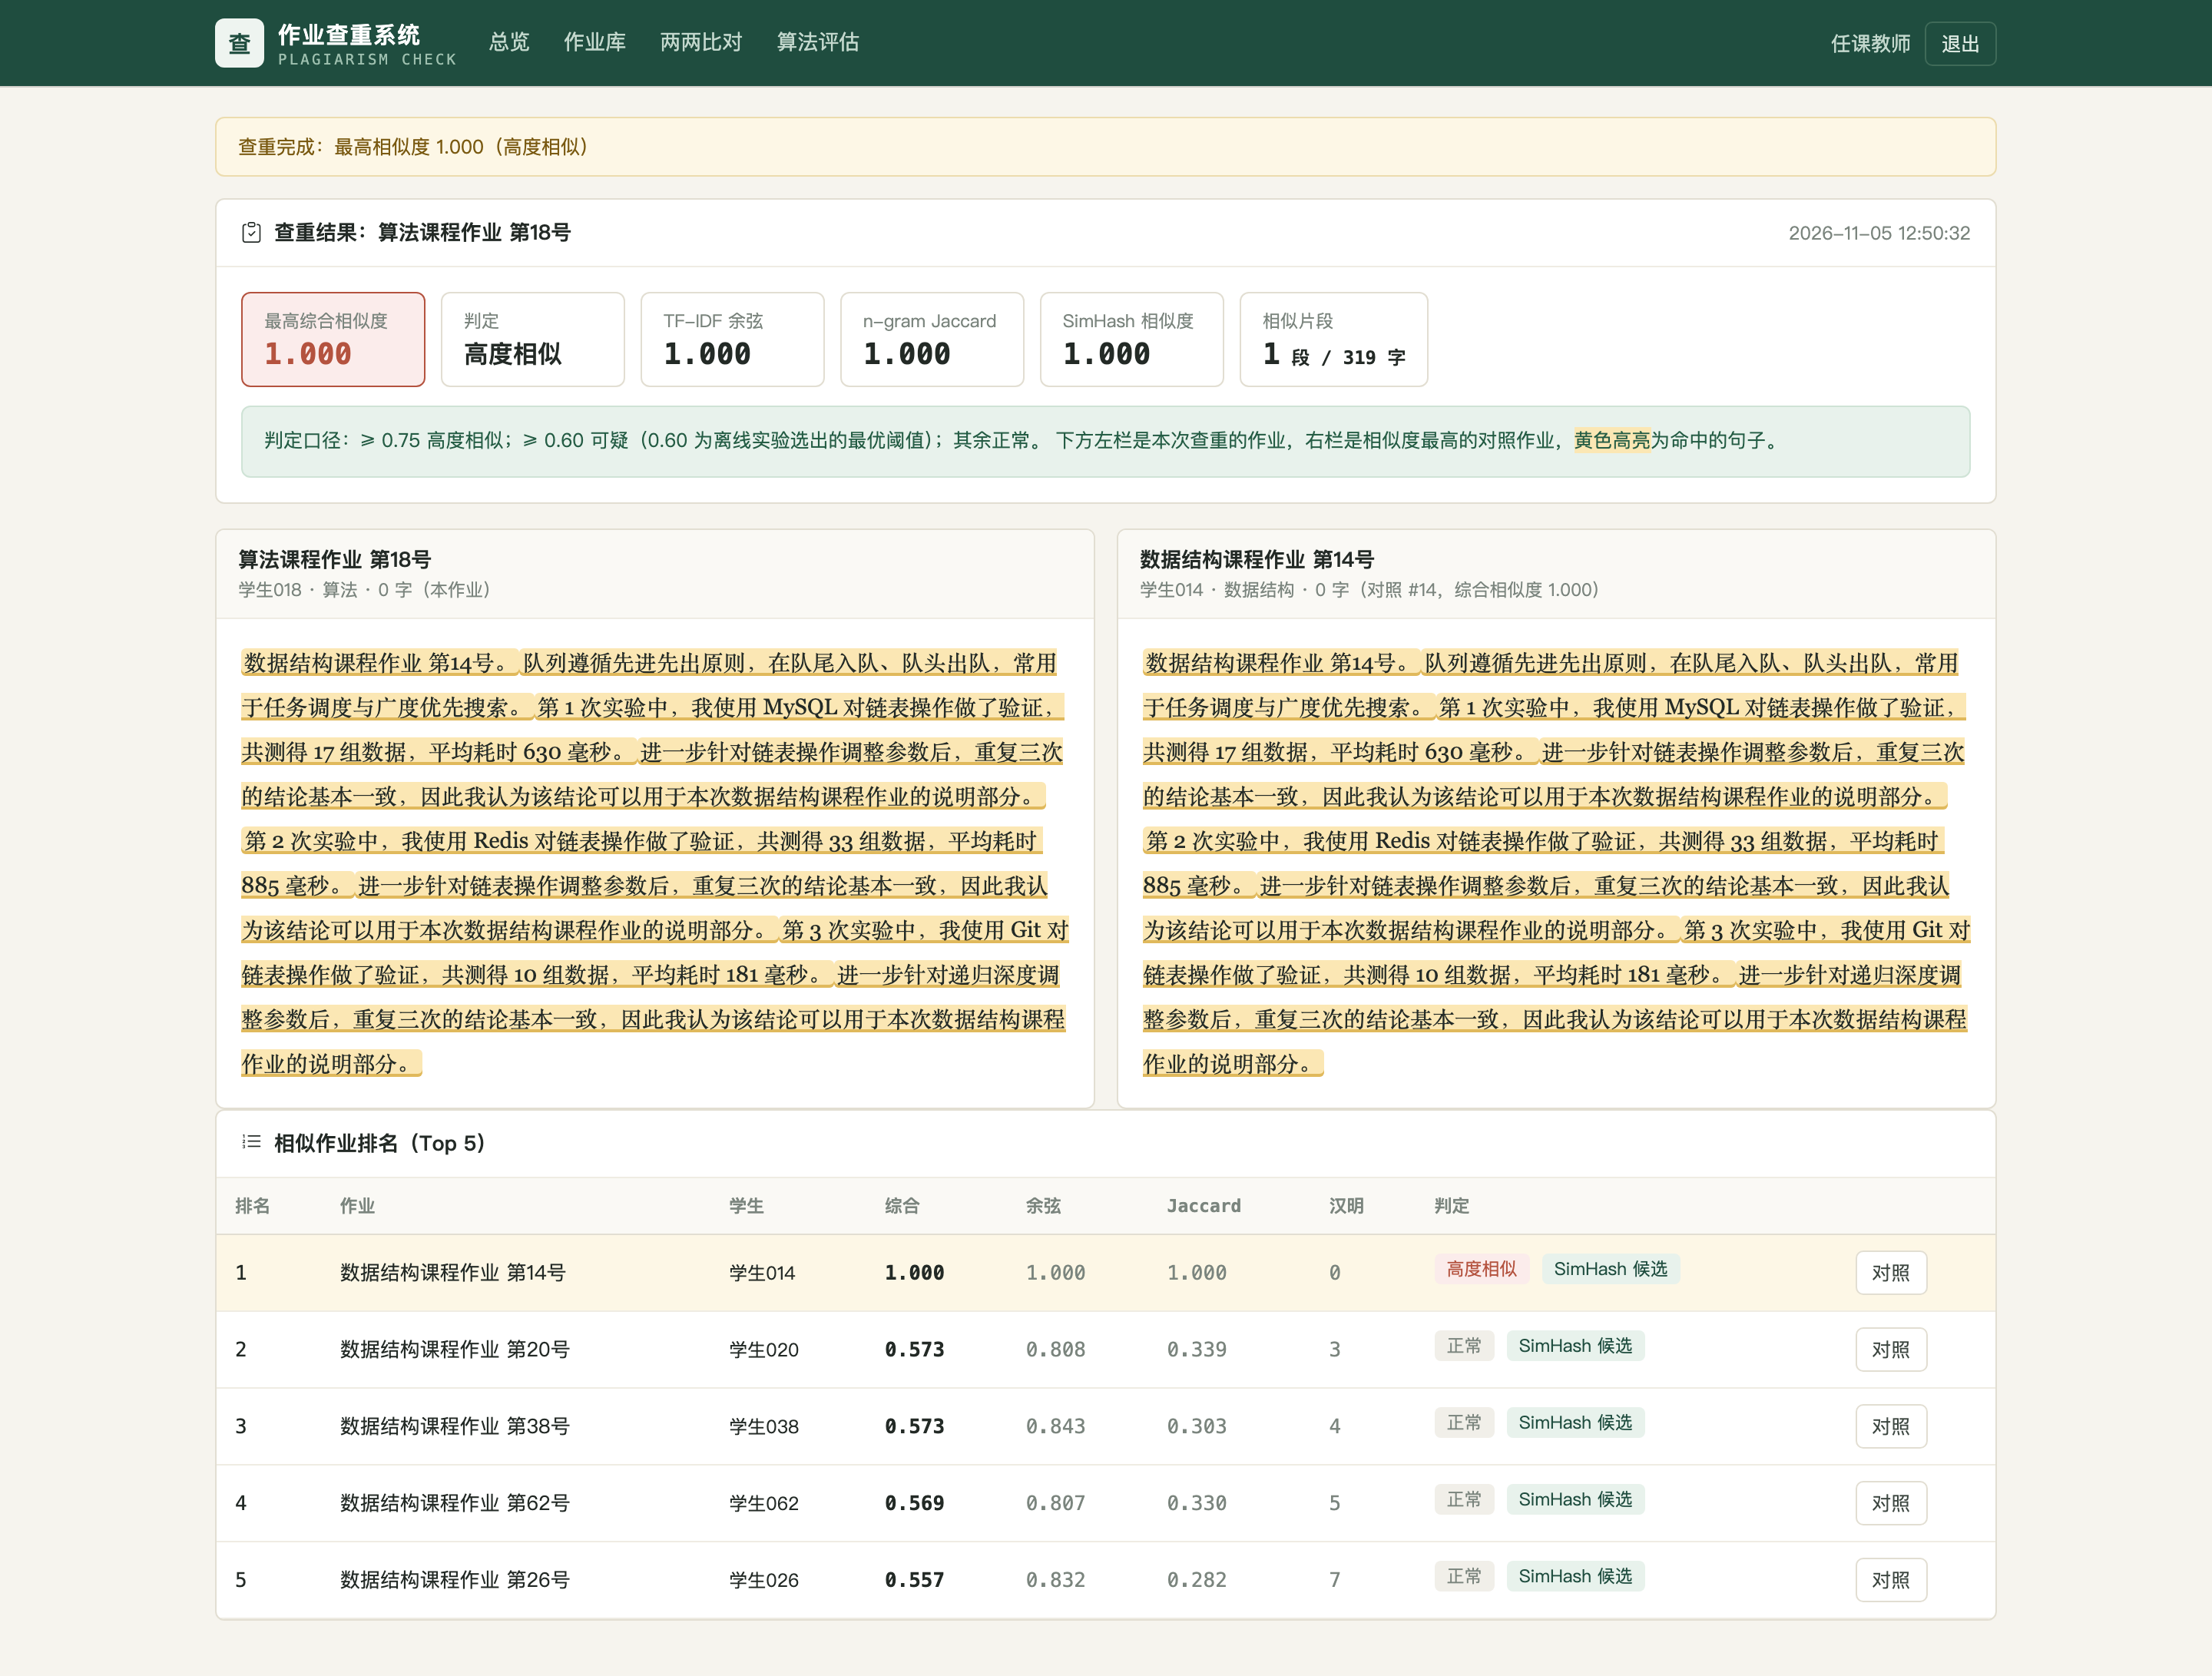
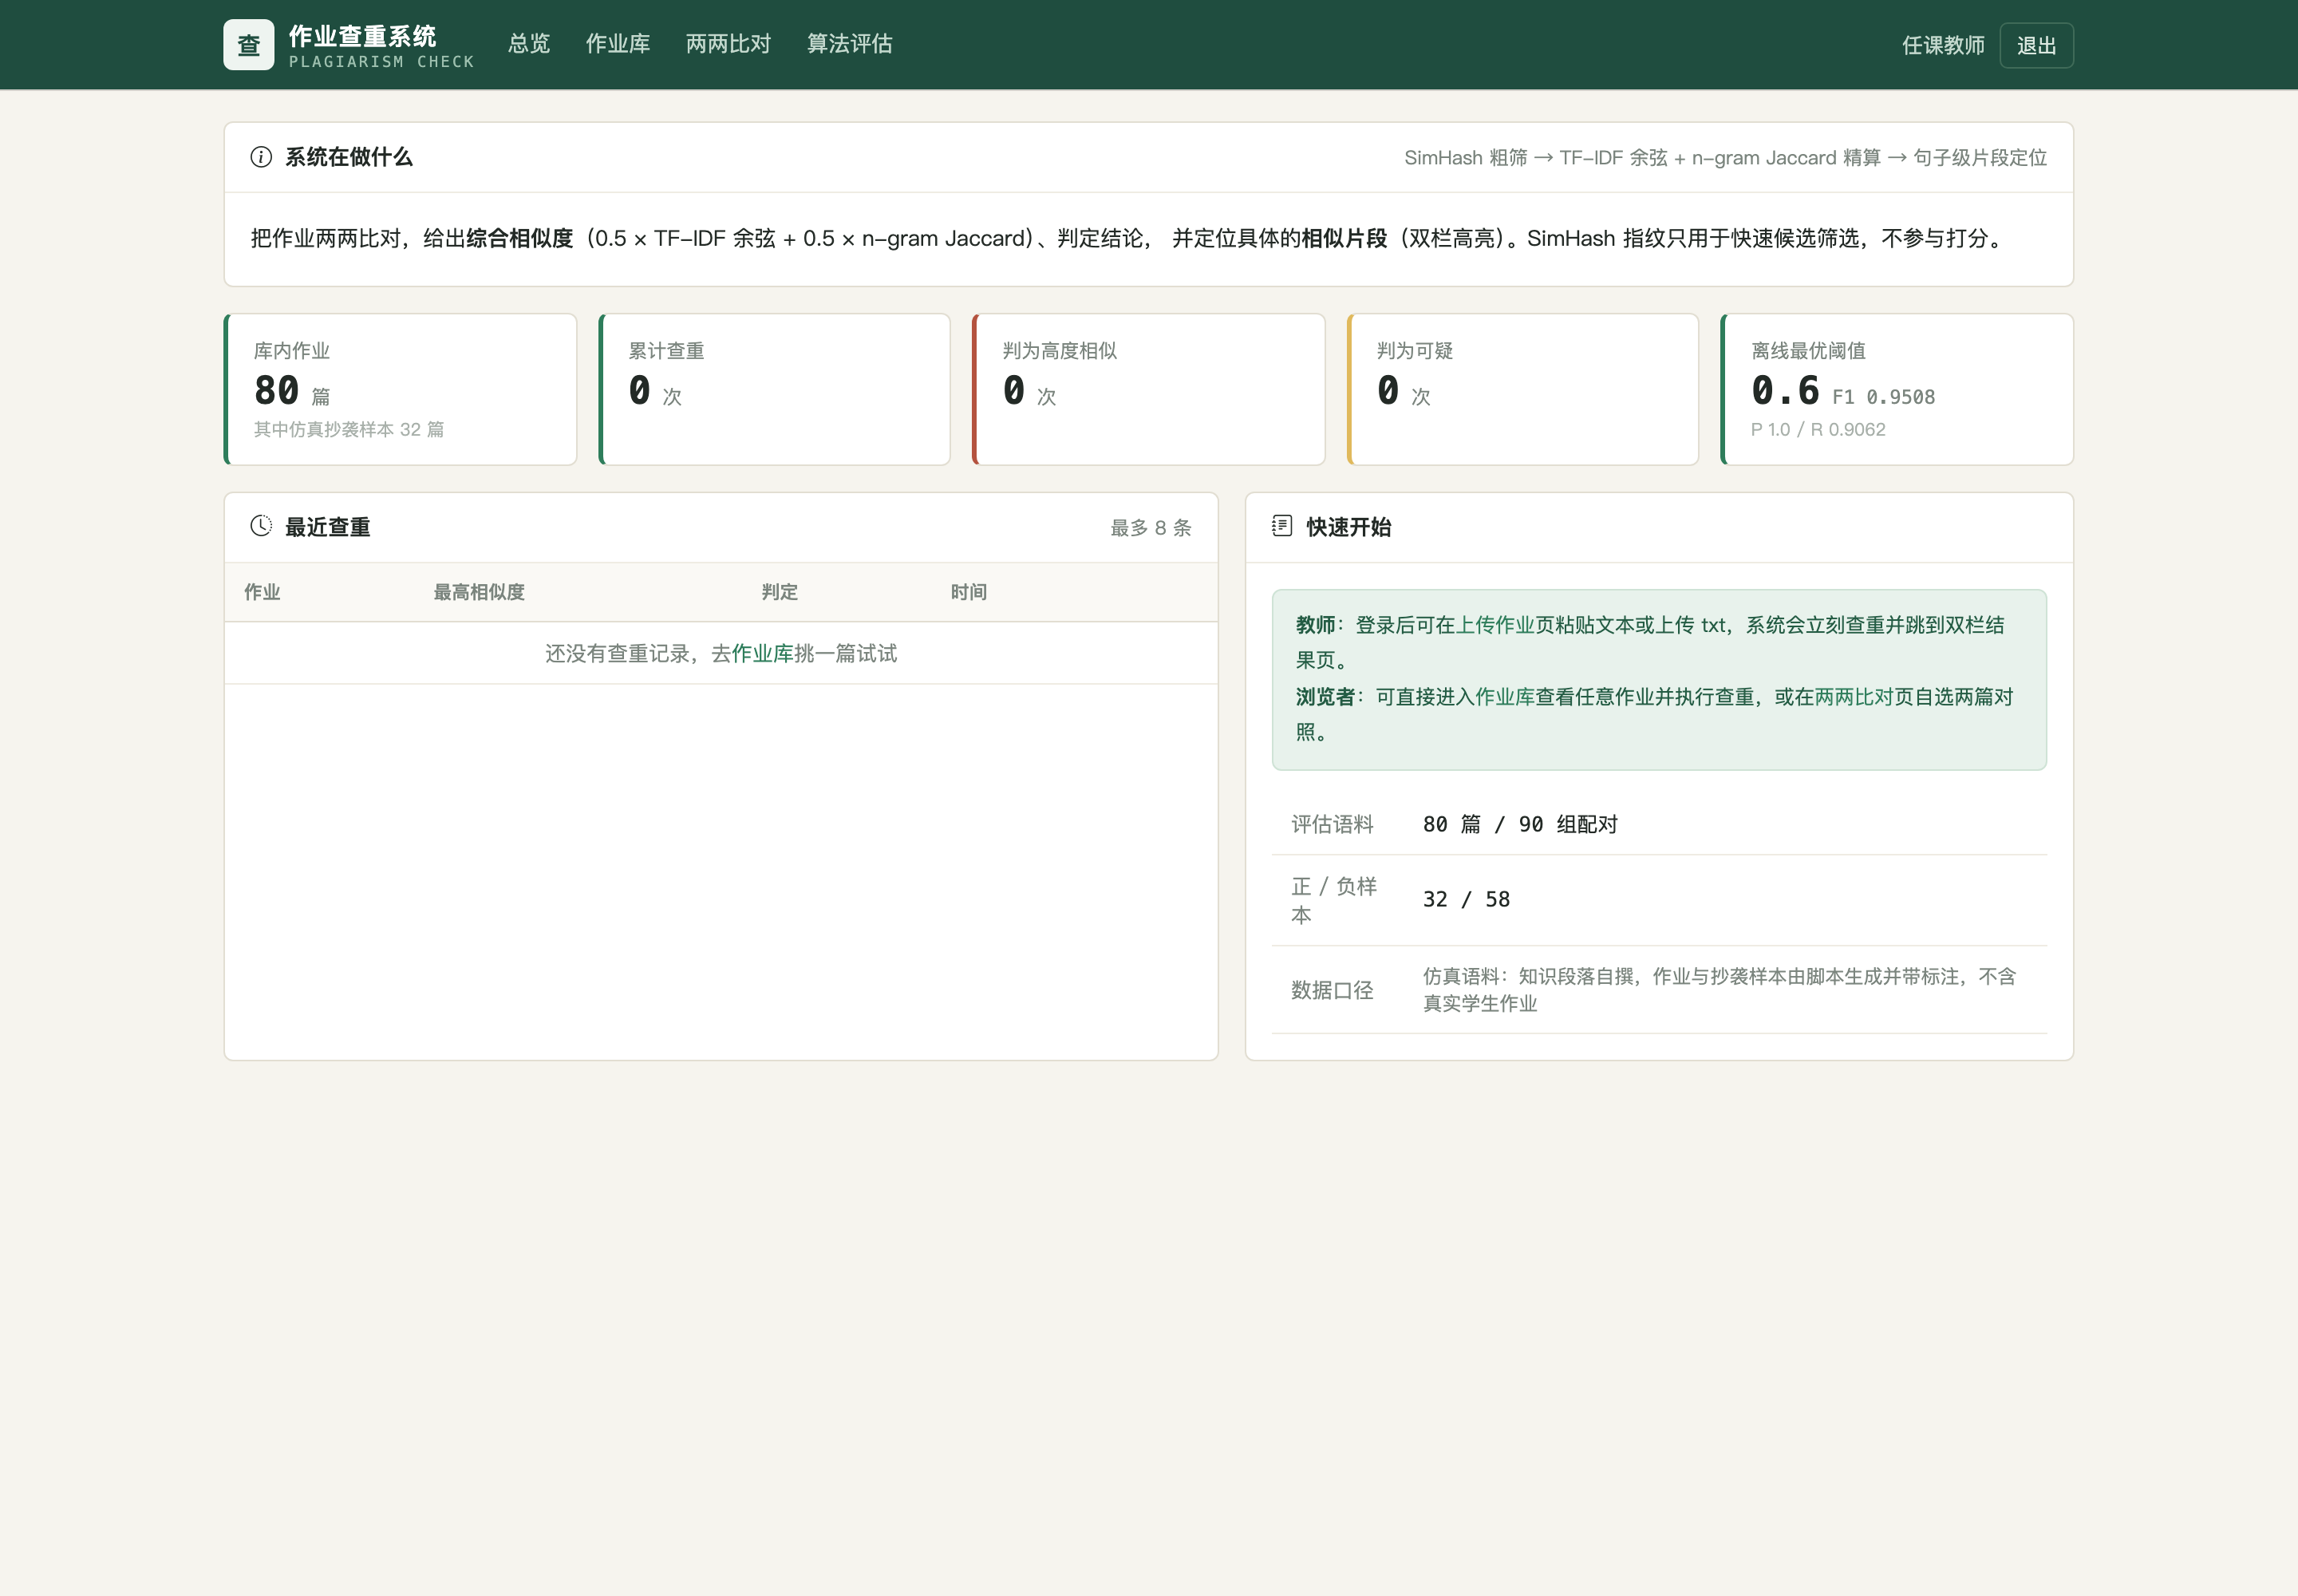
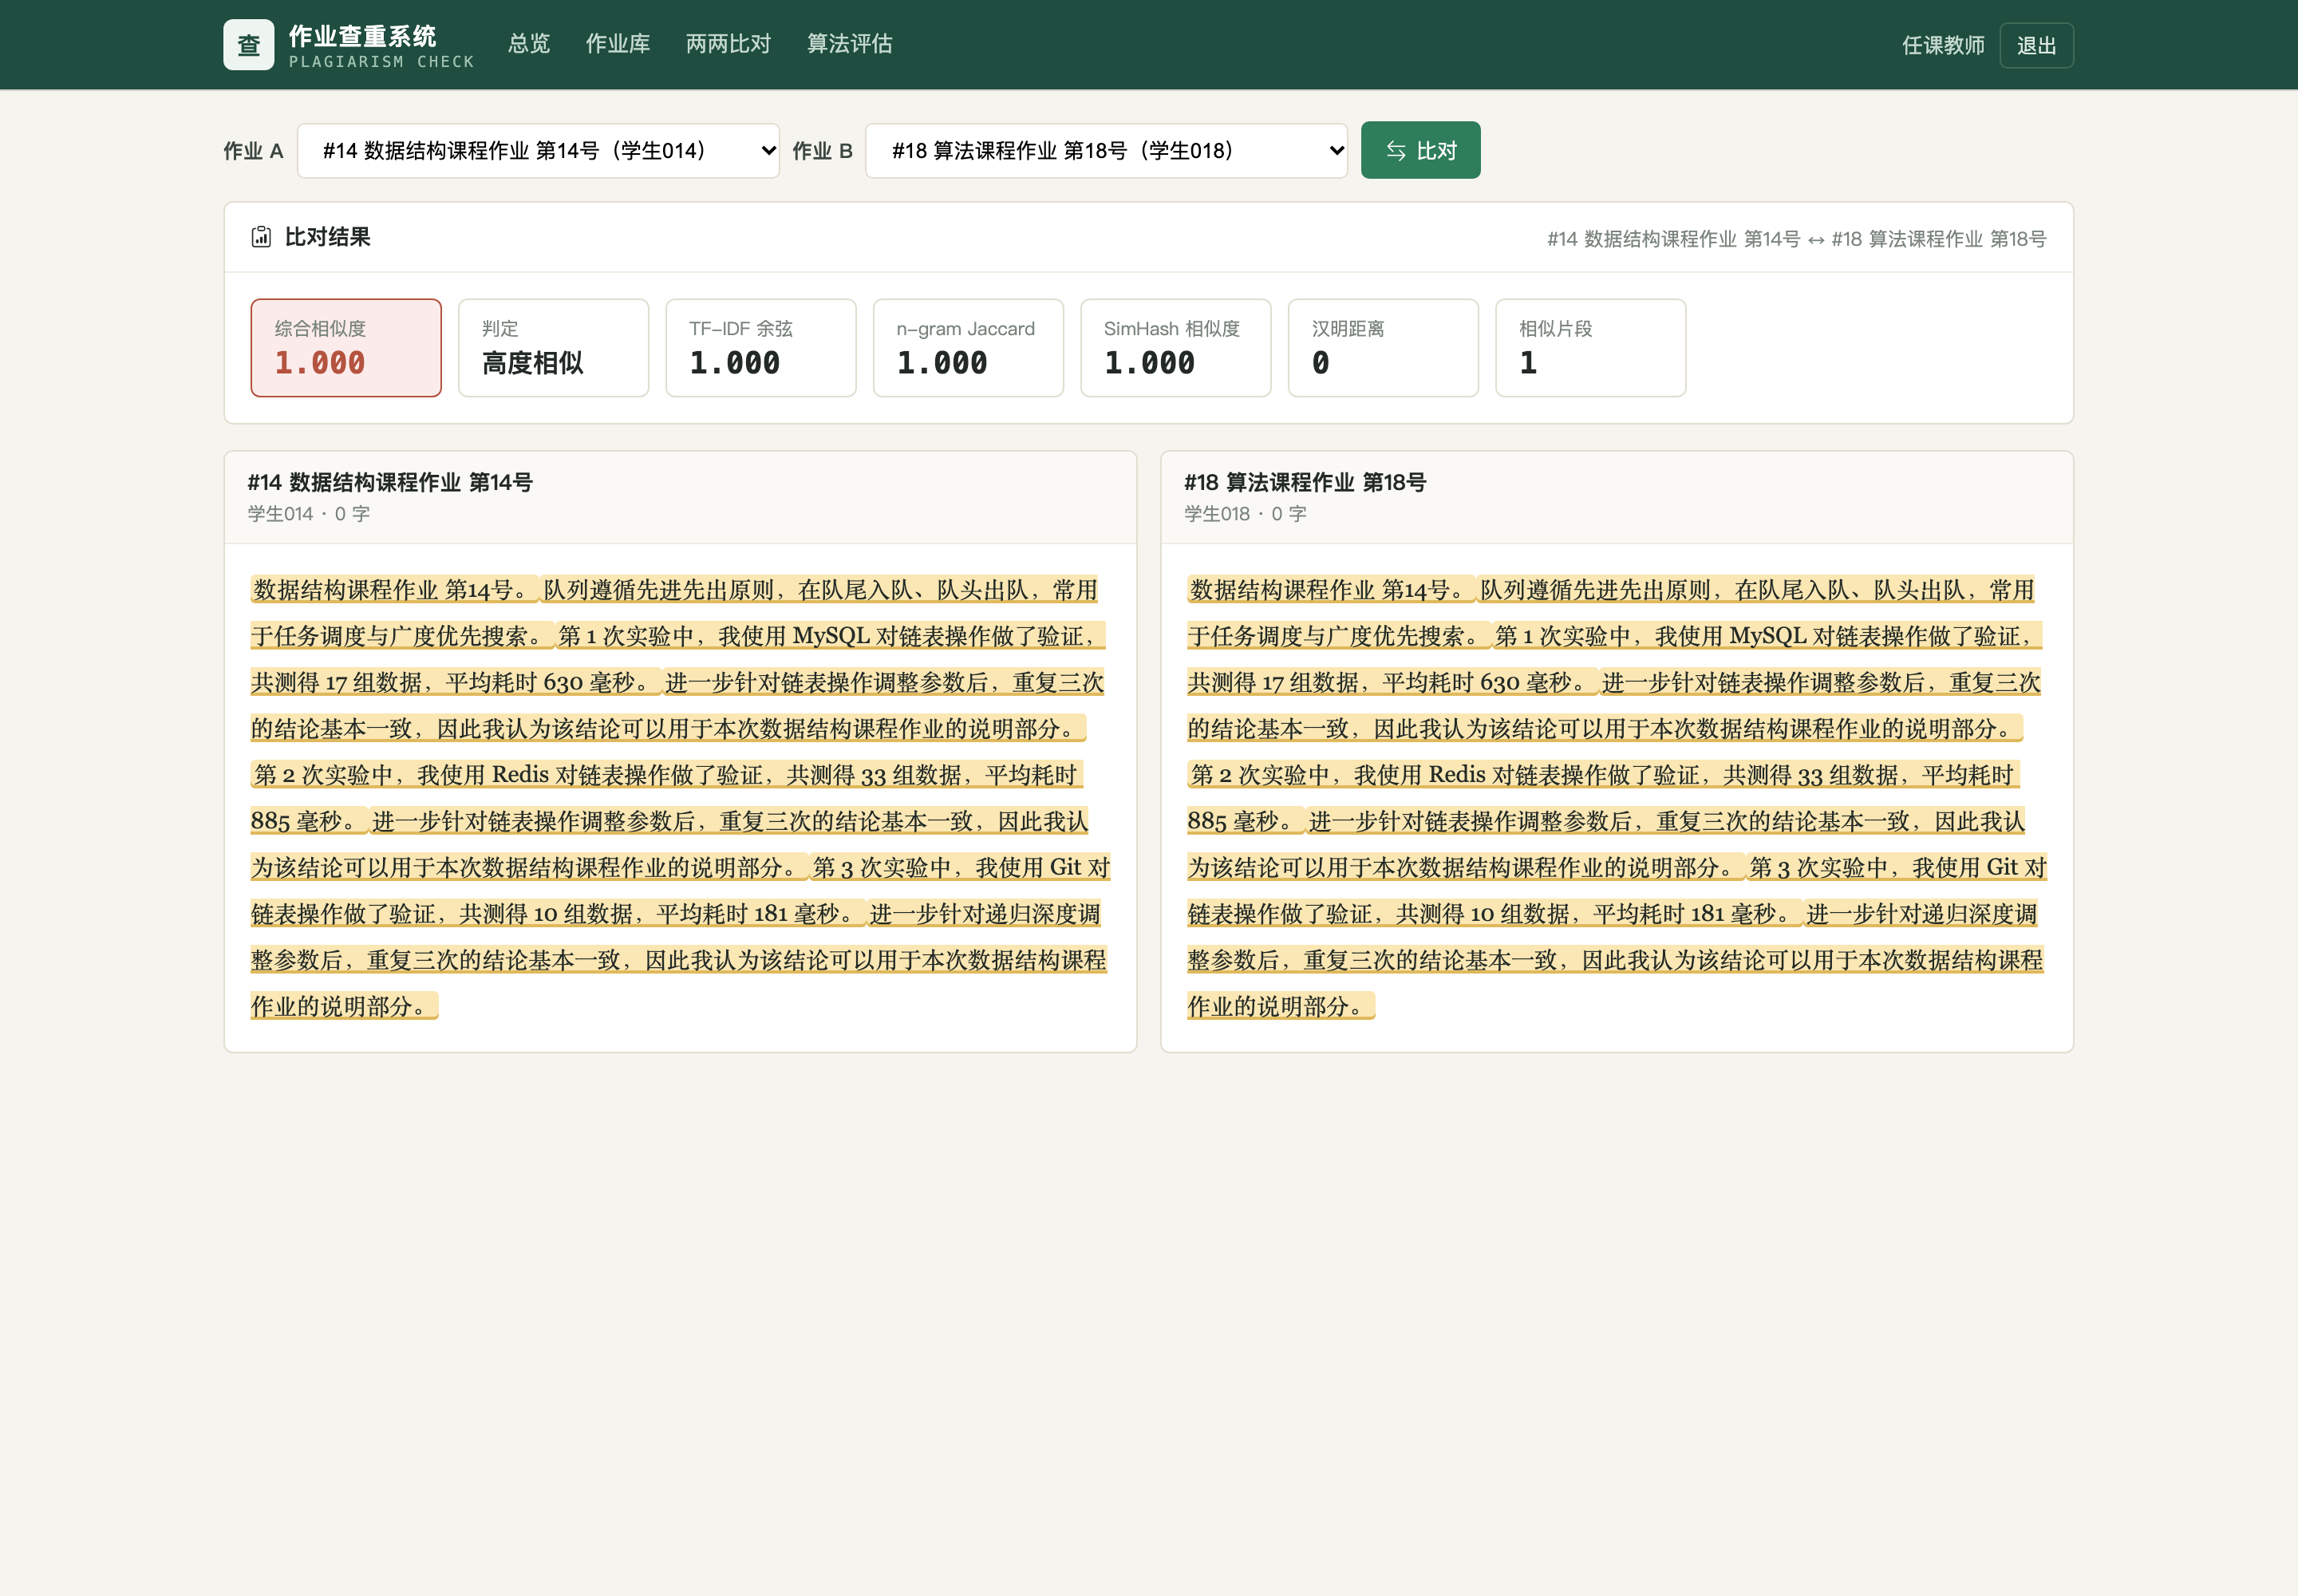
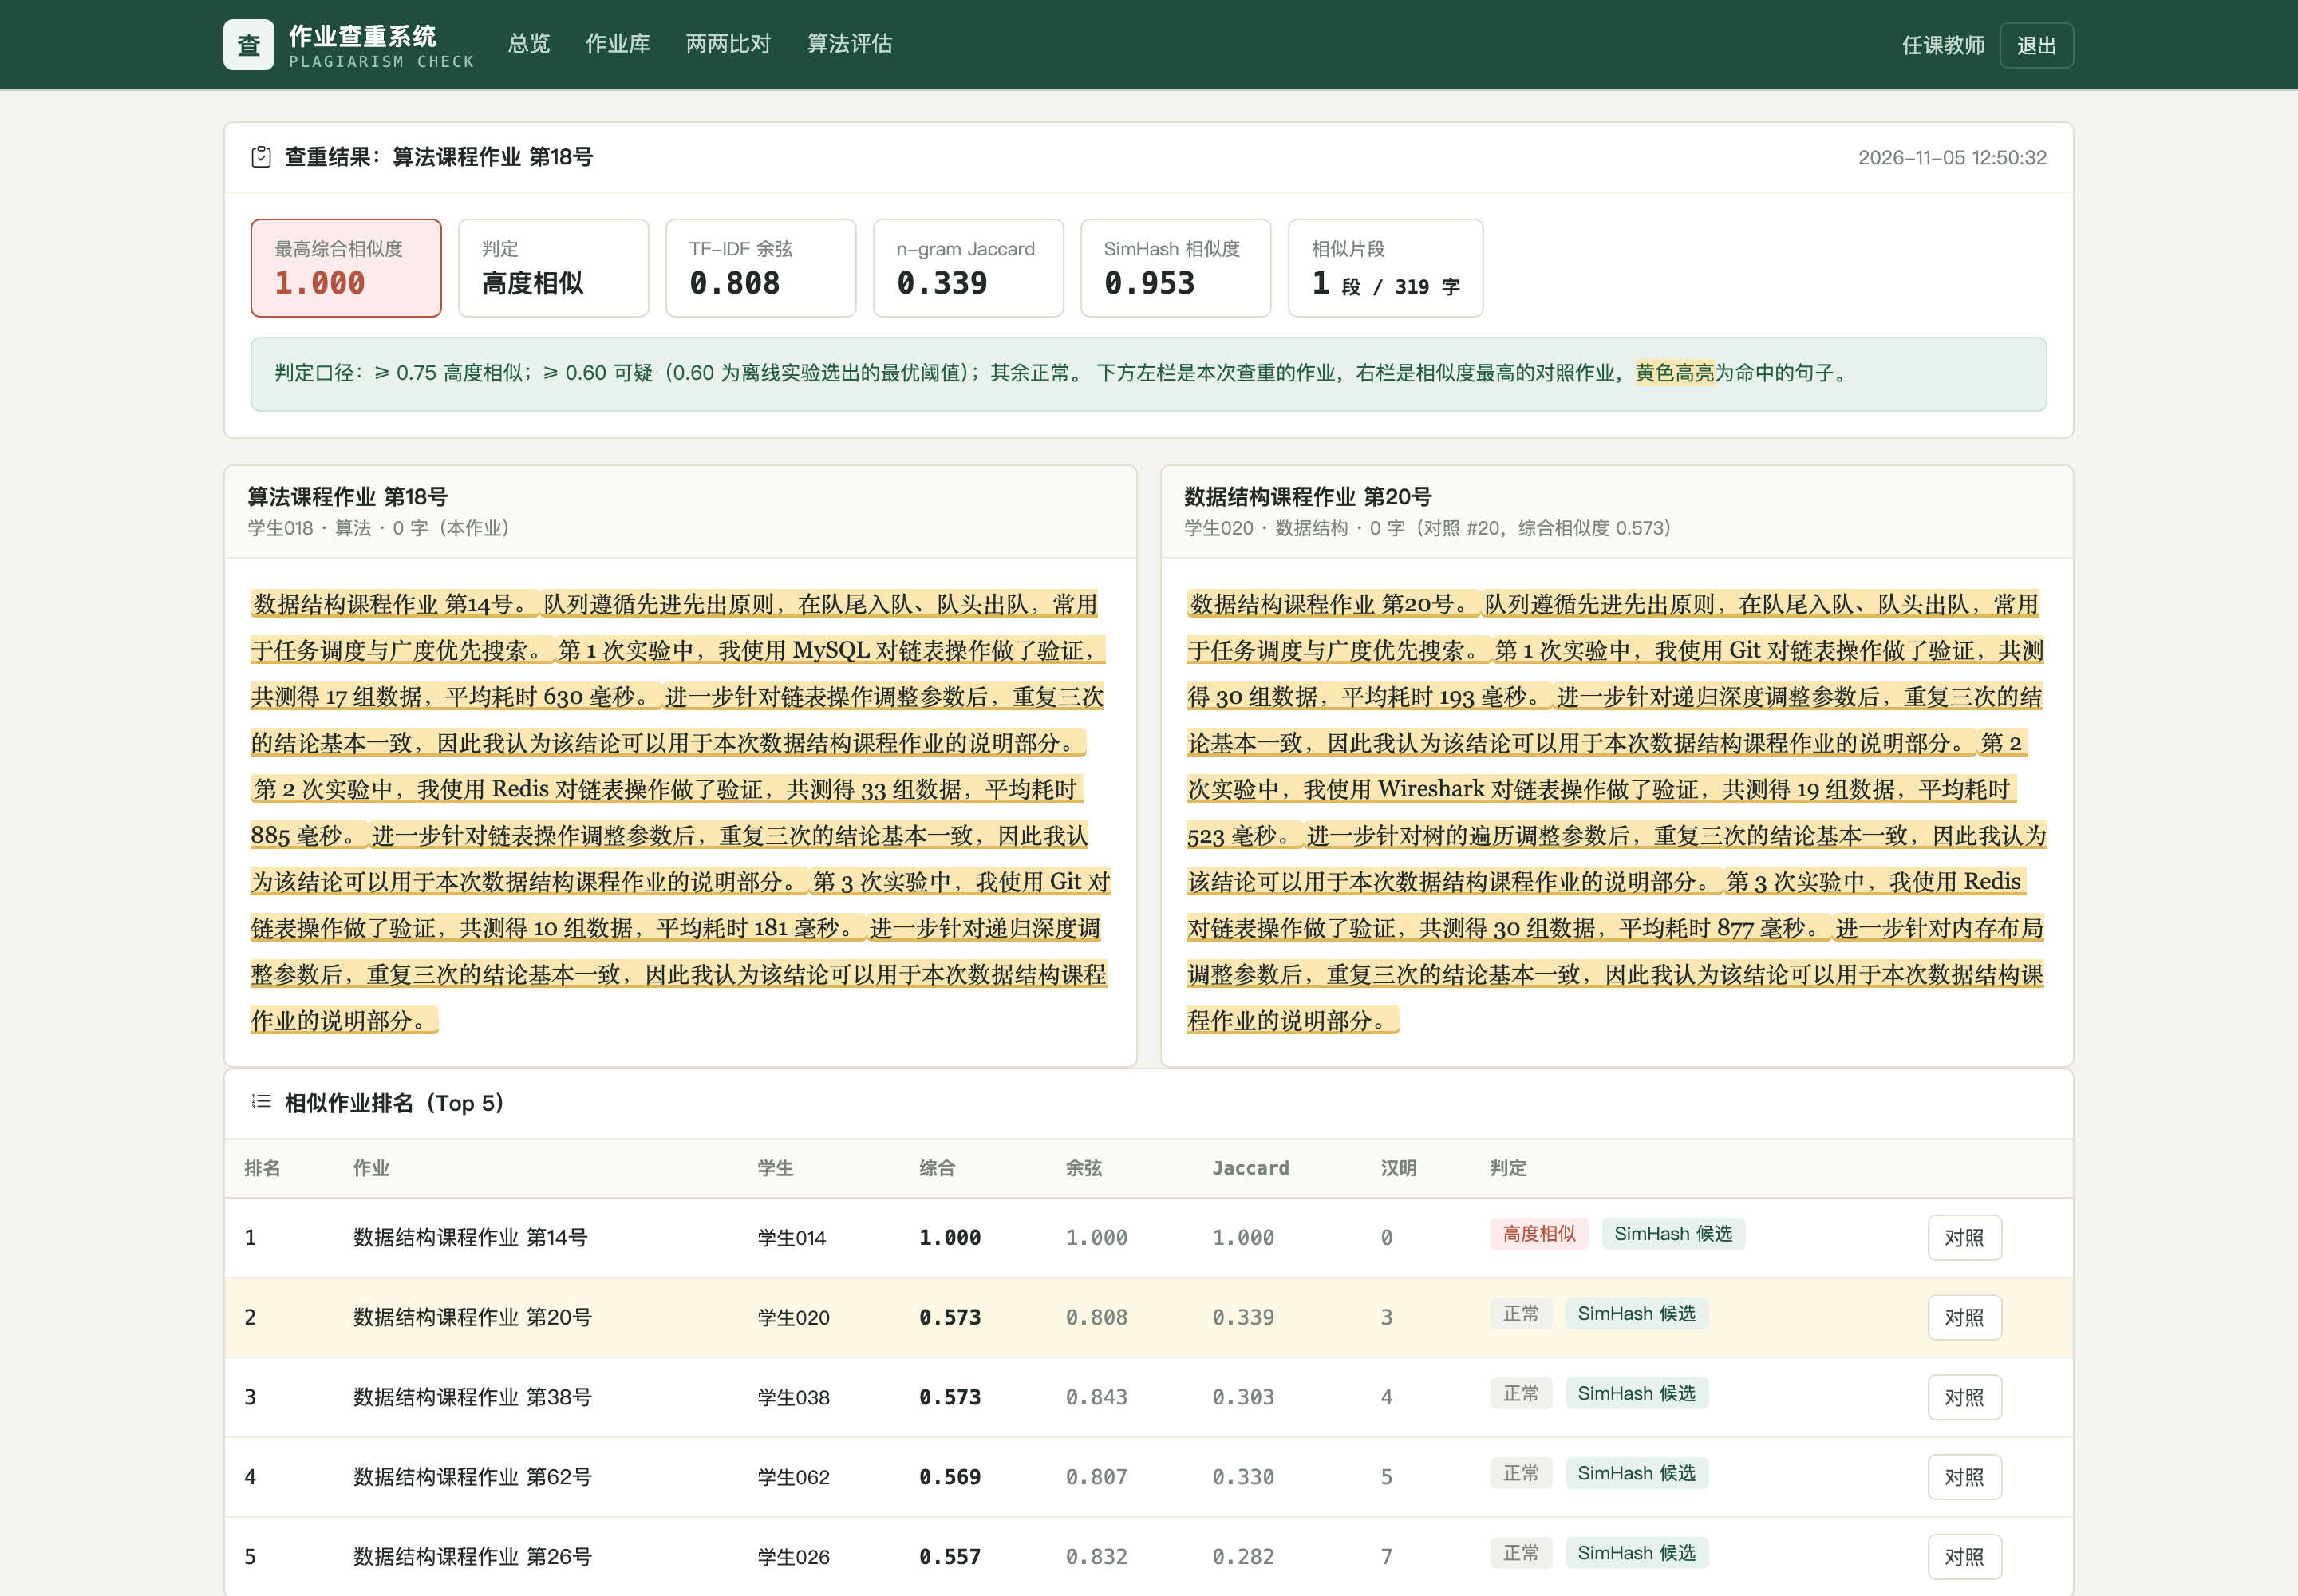
面向教师的学生作业查重与相似度检测系统:上传作业后与库内所有作业比对,给出综合相似度(0.5×TF-IDF 余弦 + 0.5×n-gram Jaccard)、判定结论,并定位相似片段(双栏高亮)。技术主线是「算得准、算得快、说得清」:SimHash 粗筛 → 精算 → 句子级片段定位,算法全部自行实现、不依赖第三方查重服务。
演示视频
视频也可在 B 站视频页 观看
运行环境
| 编程语言 | Python 3.8 及以上 |
|---|---|
| 后端框架 | Django 4.2 |
| 文本处理 | jieba 0.42(分词) |
| 算法 | NumPy 手写:n-gram 指纹、SimHash、TF-IDF 余弦、Jaccard、句子对齐(不用第三方查重服务) |
| 数据库 | MySQL 8.0(交付默认 SQLite,免安装) |
| 可视化 | ECharts 5(已内置本地文件,离线可用) |
| 操作系统 | Windows / macOS / Linux |
| 启动方式 | 双击一键脚本,或 python manage.py runserver 8081 |
功能模块
- 三件武器各司其职:n-gram 指纹(k=4)+Jaccard 度量片段重合,TF-IDF 余弦度量词权分布,SimHash 64 位只做候选粗筛
- 综合相似度 = 0.5×余弦 + 0.5×Jaccard;判定线 0.60 取自离线实验的最优阈值(≥0.75 高度相似 / ≥0.60 可疑)
- 句子级片段定位:逐句字符 3-gram Jaccard 取最佳匹配并合并连续命中句,结果页双栏高亮、悬停显示匹配分数
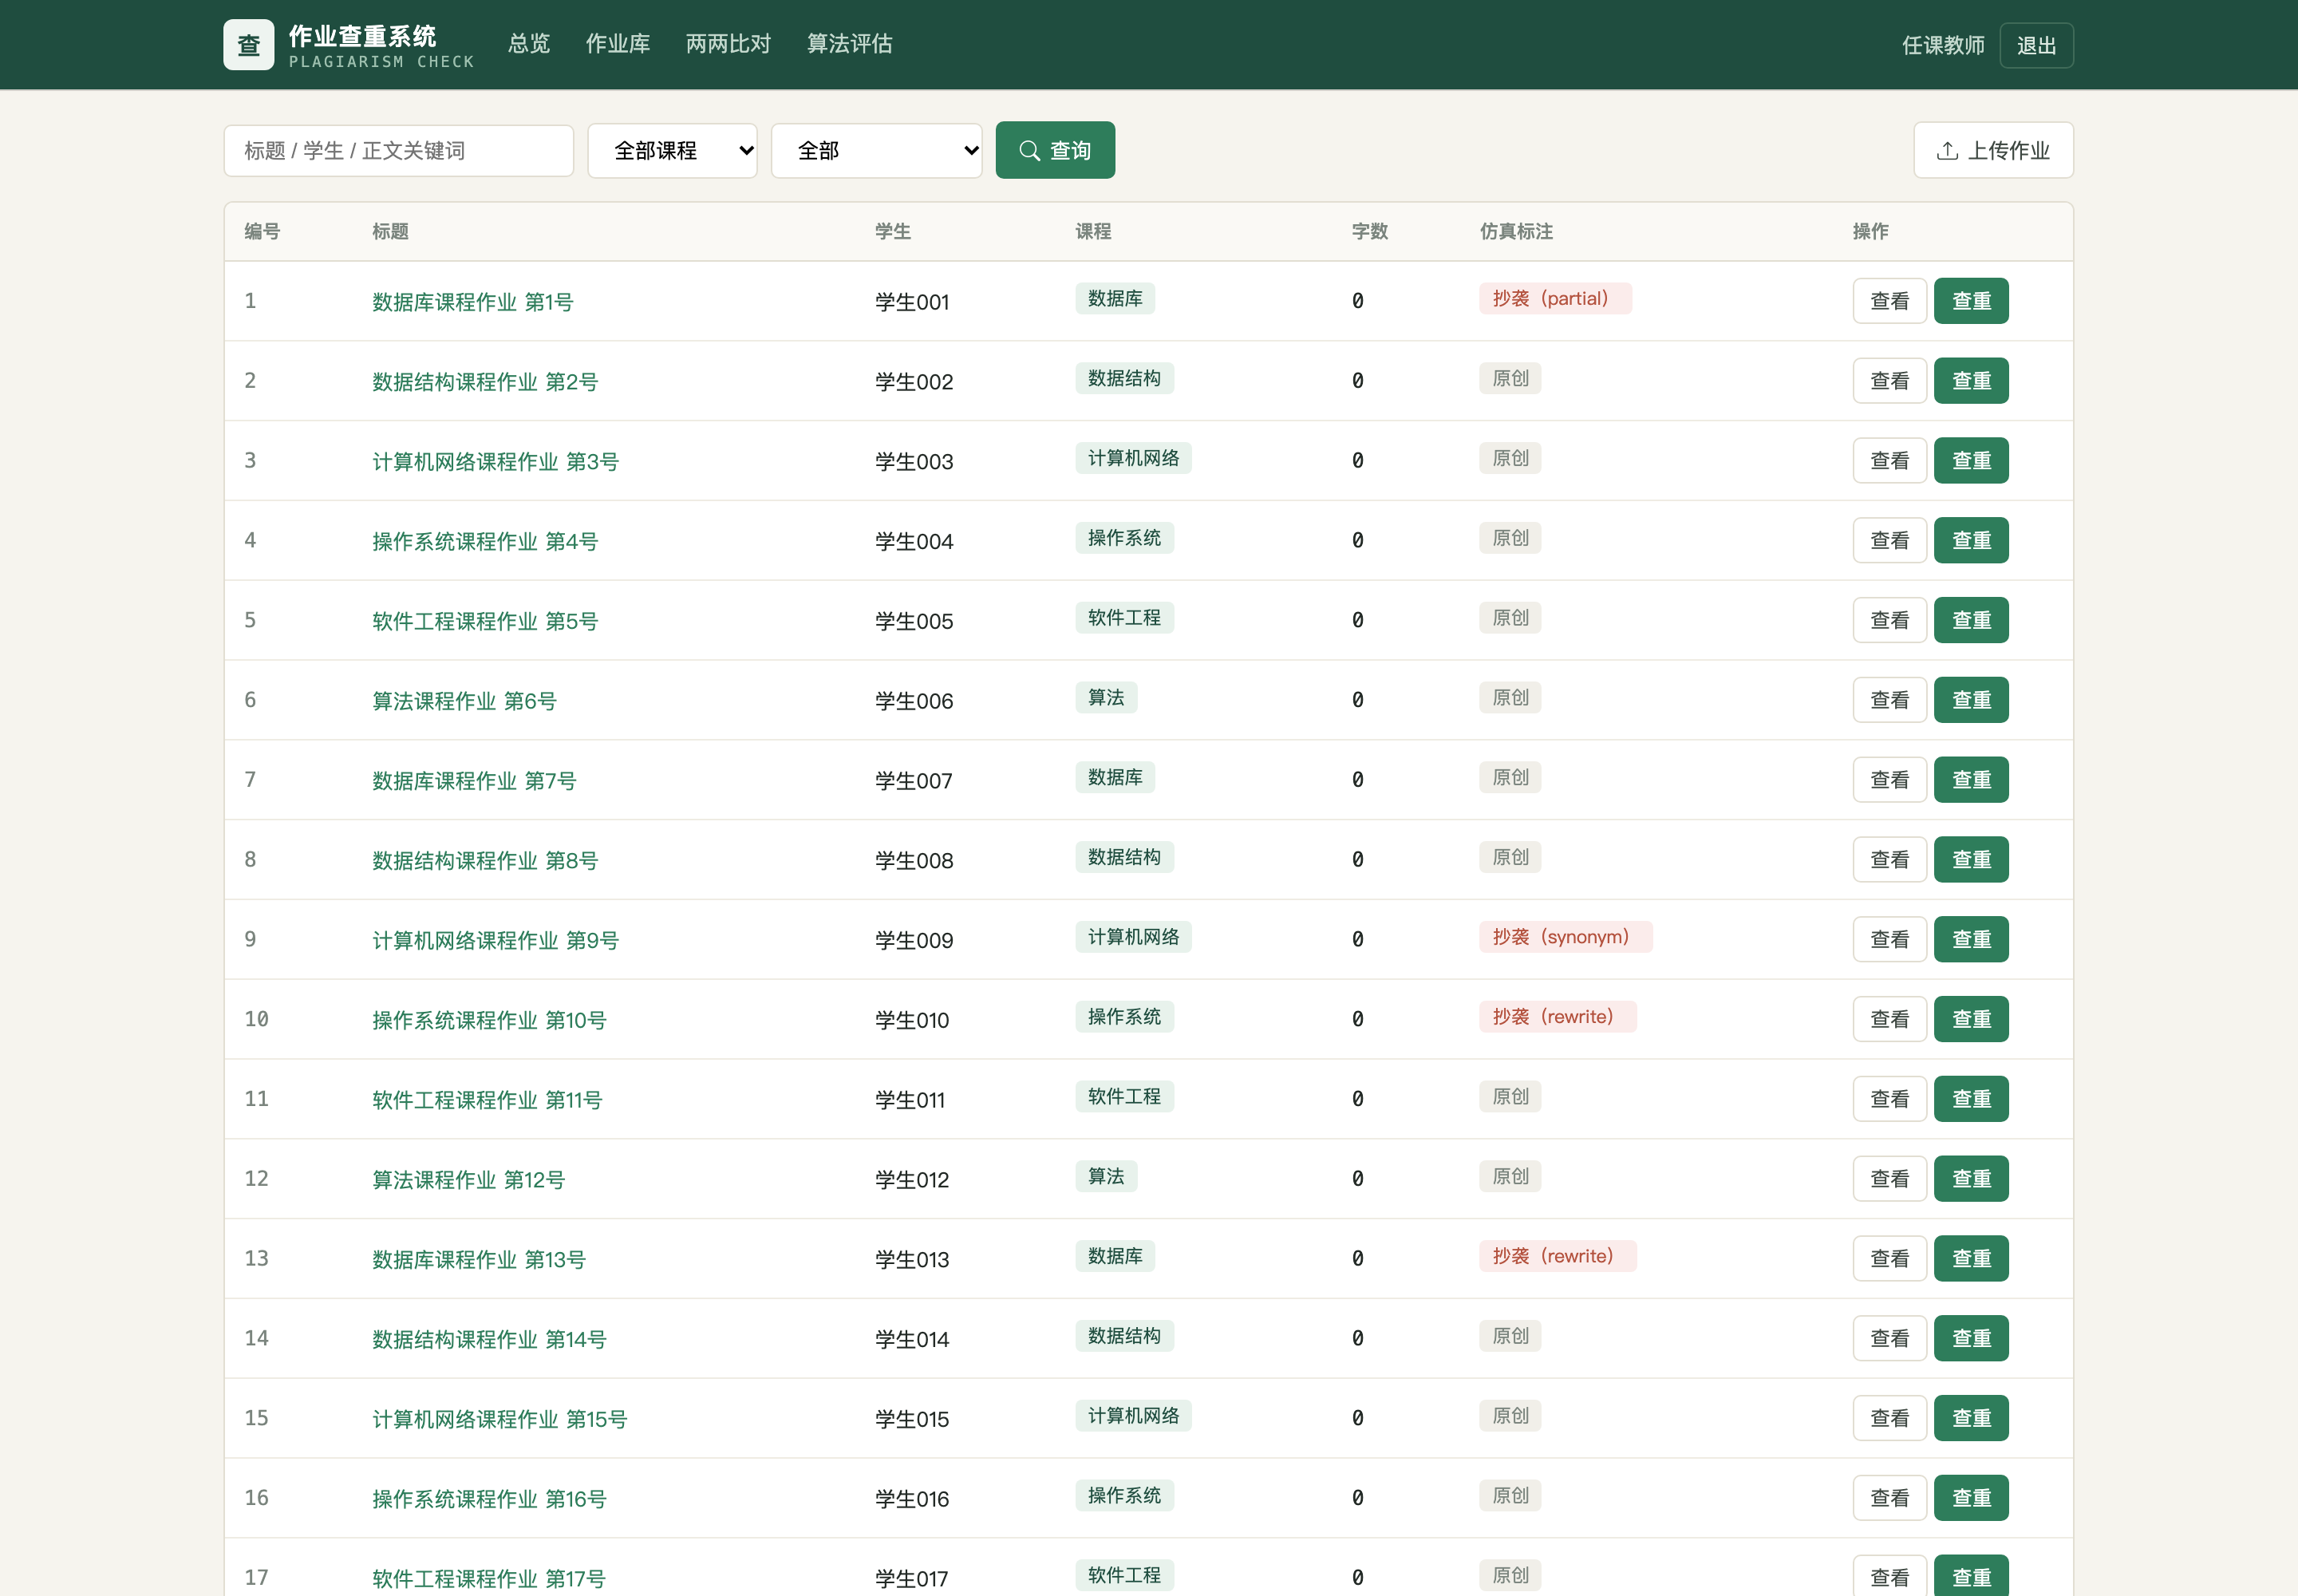
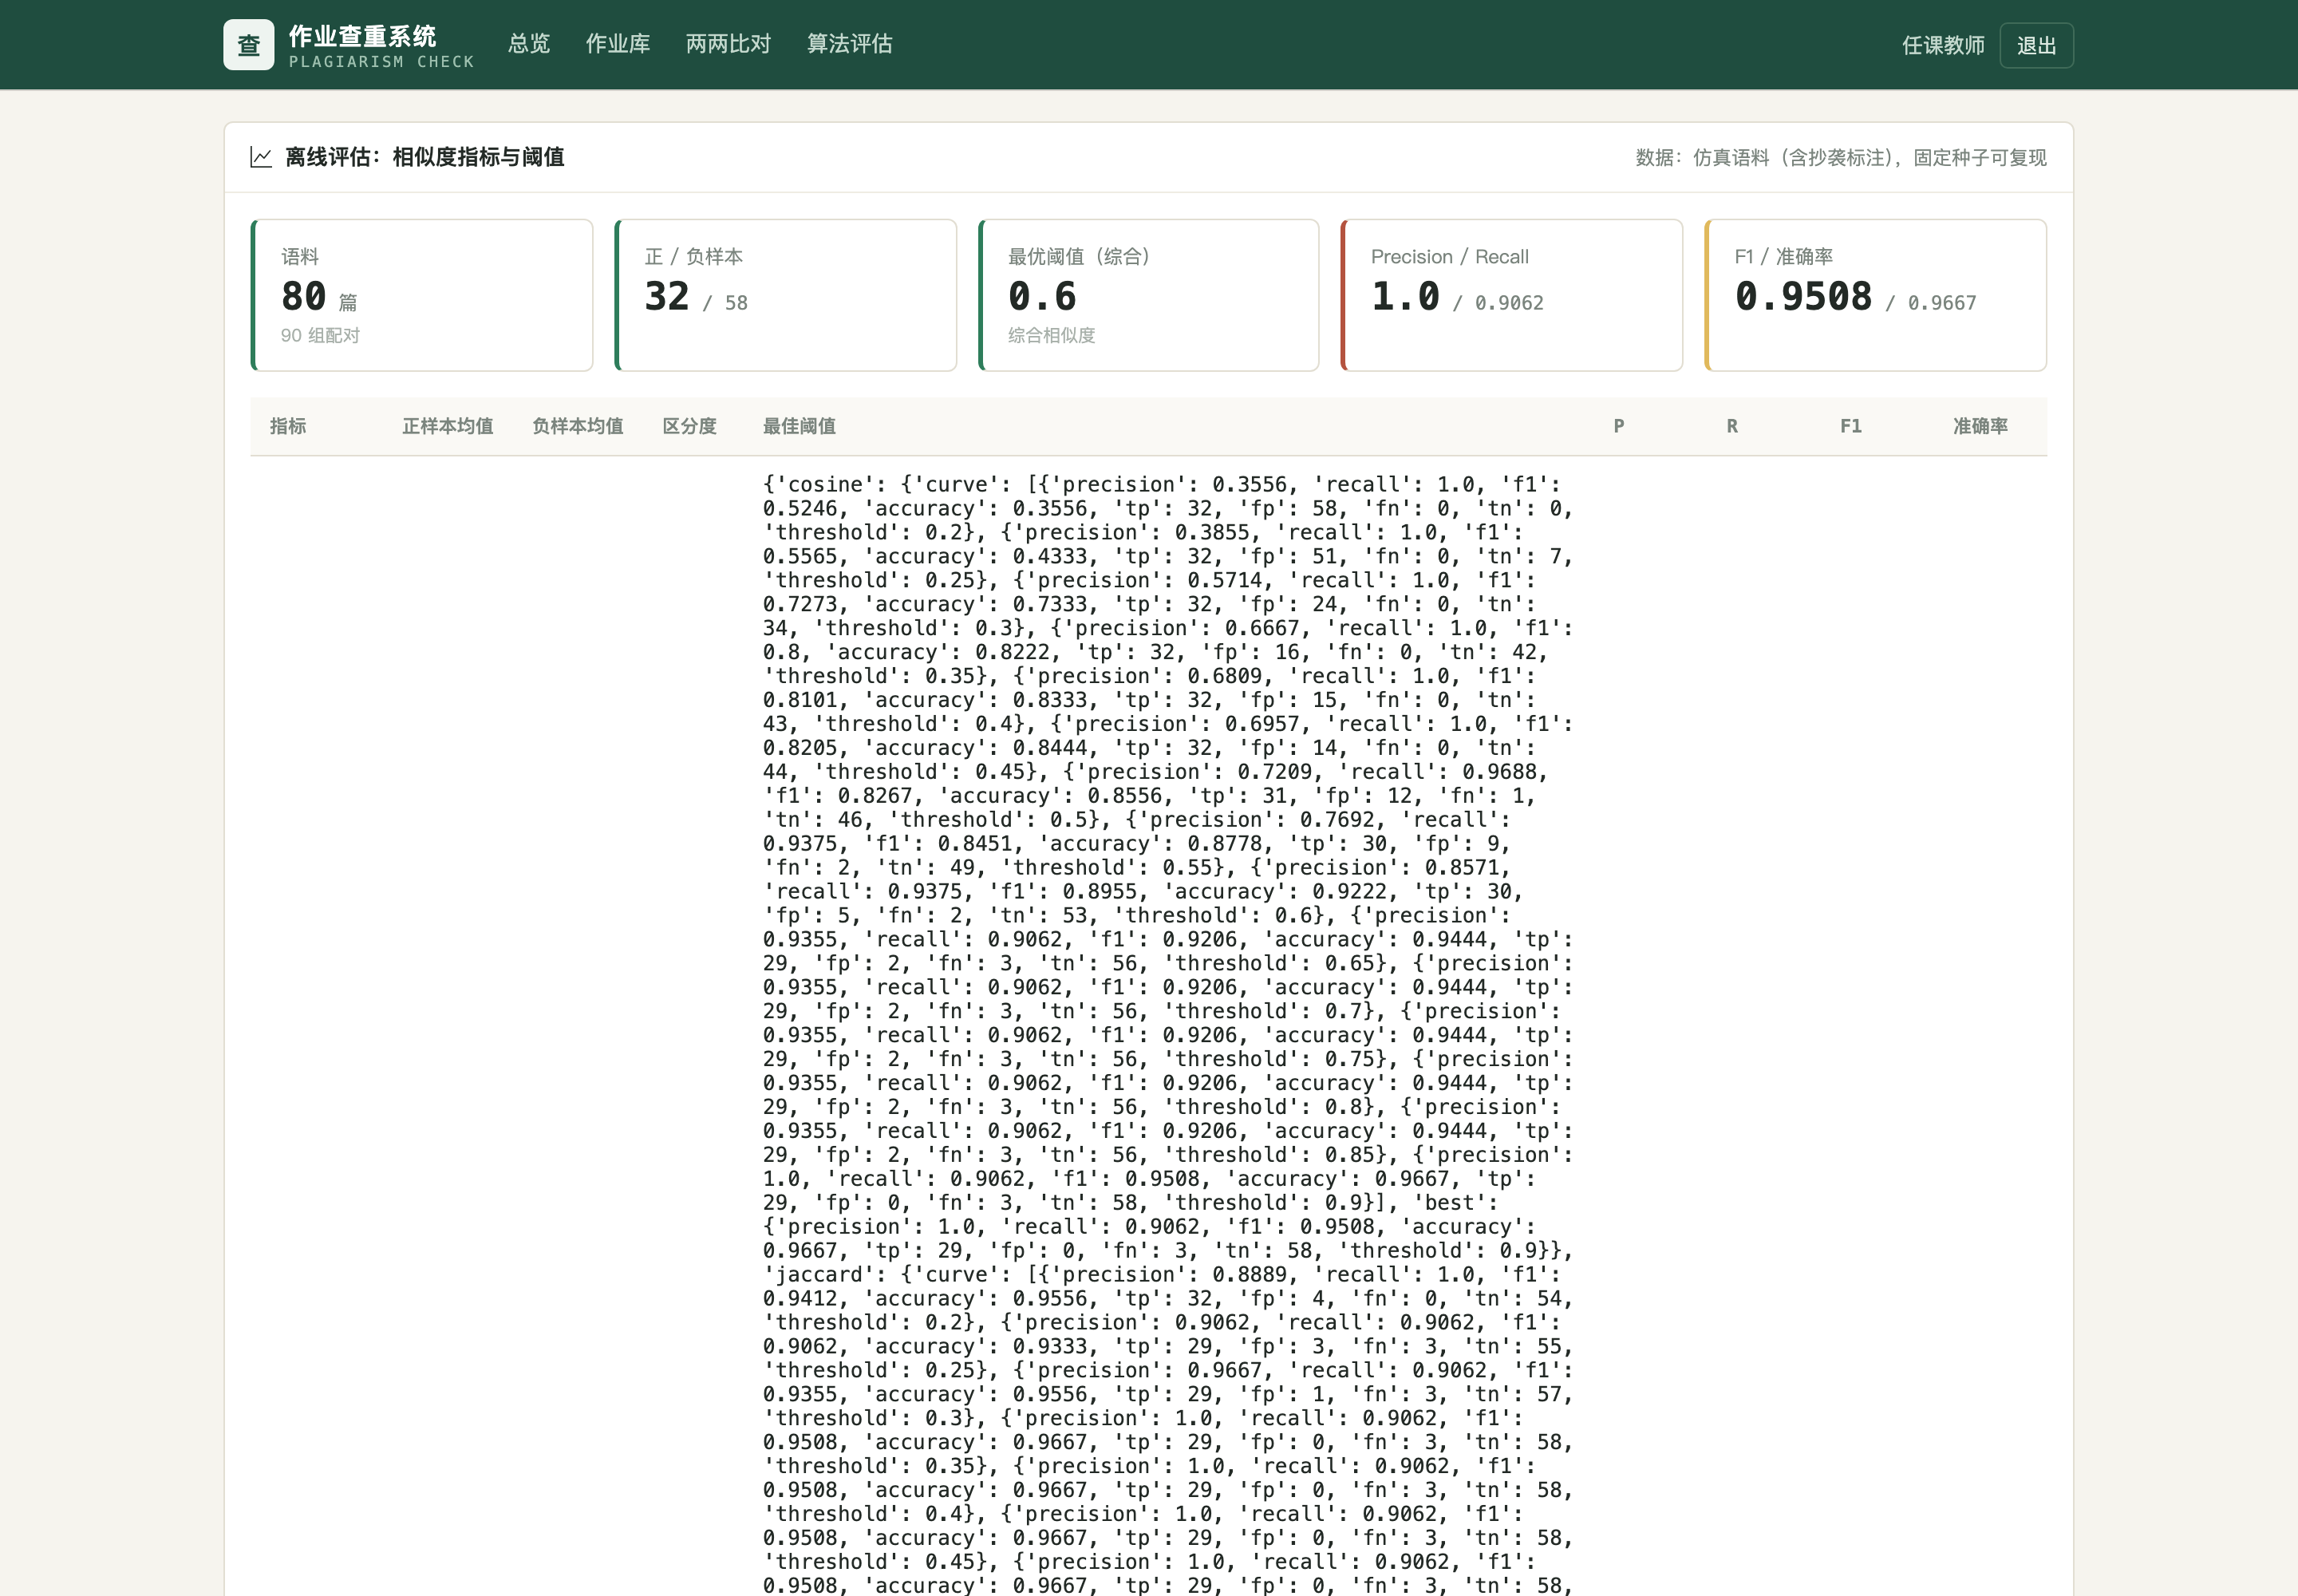
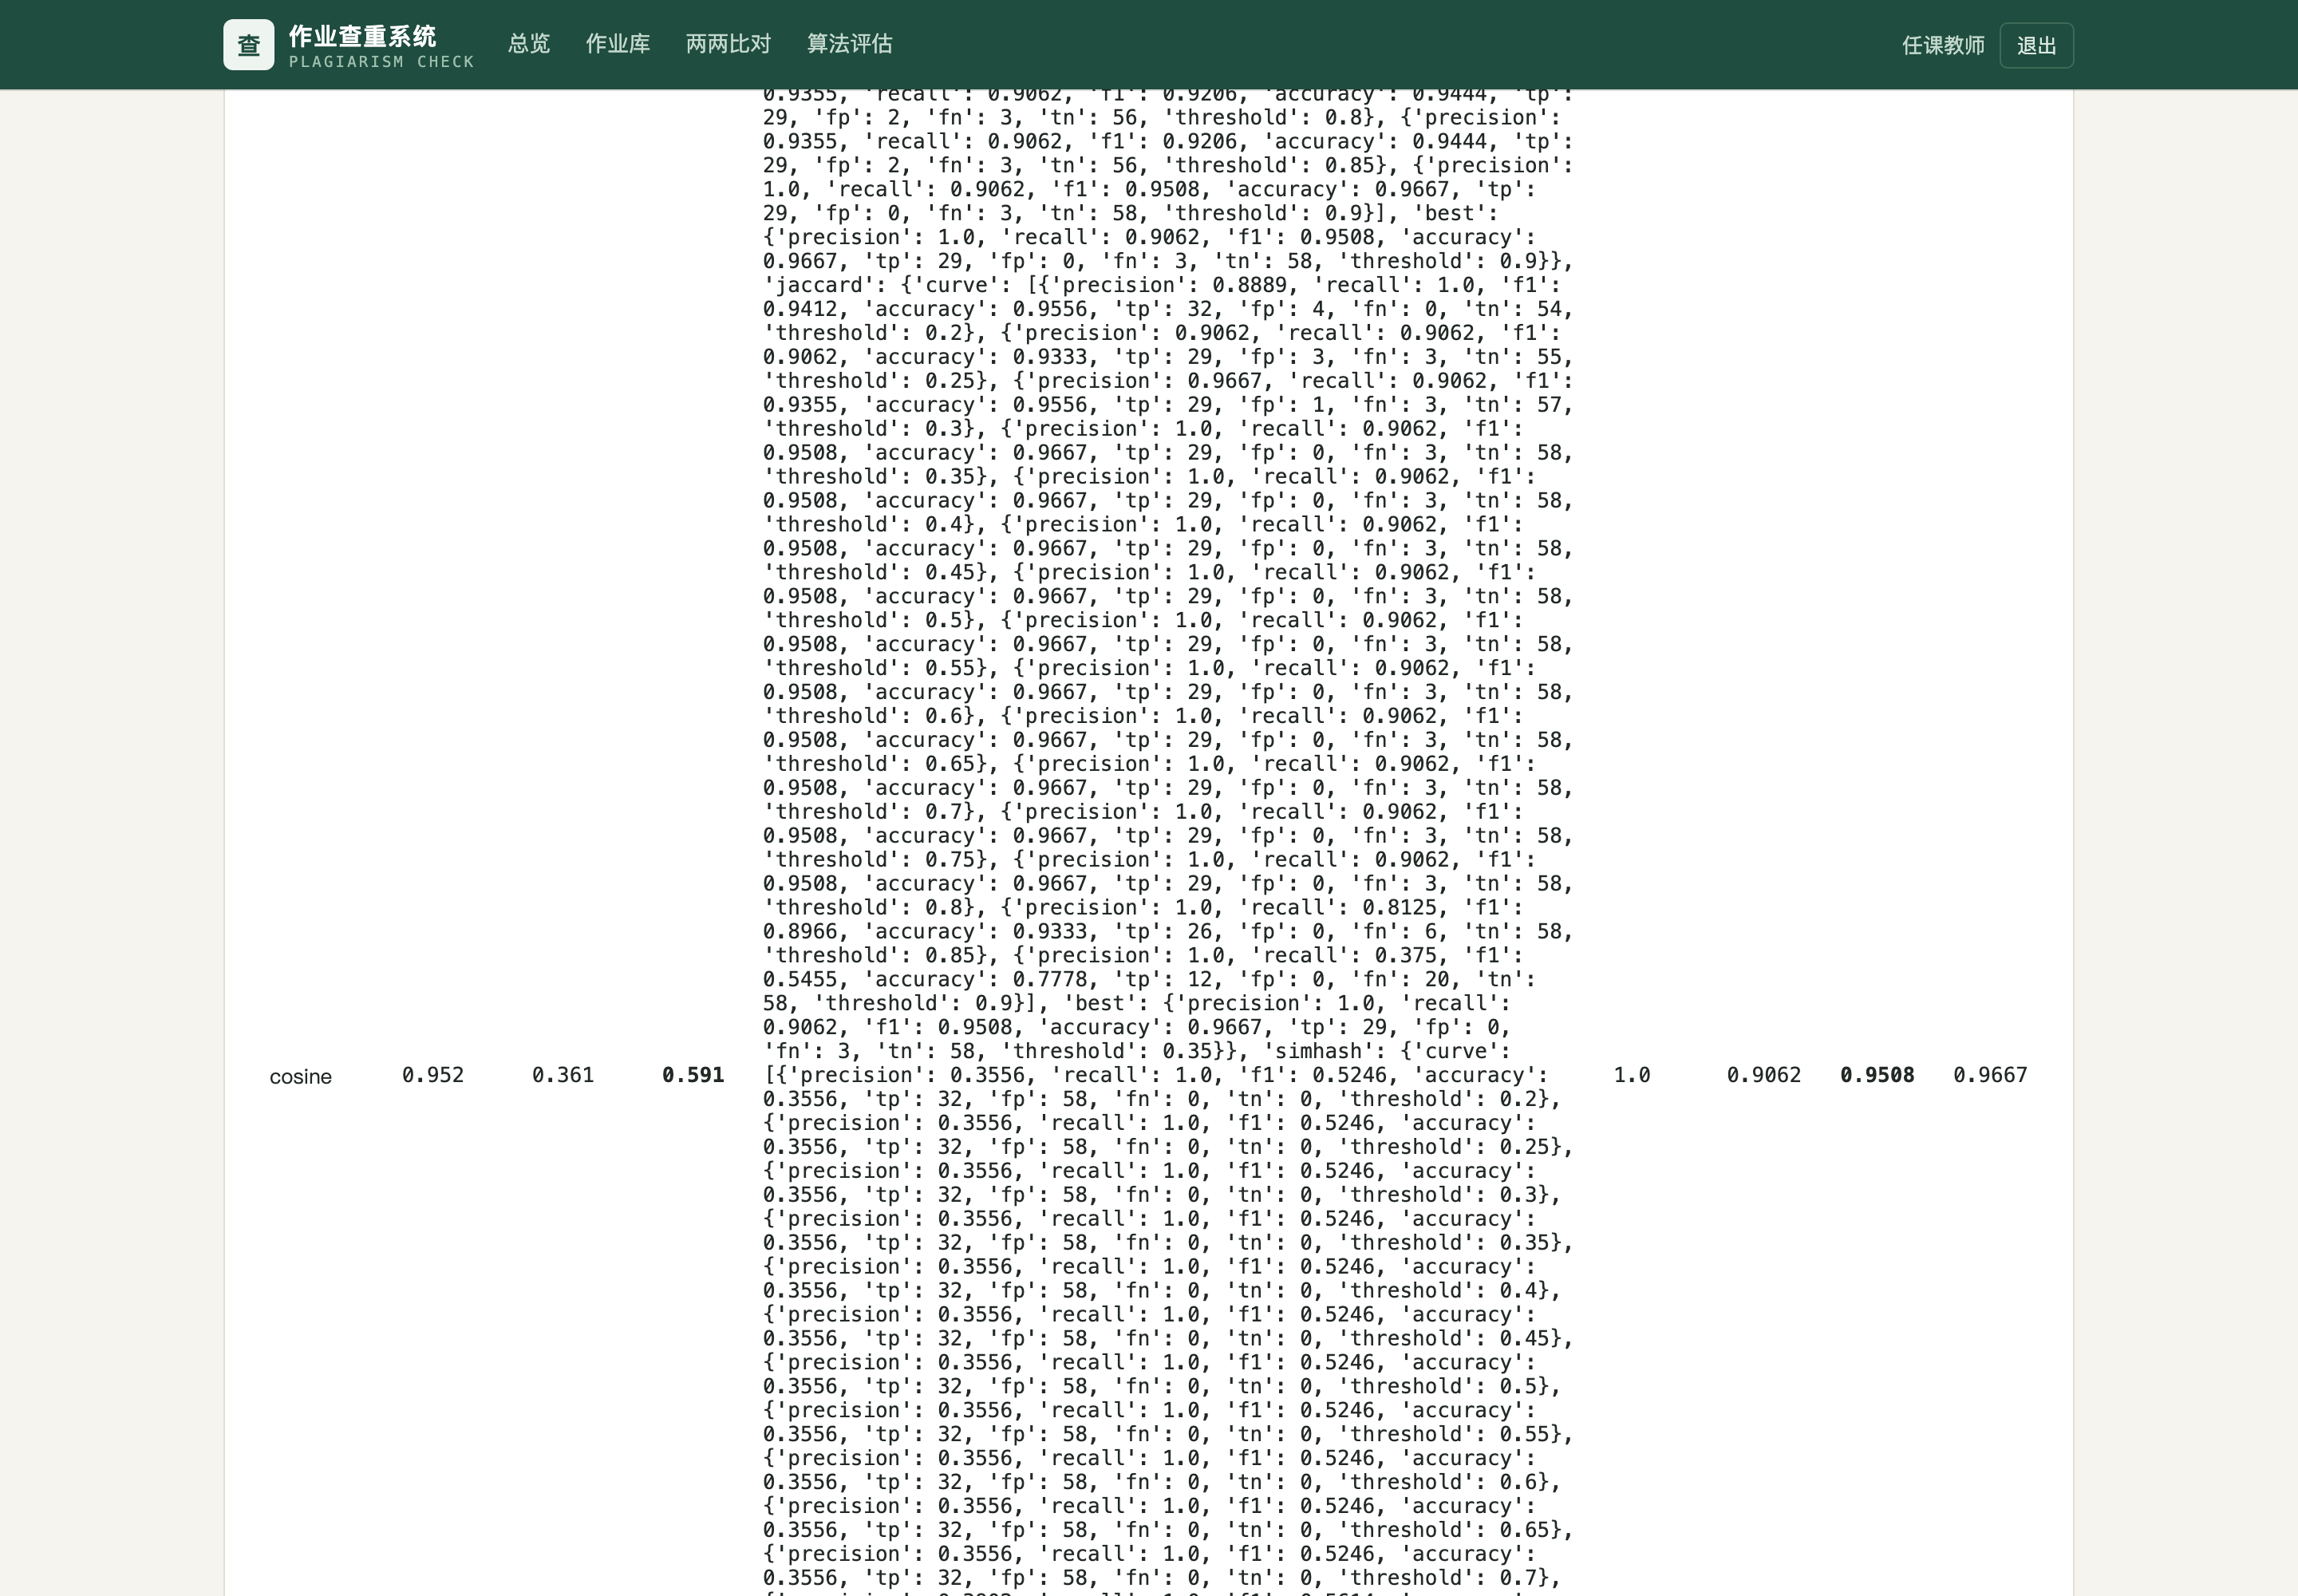
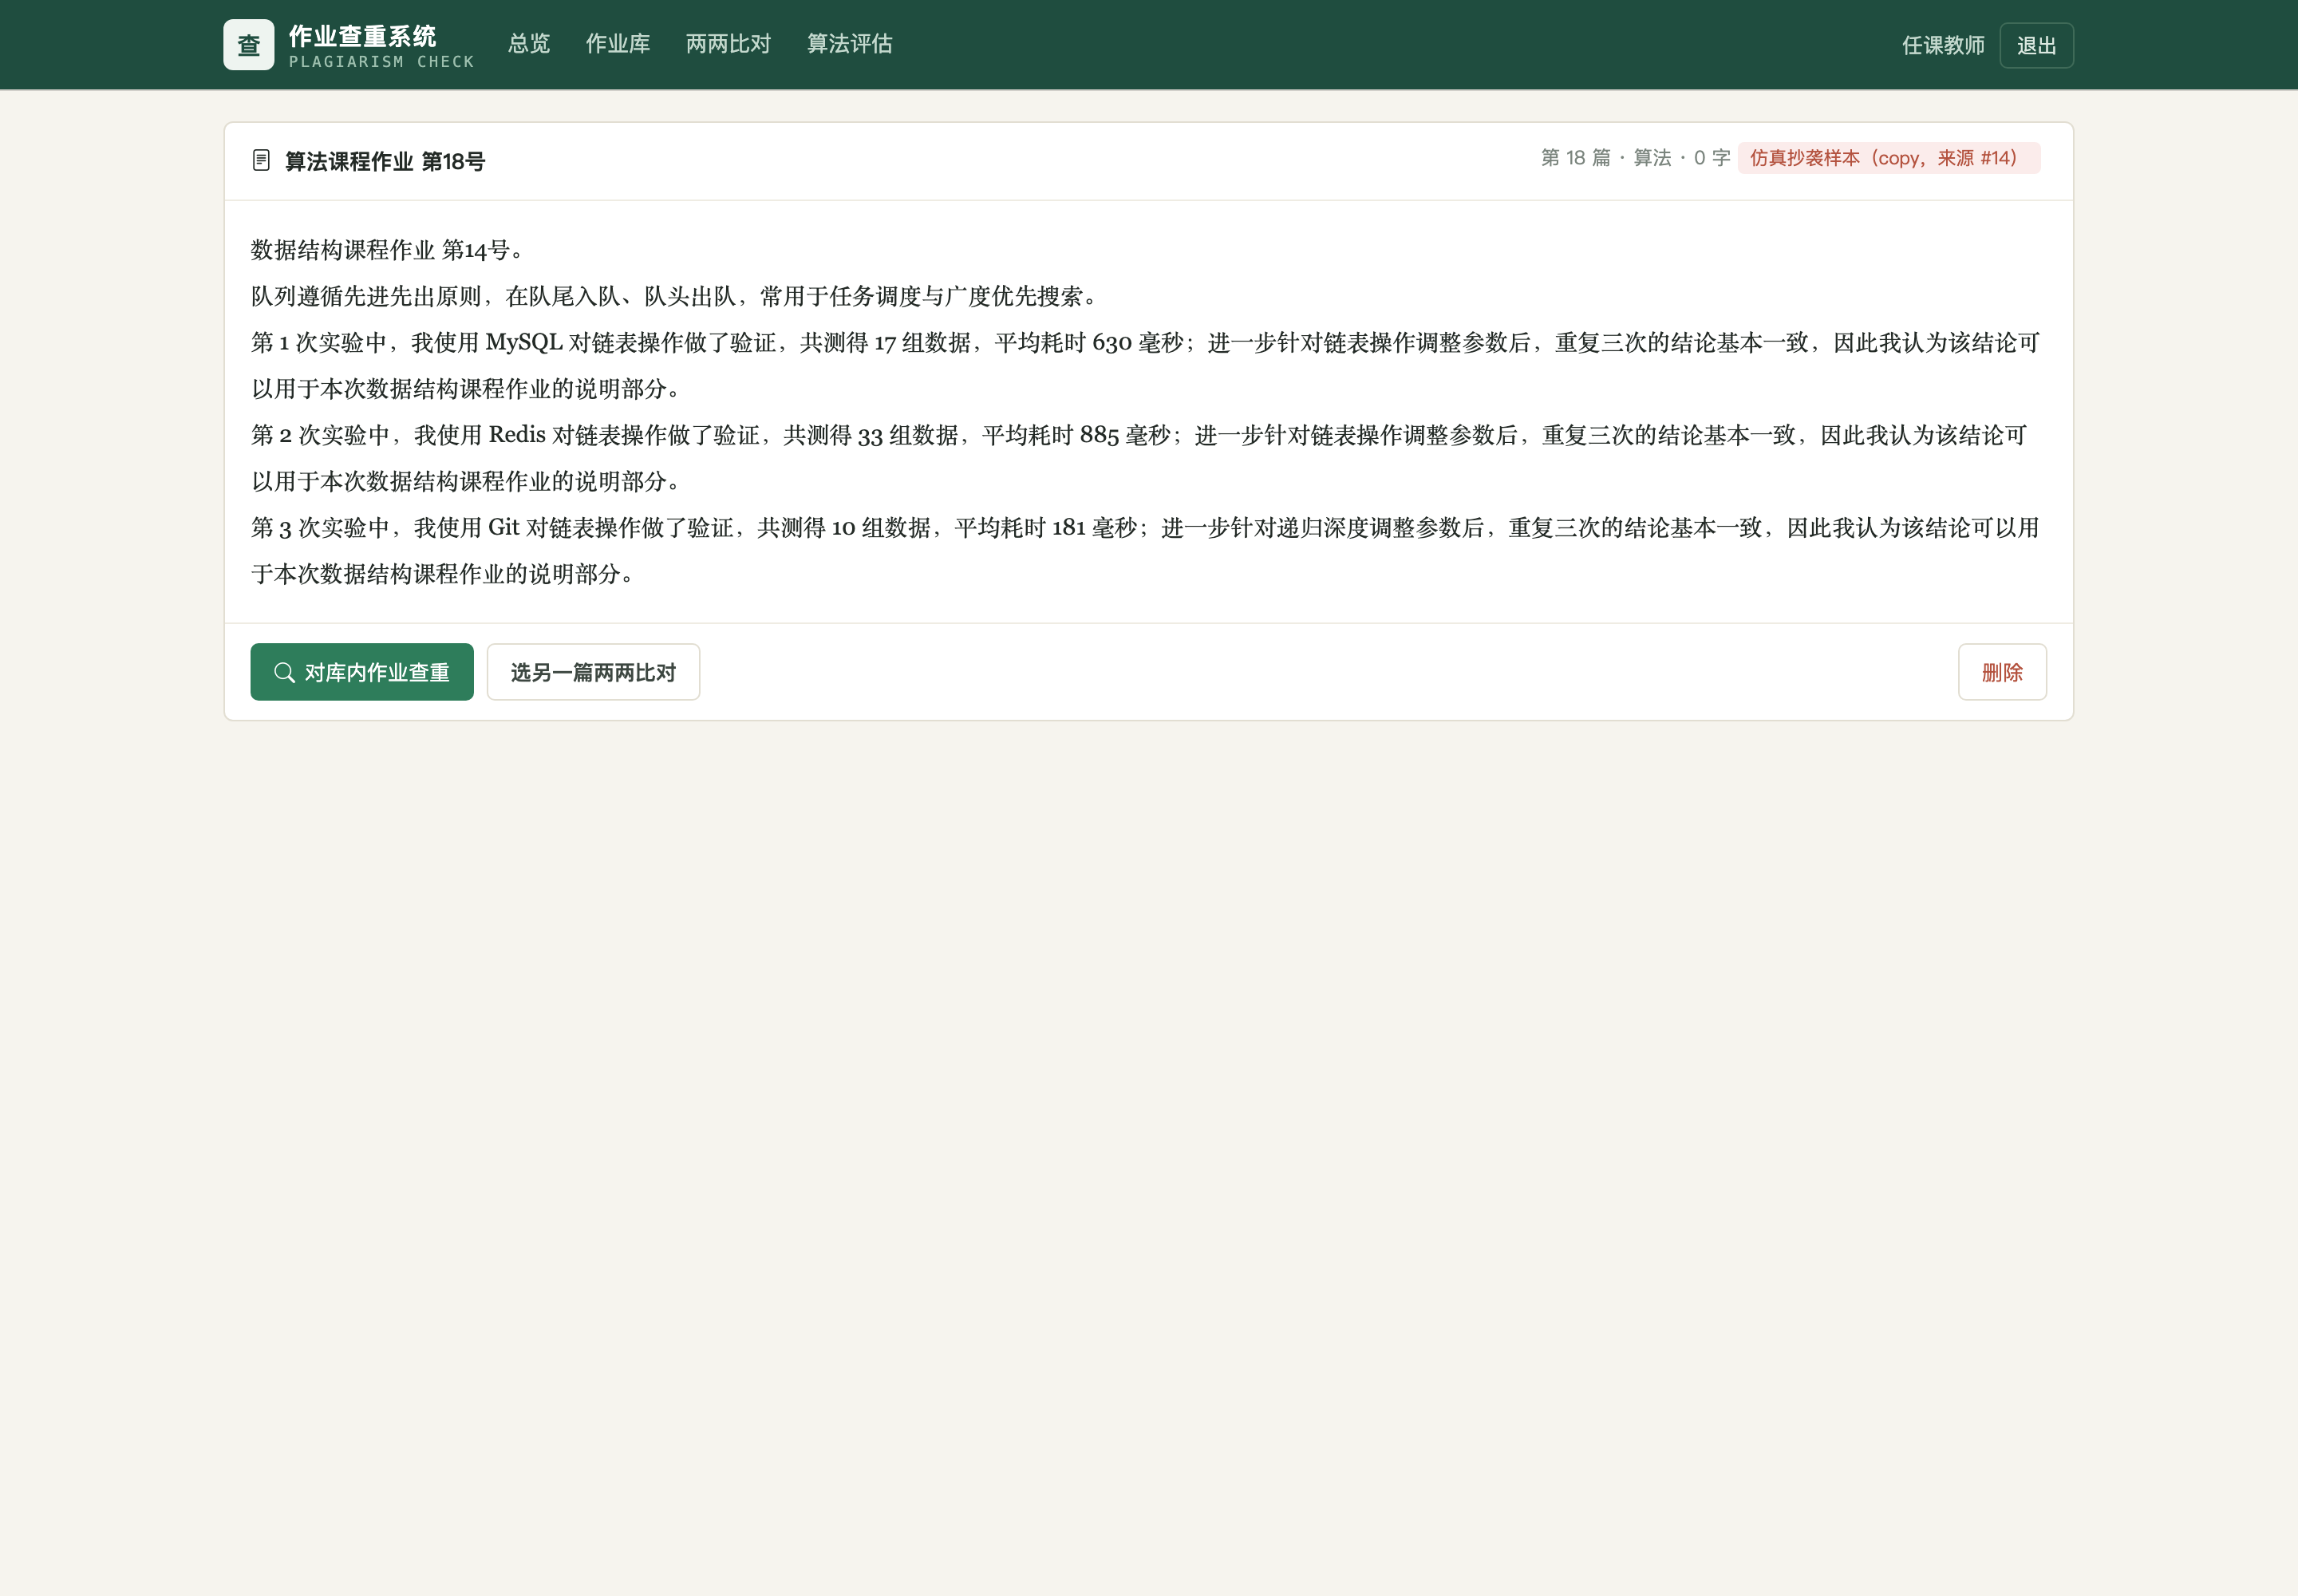
- 带标注仿真语料与对比实验:80 篇作业 / 32 篇抄袭样本 / 90 组配对,四种指标的区分度与阈值网格 P/R/F1 全部可复现
- SimHash 候选筛选取舍量化:汉明距离 ≤4 召回 0.875 正样本、仅放行 1.7% 负样本(≤6 为 0.906 / 6.9%)
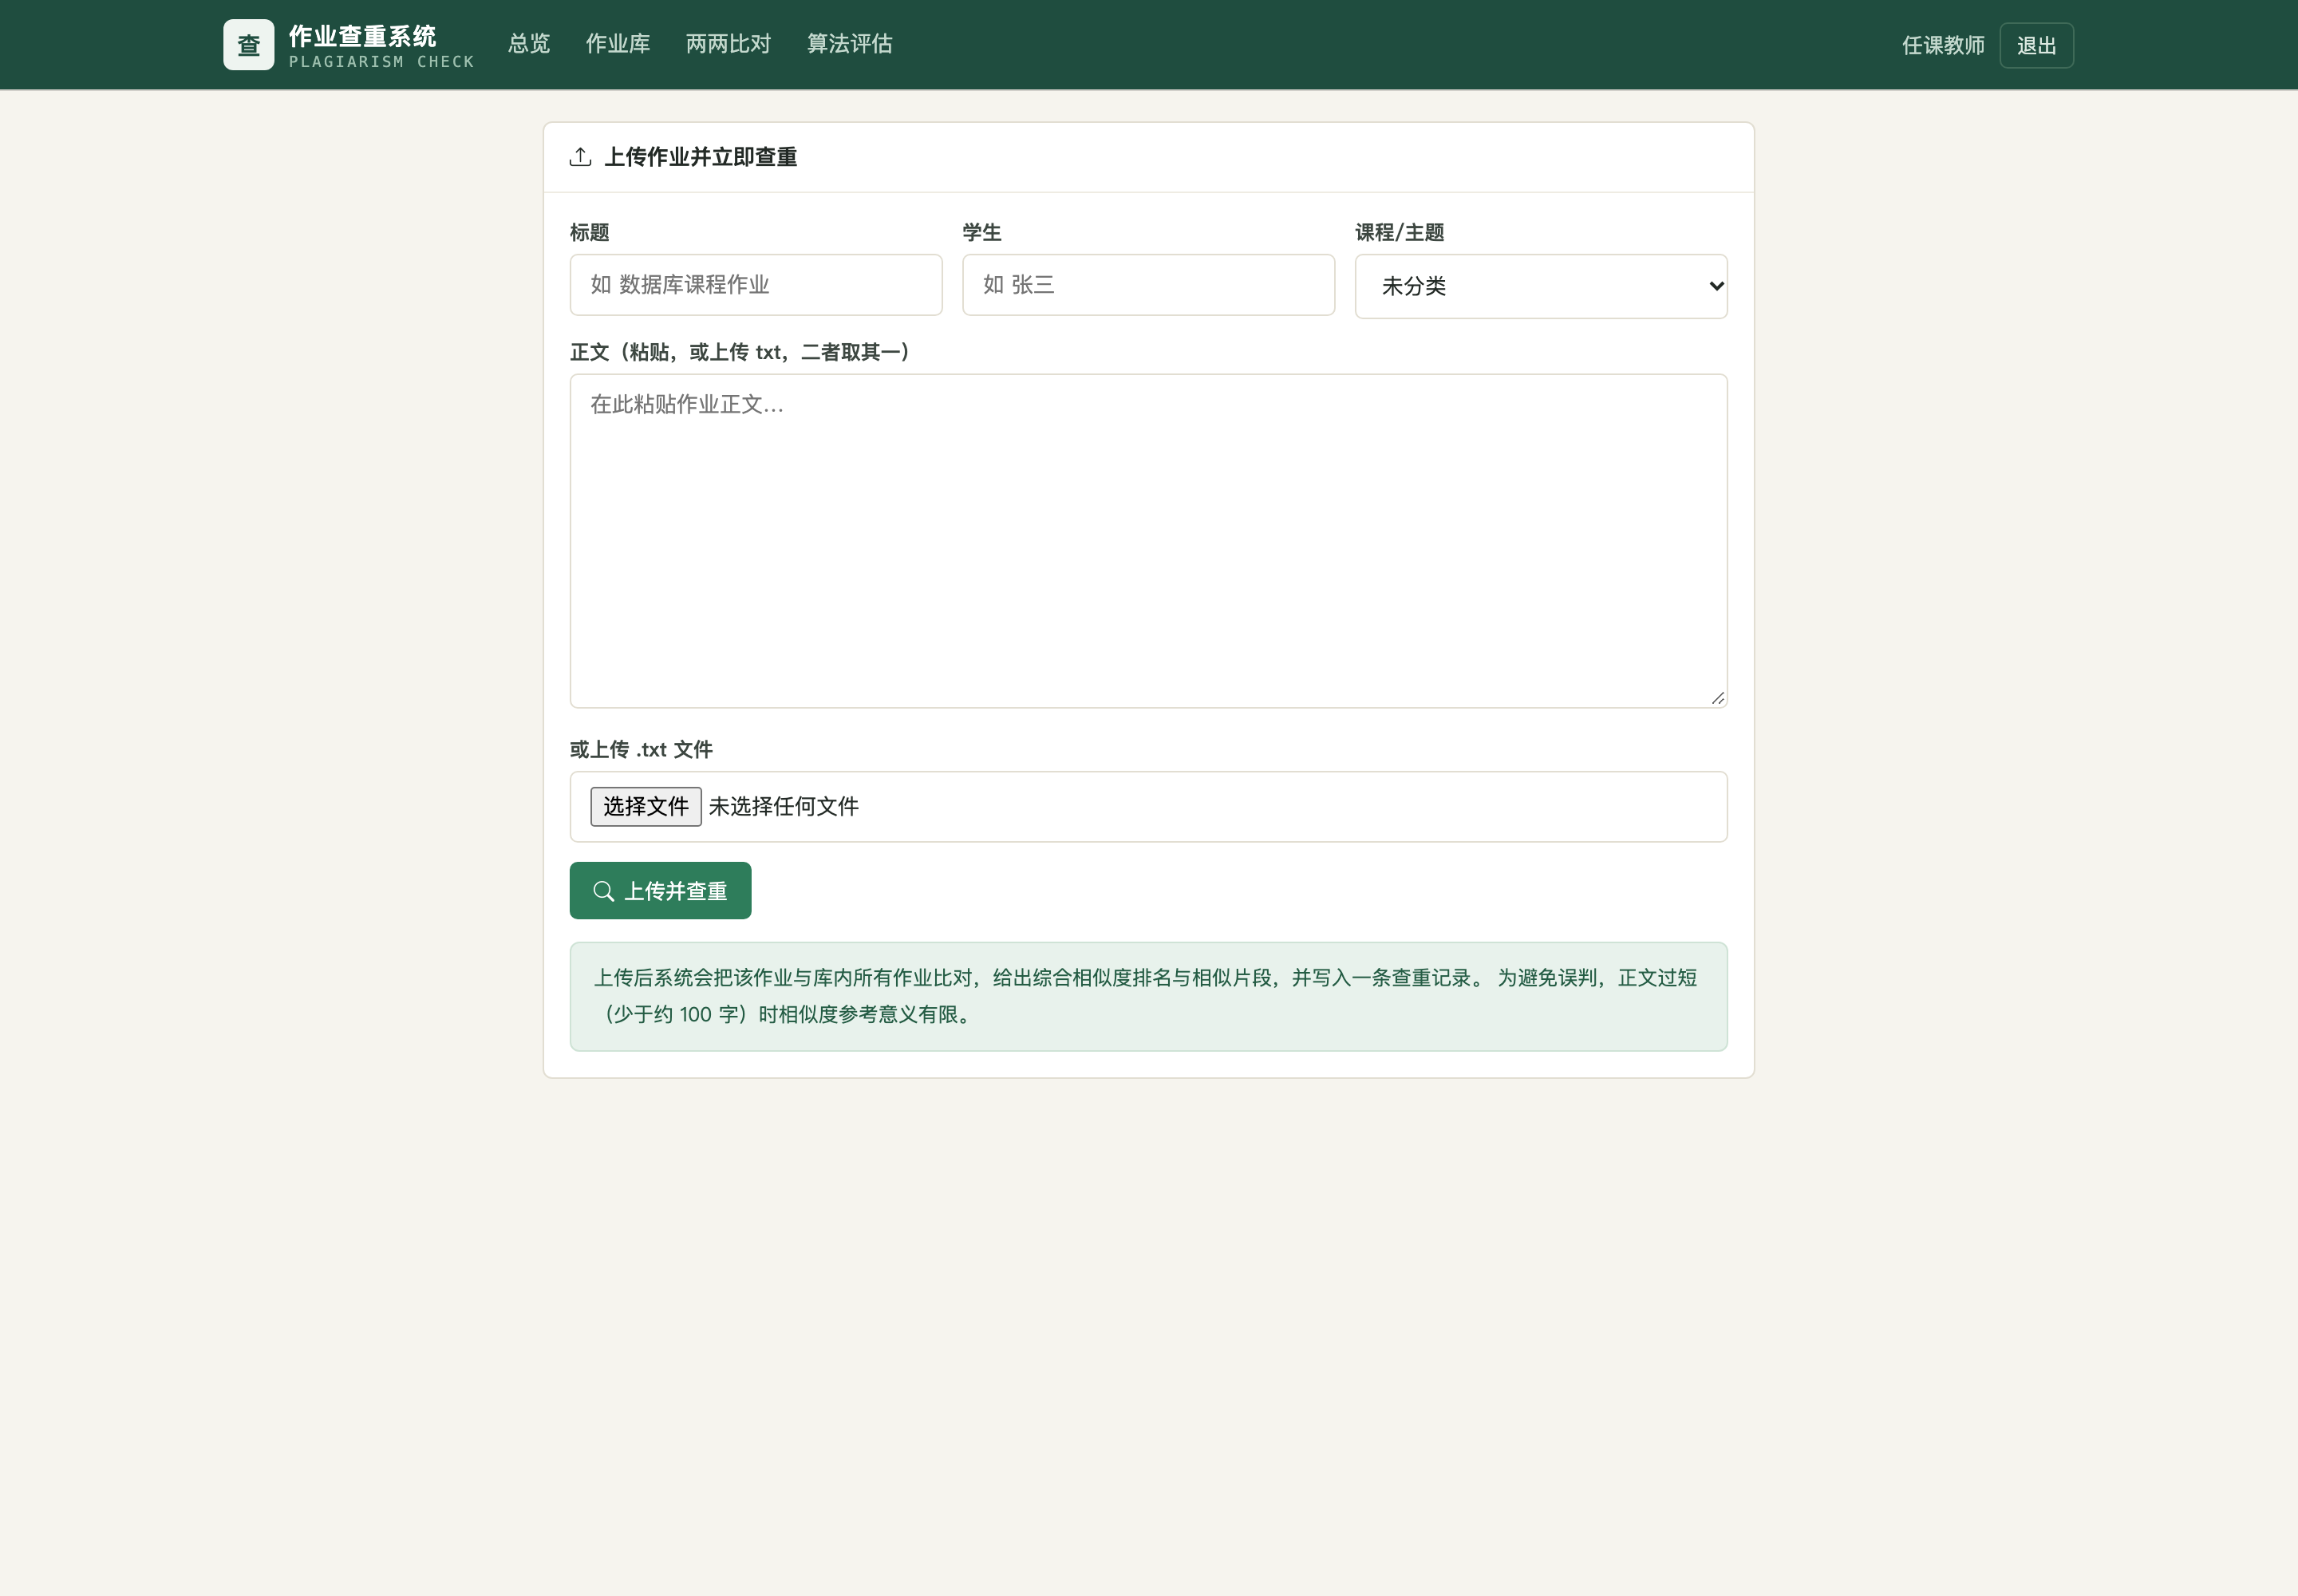
- 上传解析:粘贴文本或上传 txt,自动识别 UTF-8 / GBK / UTF-16 编码
- 工程实现:全库分词/指纹/TF-IDF 进程内缓存(按作业数自动失效重建),单次查重毫秒级
- 算法评估页:区分度对比、阈值—P/R/F1 曲线、候选筛选取舍三张图,数字直接读自评估脚本输出
交付内容
- 完整源码(Django 工程 + 自行实现的相似度算法 + 仿真语料生成器 + 离线评估脚本)
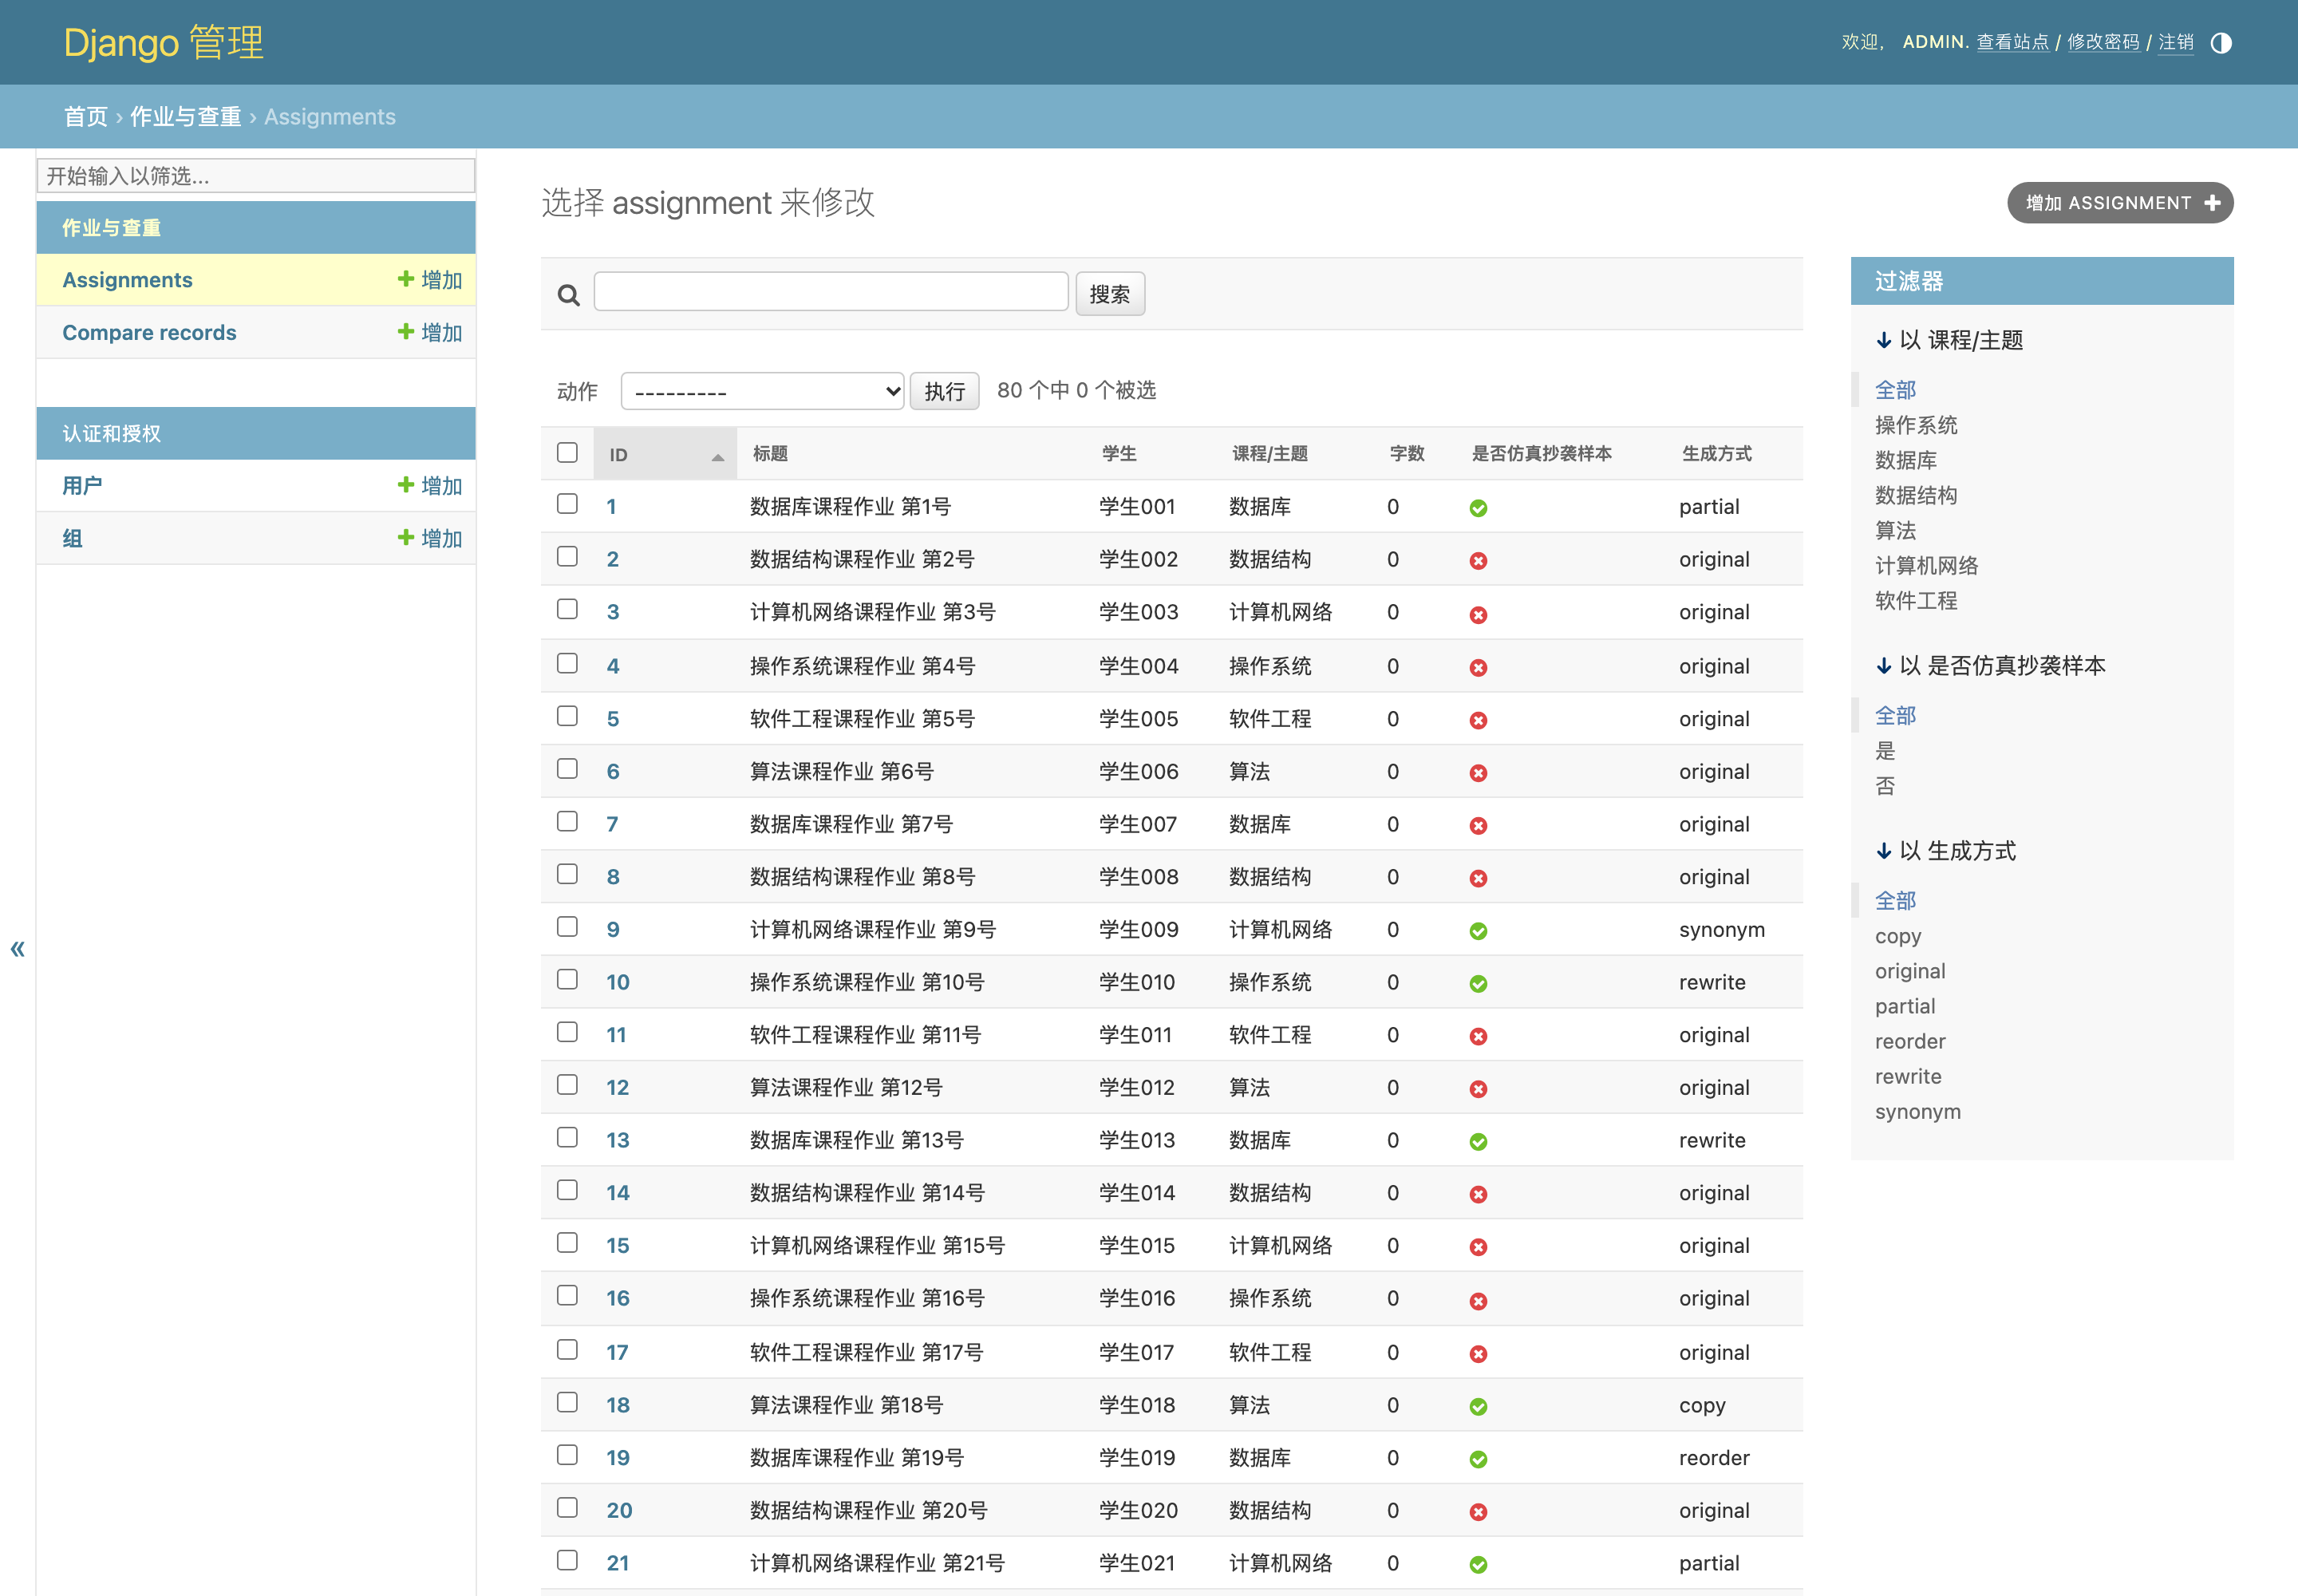
- 演示数据库(80 篇仿真作业,含 32 篇带标注抄袭样本)与评估指标文件 metrics.json
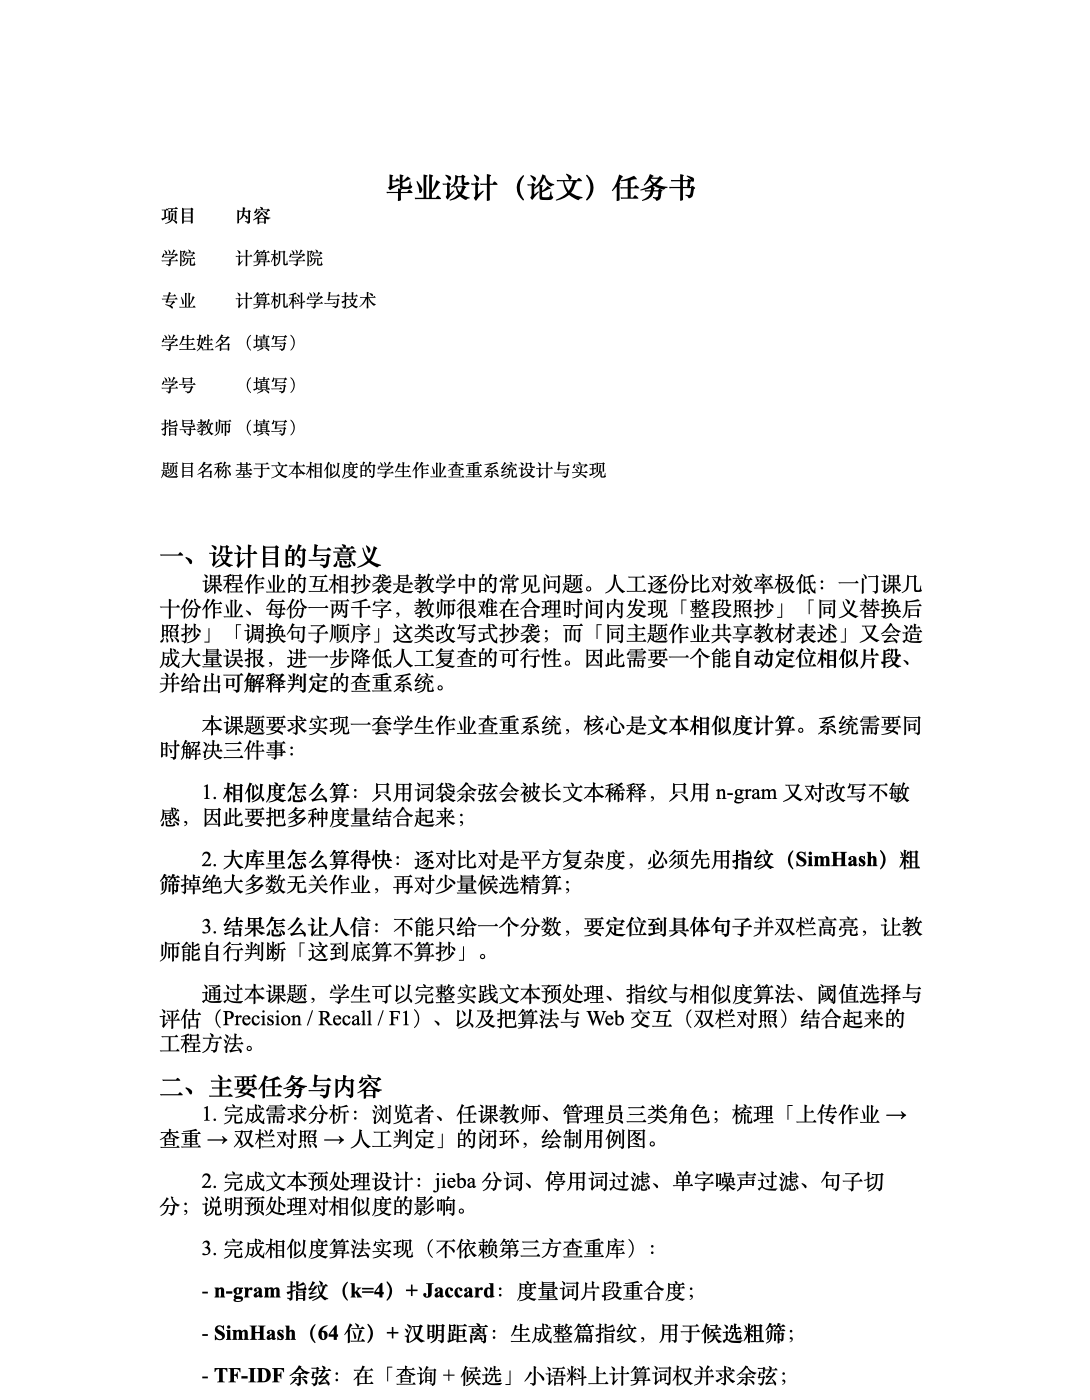
- 毕业设计任务书(Word)
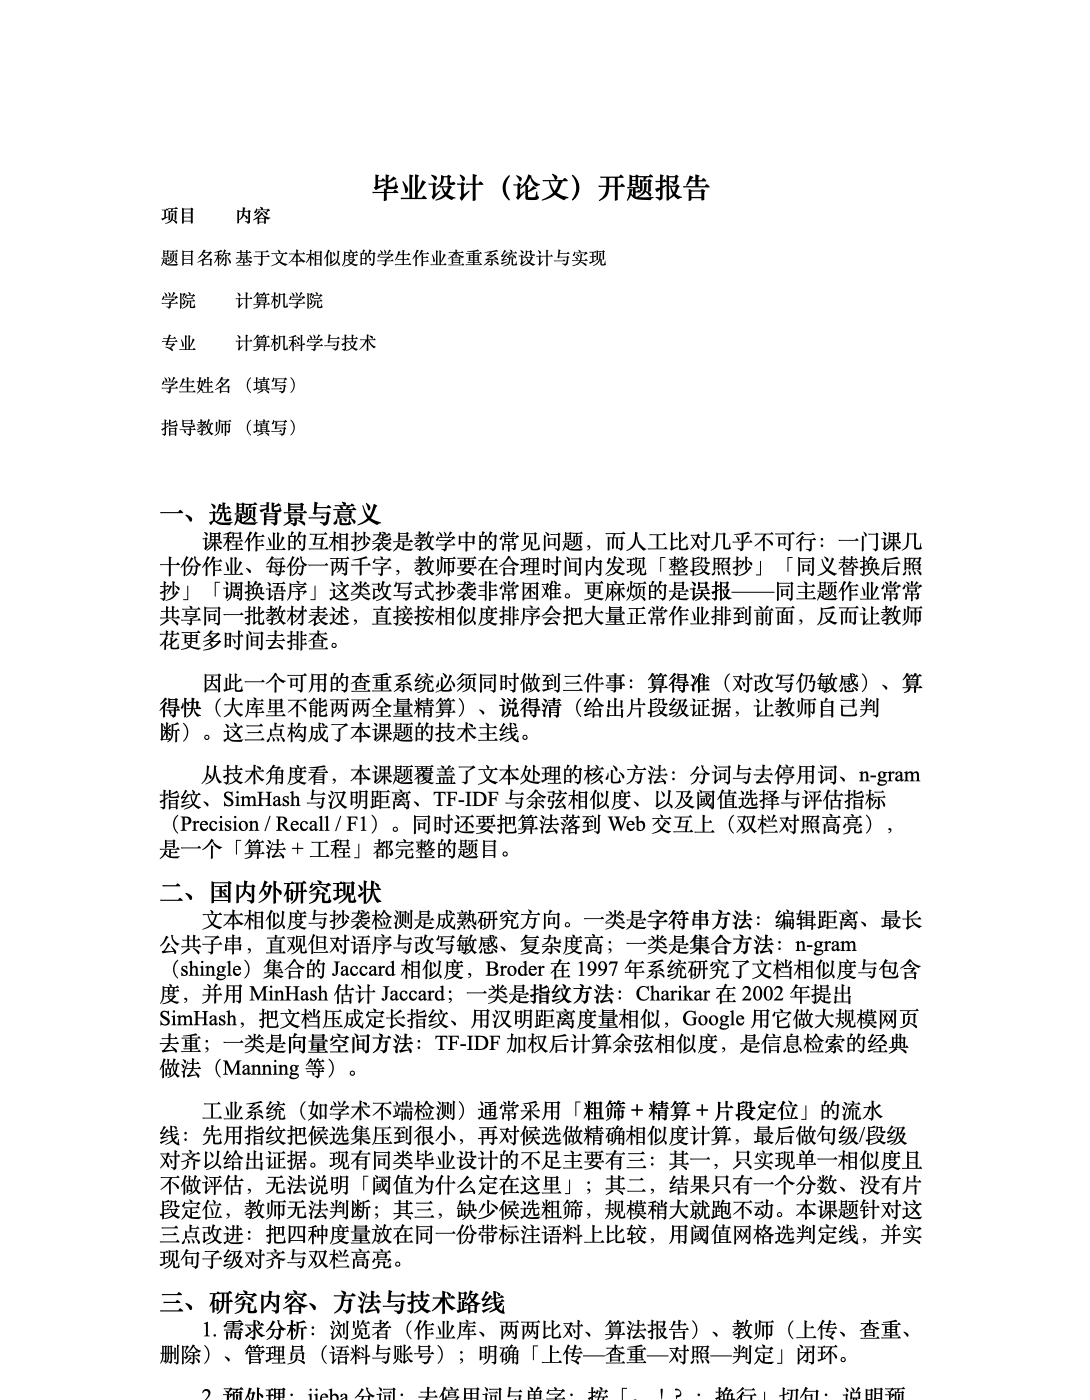
- 开题报告(Word)
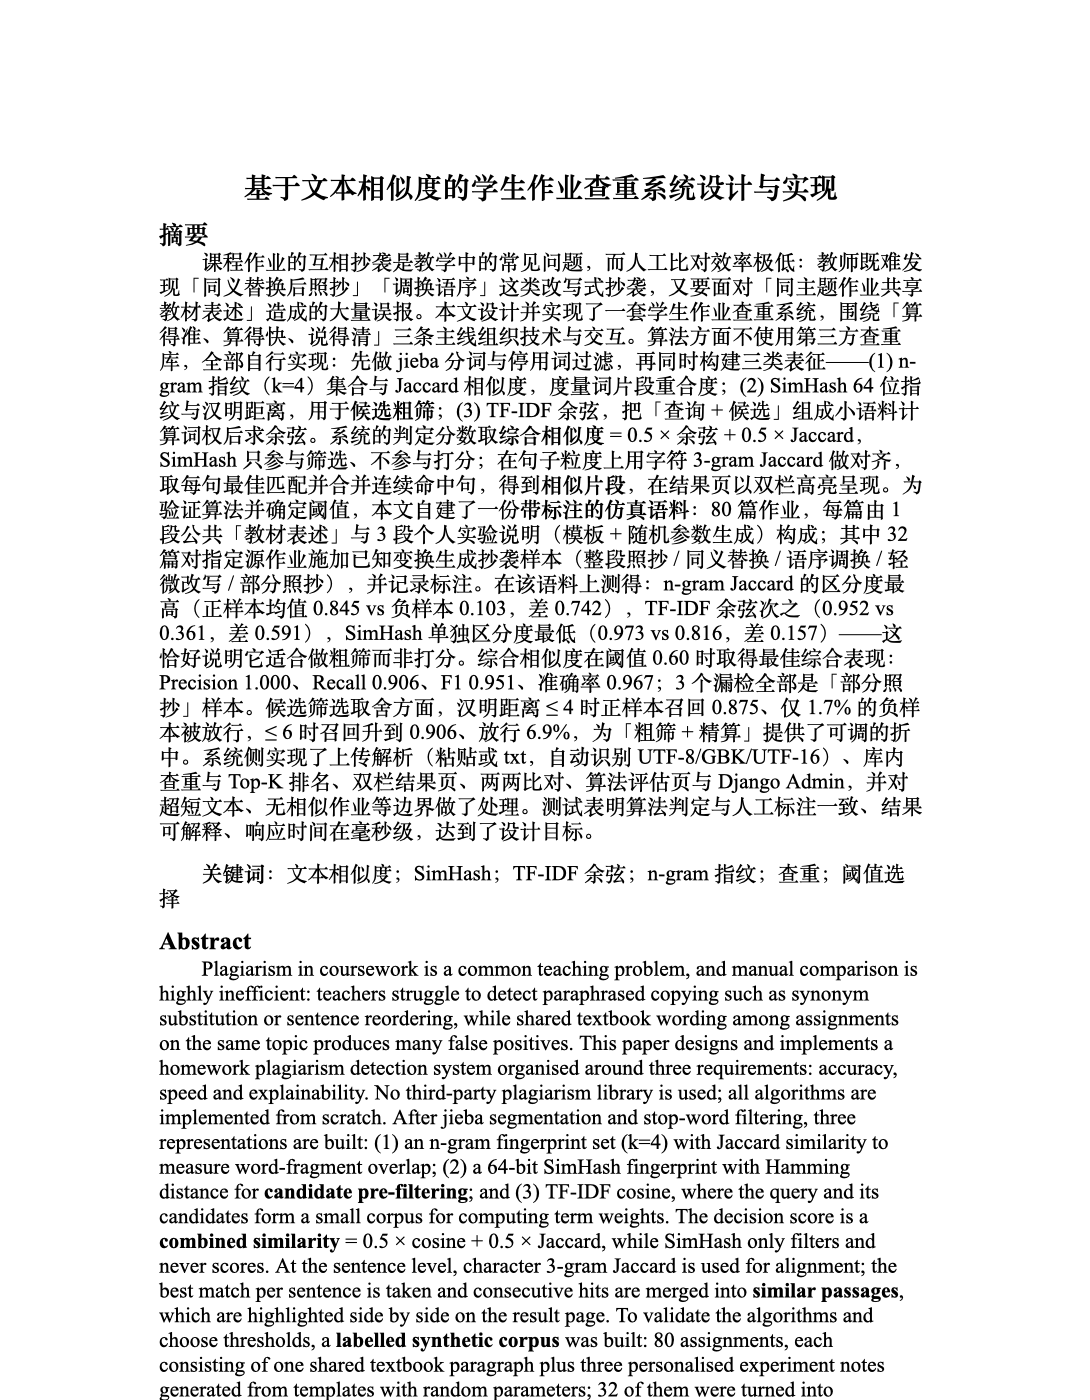
- 毕业论文(Word,七章制,含评估实验与阈值选择章节)
- 系统使用与二次开发说明(Word + md)
- 11 张系统运行截图
最终成品目录结构
下面是交付包里的真实目录,共 64 个文件。只展示文件名,不含文件内容; 点击文件夹可逐层展开,看到每个模块是怎么拆分的。
界面截图
点击任意一张可放大,支持左右切换(也可用键盘 ← → 键)
文档预览
交付的任务书、开题报告与论文均为 Word 文档,下面是真实页面预览;点击可放大并左右切换:
常见问题
查重准确率怎么样?
在带标注仿真语料(80 篇 / 90 组配对)上,综合相似度阈值 0.60 时 Precision 1.000、Recall 0.906、F1 0.951、准确率 0.967;3 个漏检全部是「部分照抄」样本。
判定阈值 0.6 是怎么来的?
在 0.20–0.90(步长 0.05)的阈值网格上做搜索,取综合相似度 F1 与准确率最优的阈值。实验里综合相似度在 0.60 就达到最佳 F1 0.951,而单独用余弦要等到 0.90 才达标,阈值越低对真实改写越宽容。
为什么还要用 SimHash?
SimHash 单独打分的区分度只有 0.157(正样本均值 0.973 / 负样本 0.816),不适合判定;但它适合粗筛——汉明距离 ≤4 能召回 87.5% 的抄袭样本,却只放行 1.7% 的正常作业,可以把精算量压缩一个数量级。
结果只有一个分数吗?
不是。结果页给出四个分项(TF-IDF 余弦、n-gram Jaccard、SimHash 相似度、汉明距离)与相似片段数与字数,并用双栏高亮定位到具体句子,鼠标悬停可看该句的最佳匹配分数。
改写的抄袭能查出来吗?
同义替换、语序调换、轻微改写都能识别(Jaccard 对成段重合敏感、余弦对词权分布敏感);但「部分照抄」和深度语义改写是整篇相似度方法的固有短板,论文 7.2 给出了改进方向(段落级局部相似度、句向量语义匹配)。
能换语料或课程吗?
能。上传页支持粘贴文本或上传 txt(自动识别 UTF-8/GBK/UTF-16);也可以在 similarity/corpus.py 换掉知识段落池并重跑 seed_corpus 与 run_eval。
评估数据是真实的吗?
不是。语料是**仿真数据**:知识段落自撰,作业与抄袭样本由脚本按已知变换生成并记录标注,固定种子可复现,**不含任何真实学生作业**,仅用于算法评估与演示。
查重快吗?
80 篇库下单次查重(含 TF-IDF 与片段定位)在毫秒级;全量评估(90 组配对、4 指标、15 档阈值)耗时 0.8 秒。